はじめに: AIによる分析の品質は、データから始まる
AI エージェントの進化によって、データ分析の世界は大きく変わり始めています。
以前であれば、データを分析してチャートを作り、ダッシュボードやレポートにまとめるためには、専門的な知識や多くの時間が必要でした。
しかし今では、AI エージェントに自然言語で指示するだけで、データの集計や分析、チャートやダッシュボードの作成、さらには分析結果をまとめたレポートの生成まで、比較的簡単にできるようになってきました。
しかし、AIがどれほど優秀でも、元のデータが整っていなければ、正しい結果は得られません。データの意味が伝わっていなければ、エージェントは質問を意図とは違う形で解釈します。必要なデータの取得に無駄があれば、時間もトークンコストも増えていきます。
売上データを例に考えてみましょう。
| 問題 | よくある例 |
|---|---|
| データの品質 | 重複行があり、売上が二重に集計される。地域名の表記ゆれで、同じ地域が別々に集計される |
| 意味の曖昧さ | 「売上」が総売上なのか純売上なのか、列名だけでは分からない |
| 取得の非効率 | 質問のたびに全データを取得し、時間とトークンを消費する |
| 管理とプライバシー | 誰がどのようにデータへアクセスしたのか分からない。そもそもサーバーに上げられないデータがある |
こうした問題は、エージェントが高度な分析を行えるようになっても、自動的に解決されるわけではありません。
逆に言えば、たとえ時間がかかったとしても、ビジネスルールを理解した人間が検証したデータを準備できれば、ダッシュボードやチャートの作成、データに関する質問への回答は、今日のAIを使えば比較的簡単です。AIが分析を高速に実行できるようになった今、人が時間をかけるべきなのは、データの準備と定義です。
この問題を解決するために、Exploratory v17.0では「Exploratory データカタログ」をサポートしました。
Exploratory データカタログとは
Exploratory データカタログは、再現可能な加工を経たデータをパブリッシュし、その意味を伝える情報を加えて、AI エージェントからMCP経由で利用できるようにする仕組みです。MCP(Model Context Protocol)は、AI エージェントが外部のデータやツールに接続するための標準的な仕組みです。
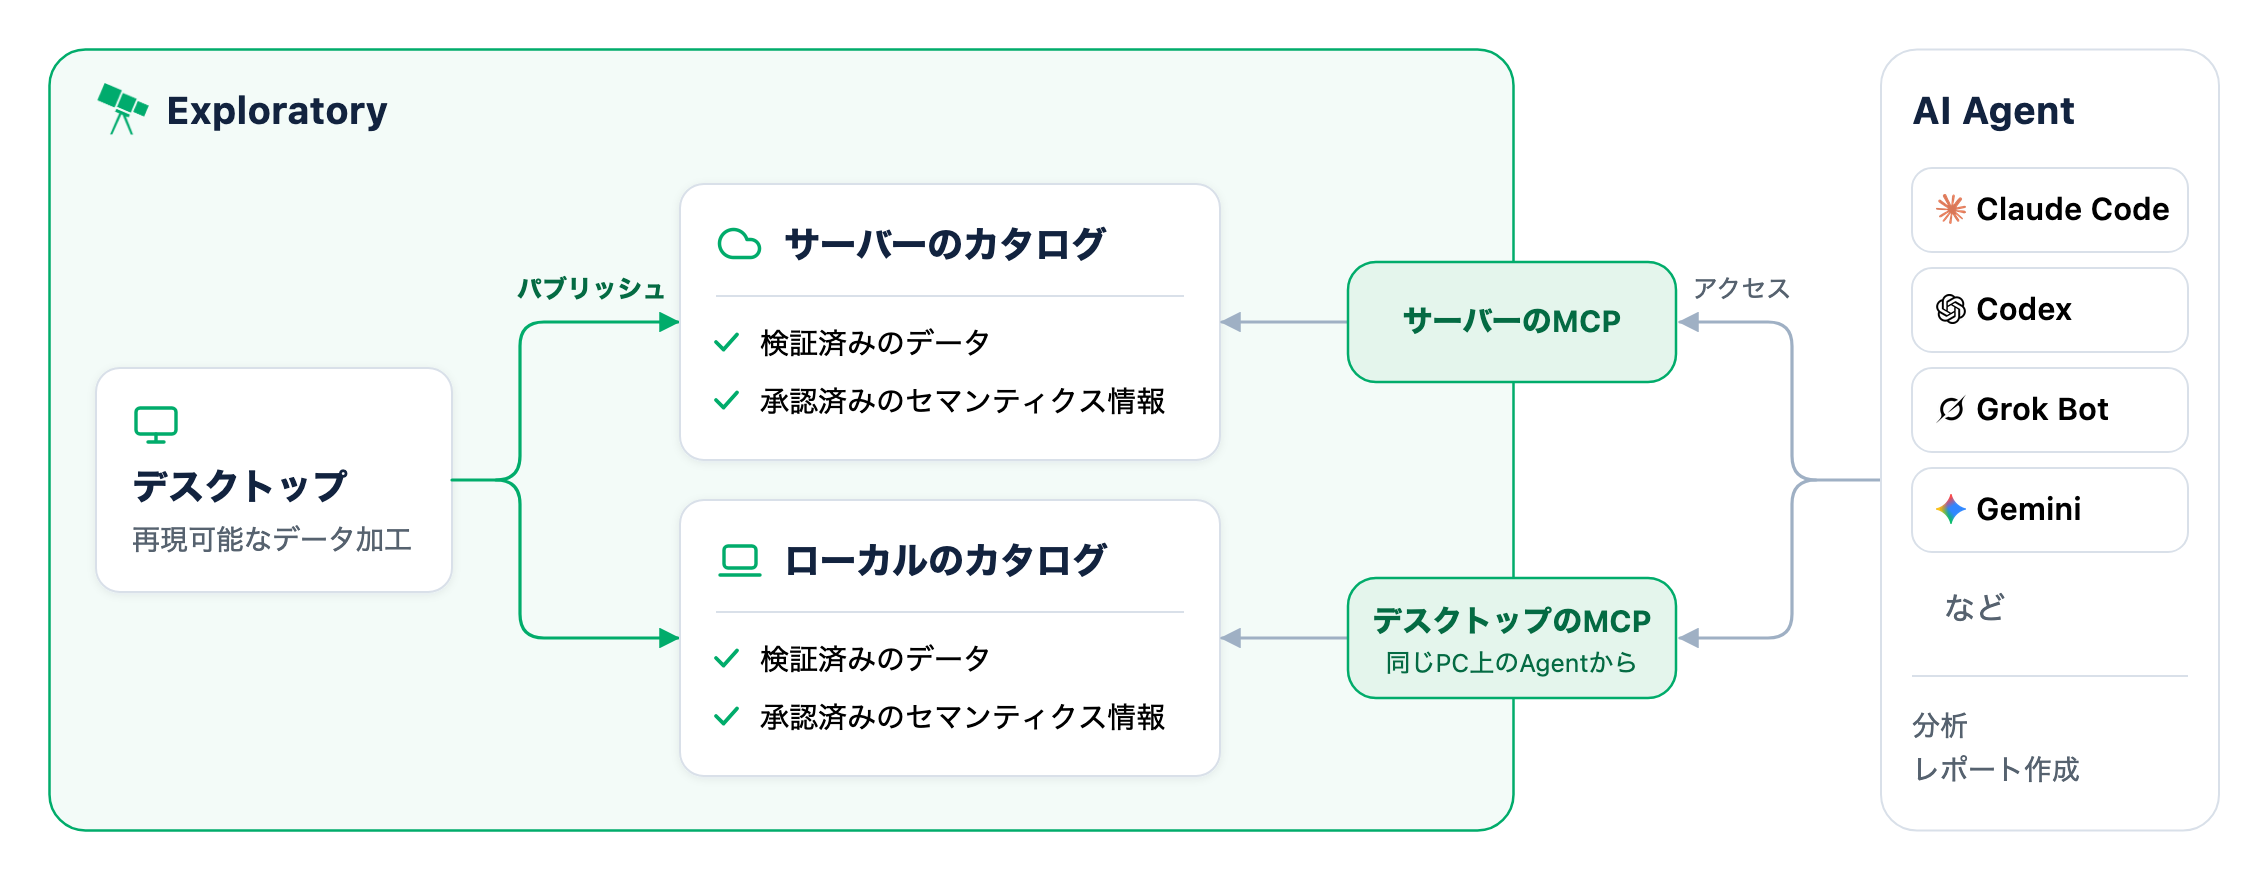
AI エージェントが信頼できるデータを正しく理解し、効率的に利用できるようにするために、次の4つの価値を提供します。
1. 準備 — 信頼できるデータを準備する
再現可能なデータ加工によって、正しく、分析しやすいデータを準備します。
2. 意味づけ — データの意味とビジネスコンテクストを伝える
AI Assisted Semanticと関連ドキュメントによって、AI エージェントがデータの意味やビジネスルールを理解できるようにします。
3. アクセス — 必要なデータだけを高速に取得する
MCP、柔軟なクエリを使って、AI エージェントが必要なデータを必要なときに効率的に取得できるようにします。
4. 管理 — データへのアクセスを管理・監視する
アクセス権限の管理やアクセスログによって、AI エージェントによるデータ利用を可視化し、コントロールできるようにします。
データはサーバーまたはローカルのカタログにパブリッシュし、それぞれのMCPを経由してエージェントから利用します。
この記事では、売上データに対する「2026年の地域別の純売上は?」という質問を例に、この4つを順番に説明します。
準備: 信頼できるデータを準備する
データのクリーニングや指標の計算を、毎回エージェントに任せていると、結果が変わる可能性があり、検証も難しくなります。そこで、人が事前に確認・検証したデータをエージェントに渡します。
再現可能なデータ加工
Exploratoryでは、データの取得から、欠損値の処理、重複の除去、データの結合、名寄せ、新しい指標の計算まで、さまざまなデータ加工を行うことができます。
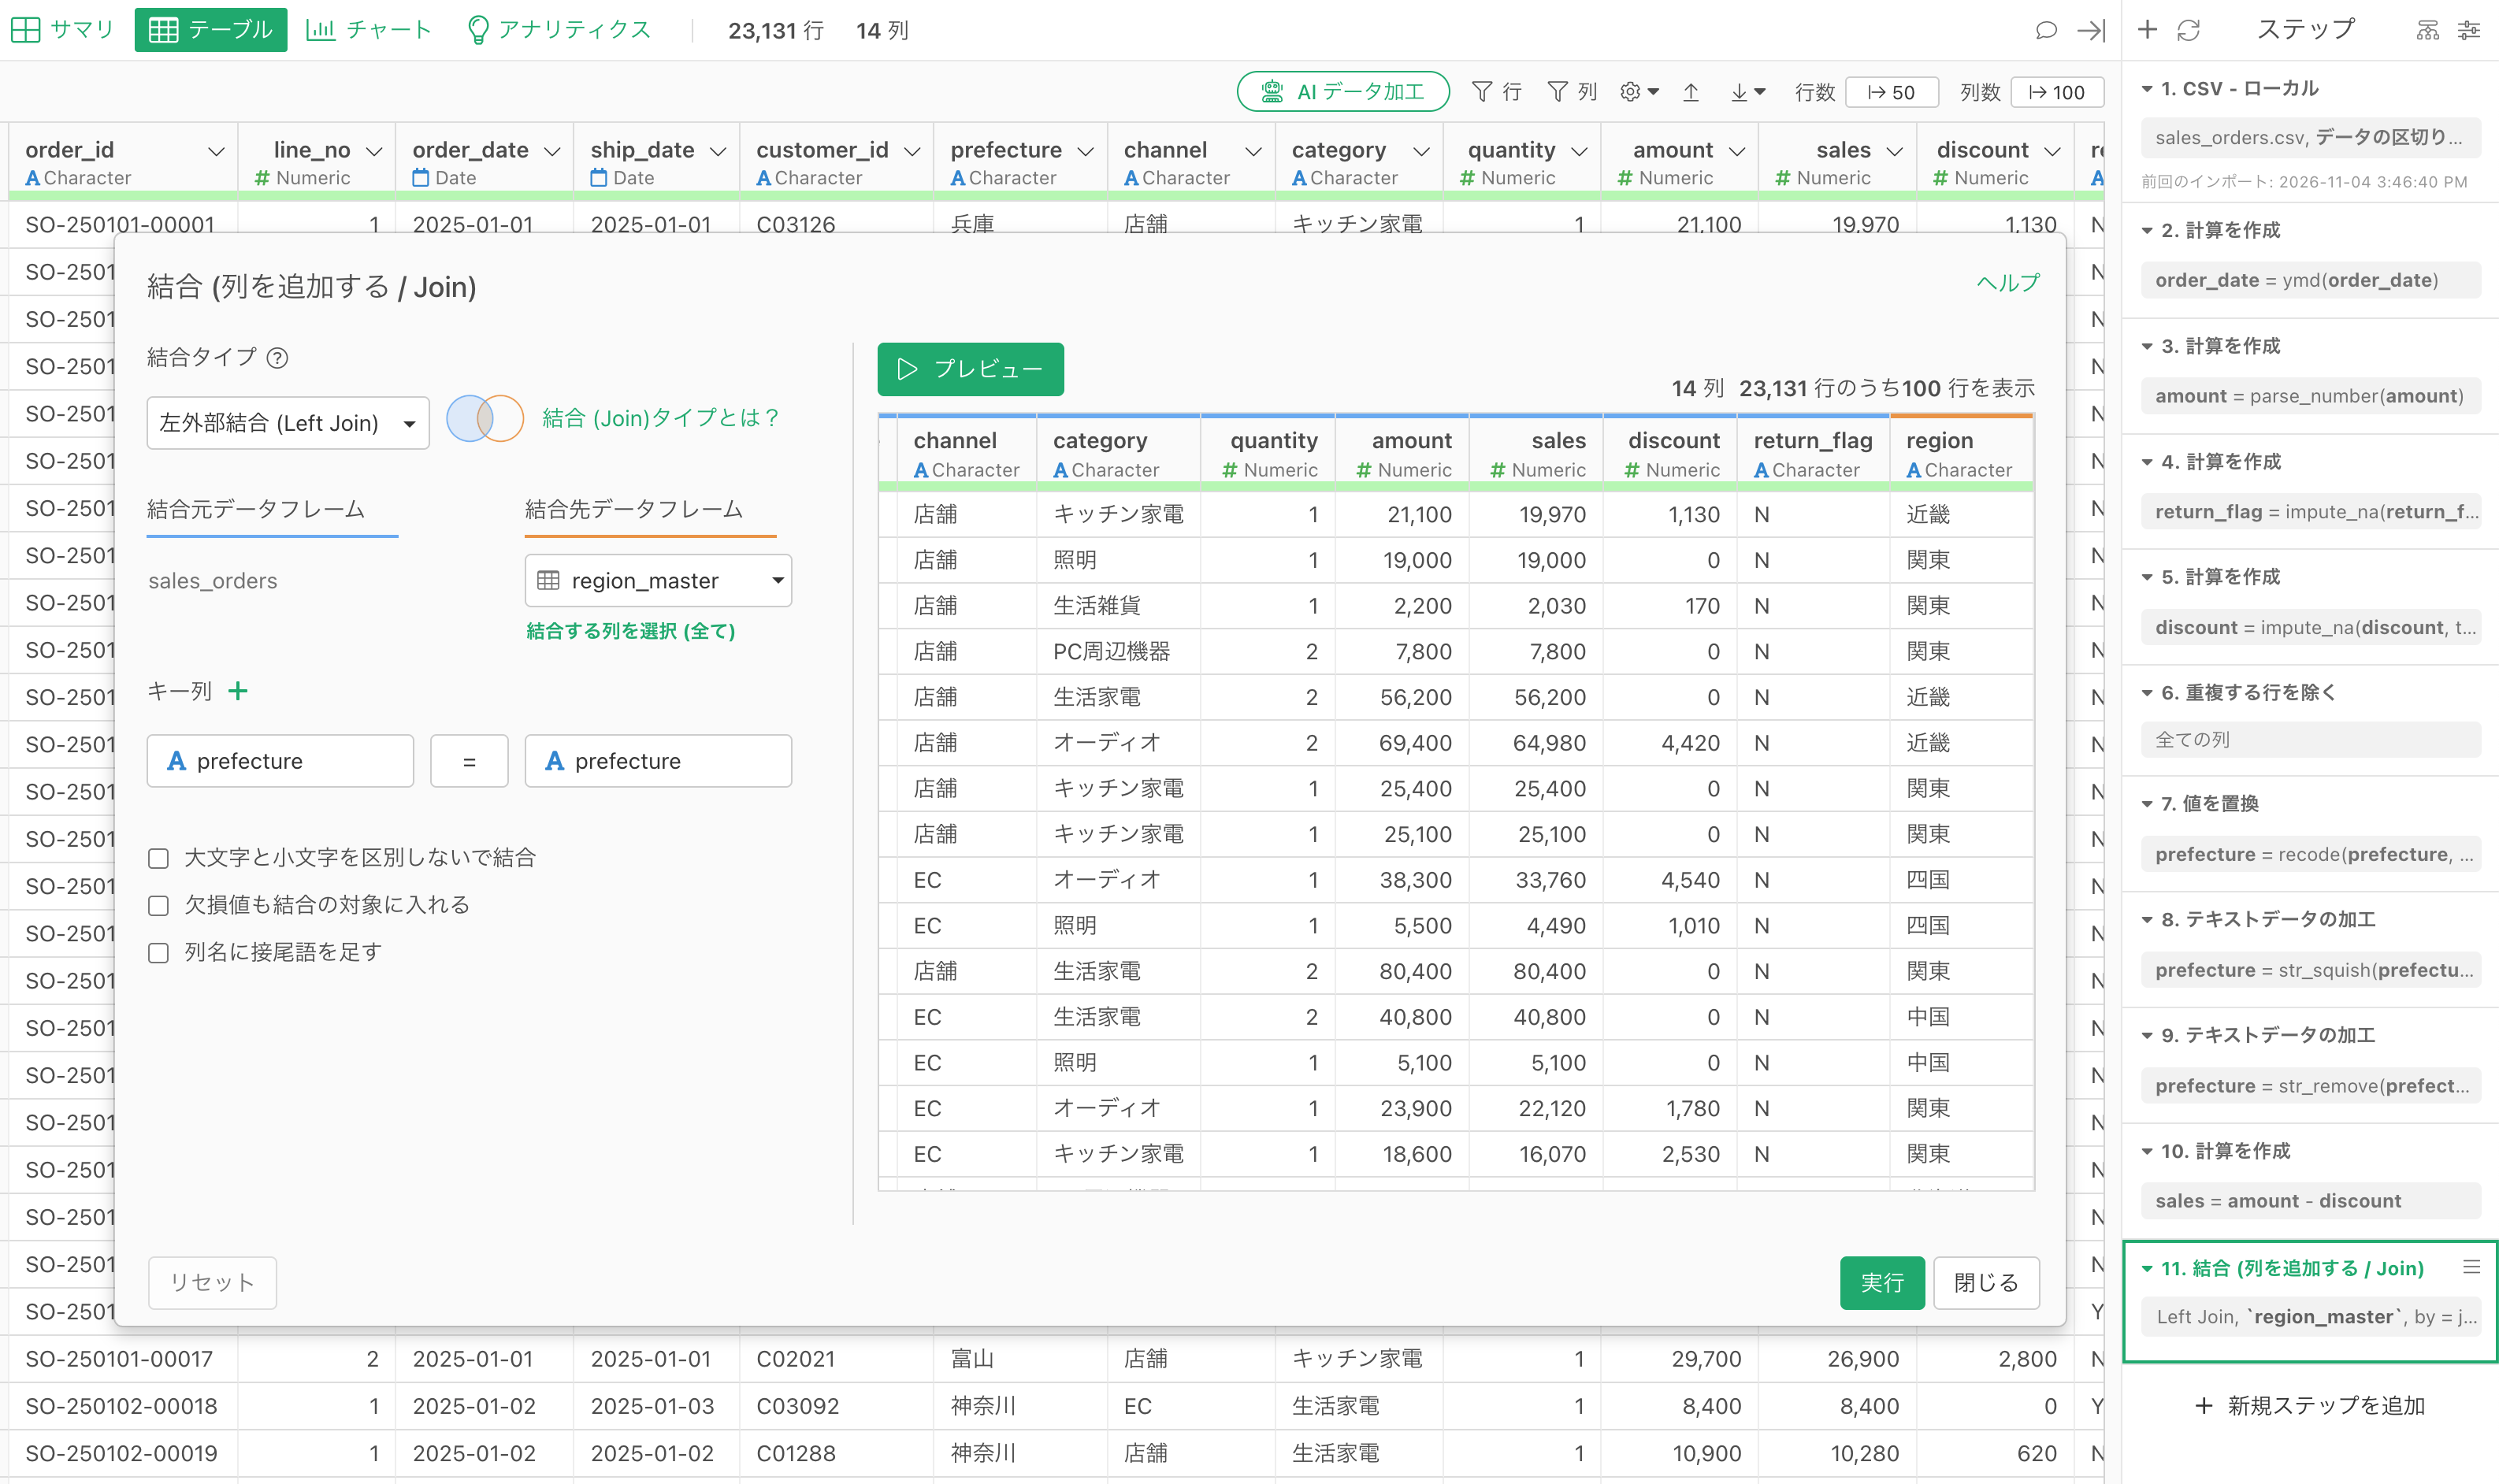
例えば、売上データであれば、注文の重複を除去し、キャンセルされた注文を適切に処理し、返品や割引を反映させた「純売上」を計算しておくことができます。
ここで重要なのは、こうした処理を毎回AI エージェントに任せるのではなく、人間がビジネスルールに従ってデータを加工し、その結果を確認・検証できることです。
Exploratoryでは、データ加工の各処理が右側にステップとして保存されます。
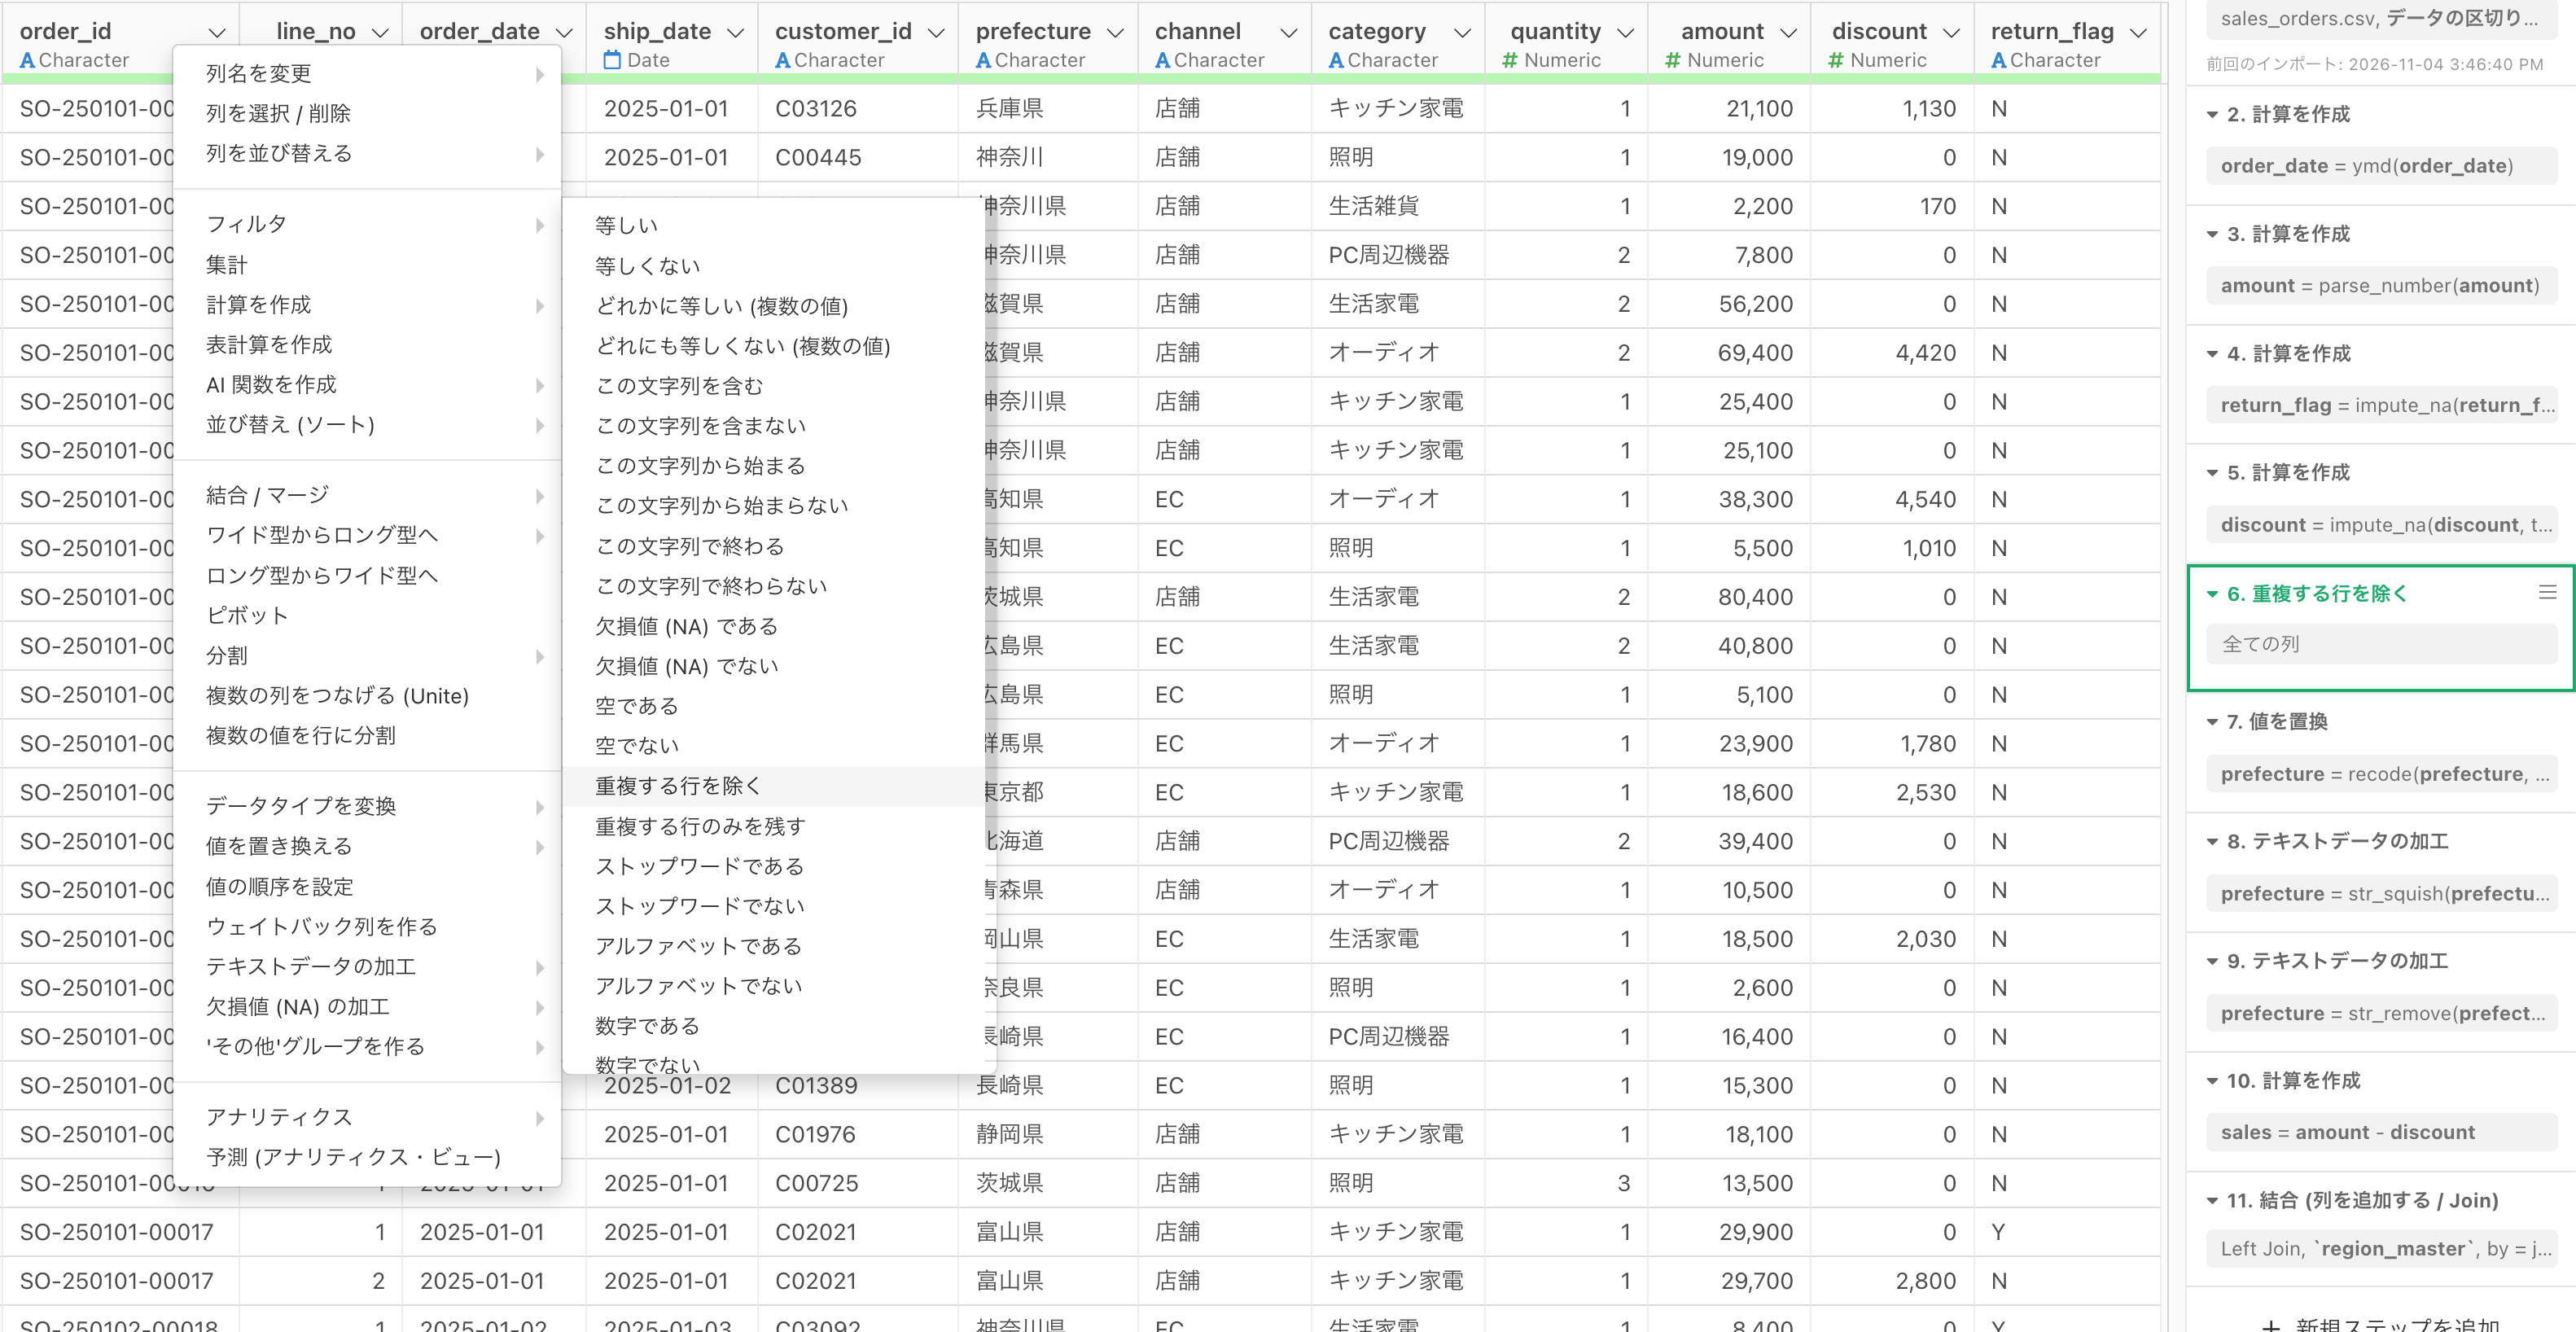
さらに、そうしたデータ加工のステップをダイアグラムとして表示し、どのようにデータが用意されたのか、その過程を可視化することができます。
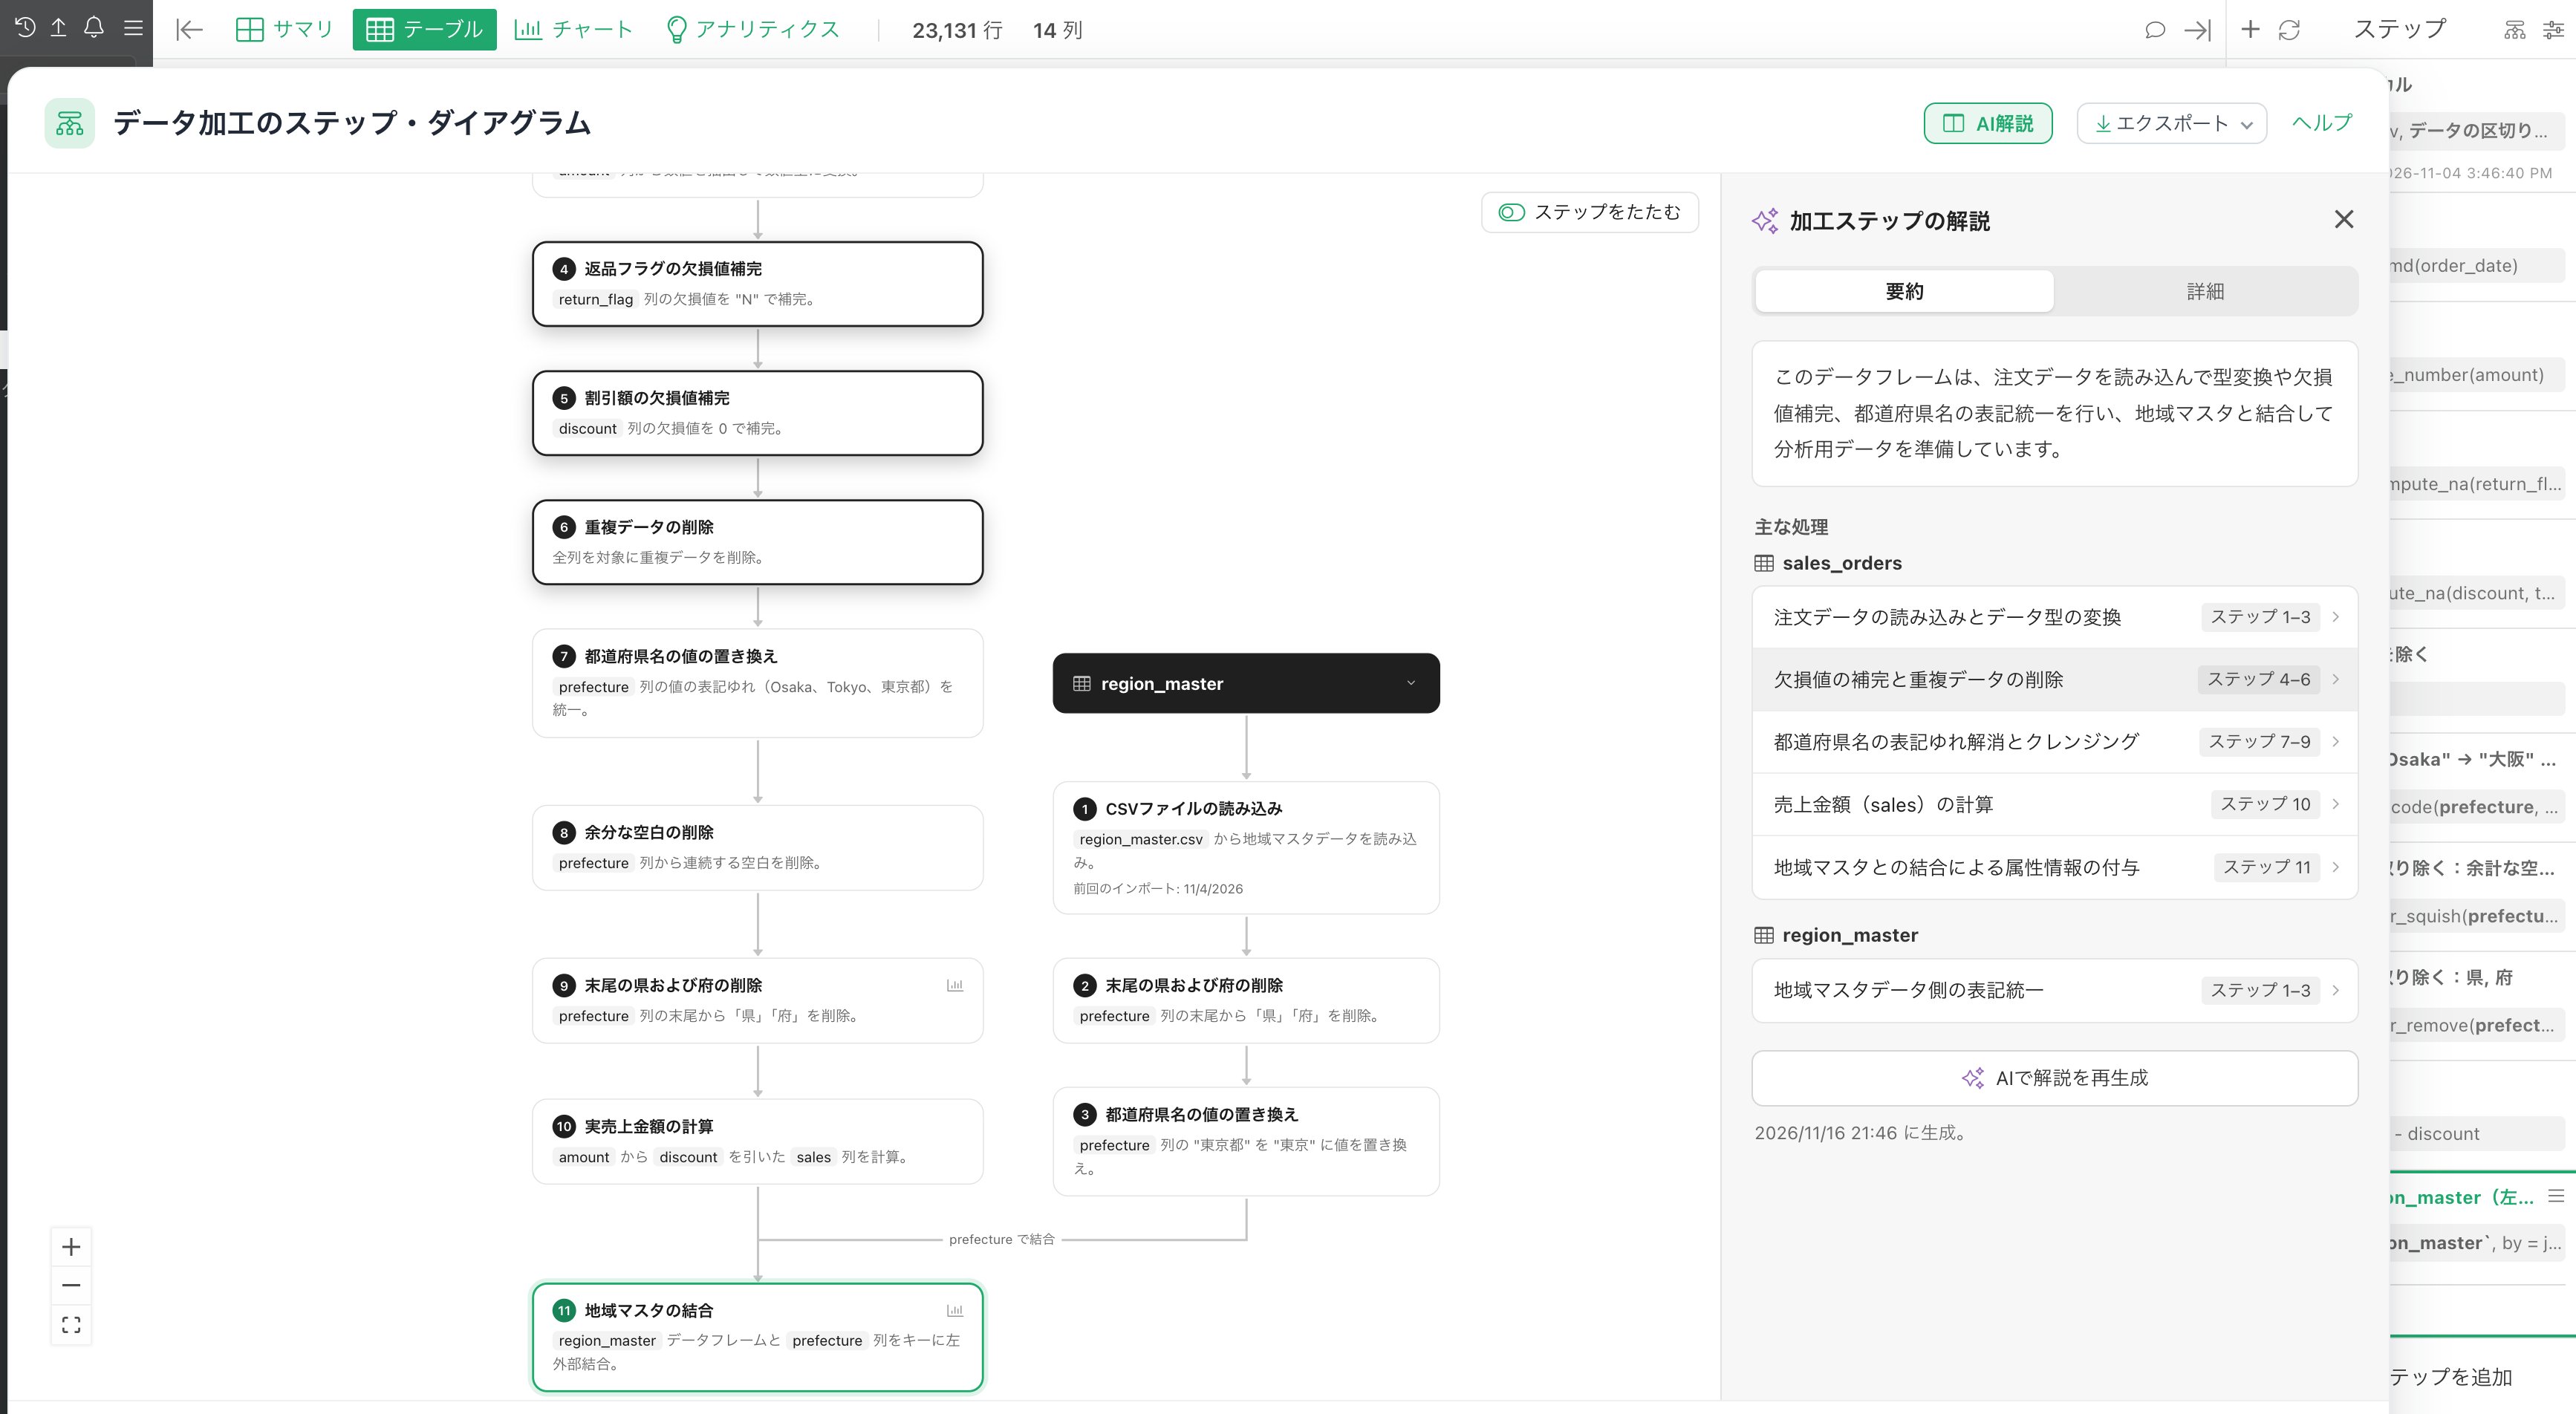
そのため、どのような処理を行ったのかを後から確認したり、必要に応じて修正したり、同じ処理を再実行したりできます。
こうして準備されたデータをローカルまたはサーバーのデータカタログにパブリッシュすることで、AI エージェントは検証済みのデータを繰り返し利用できるようになります。
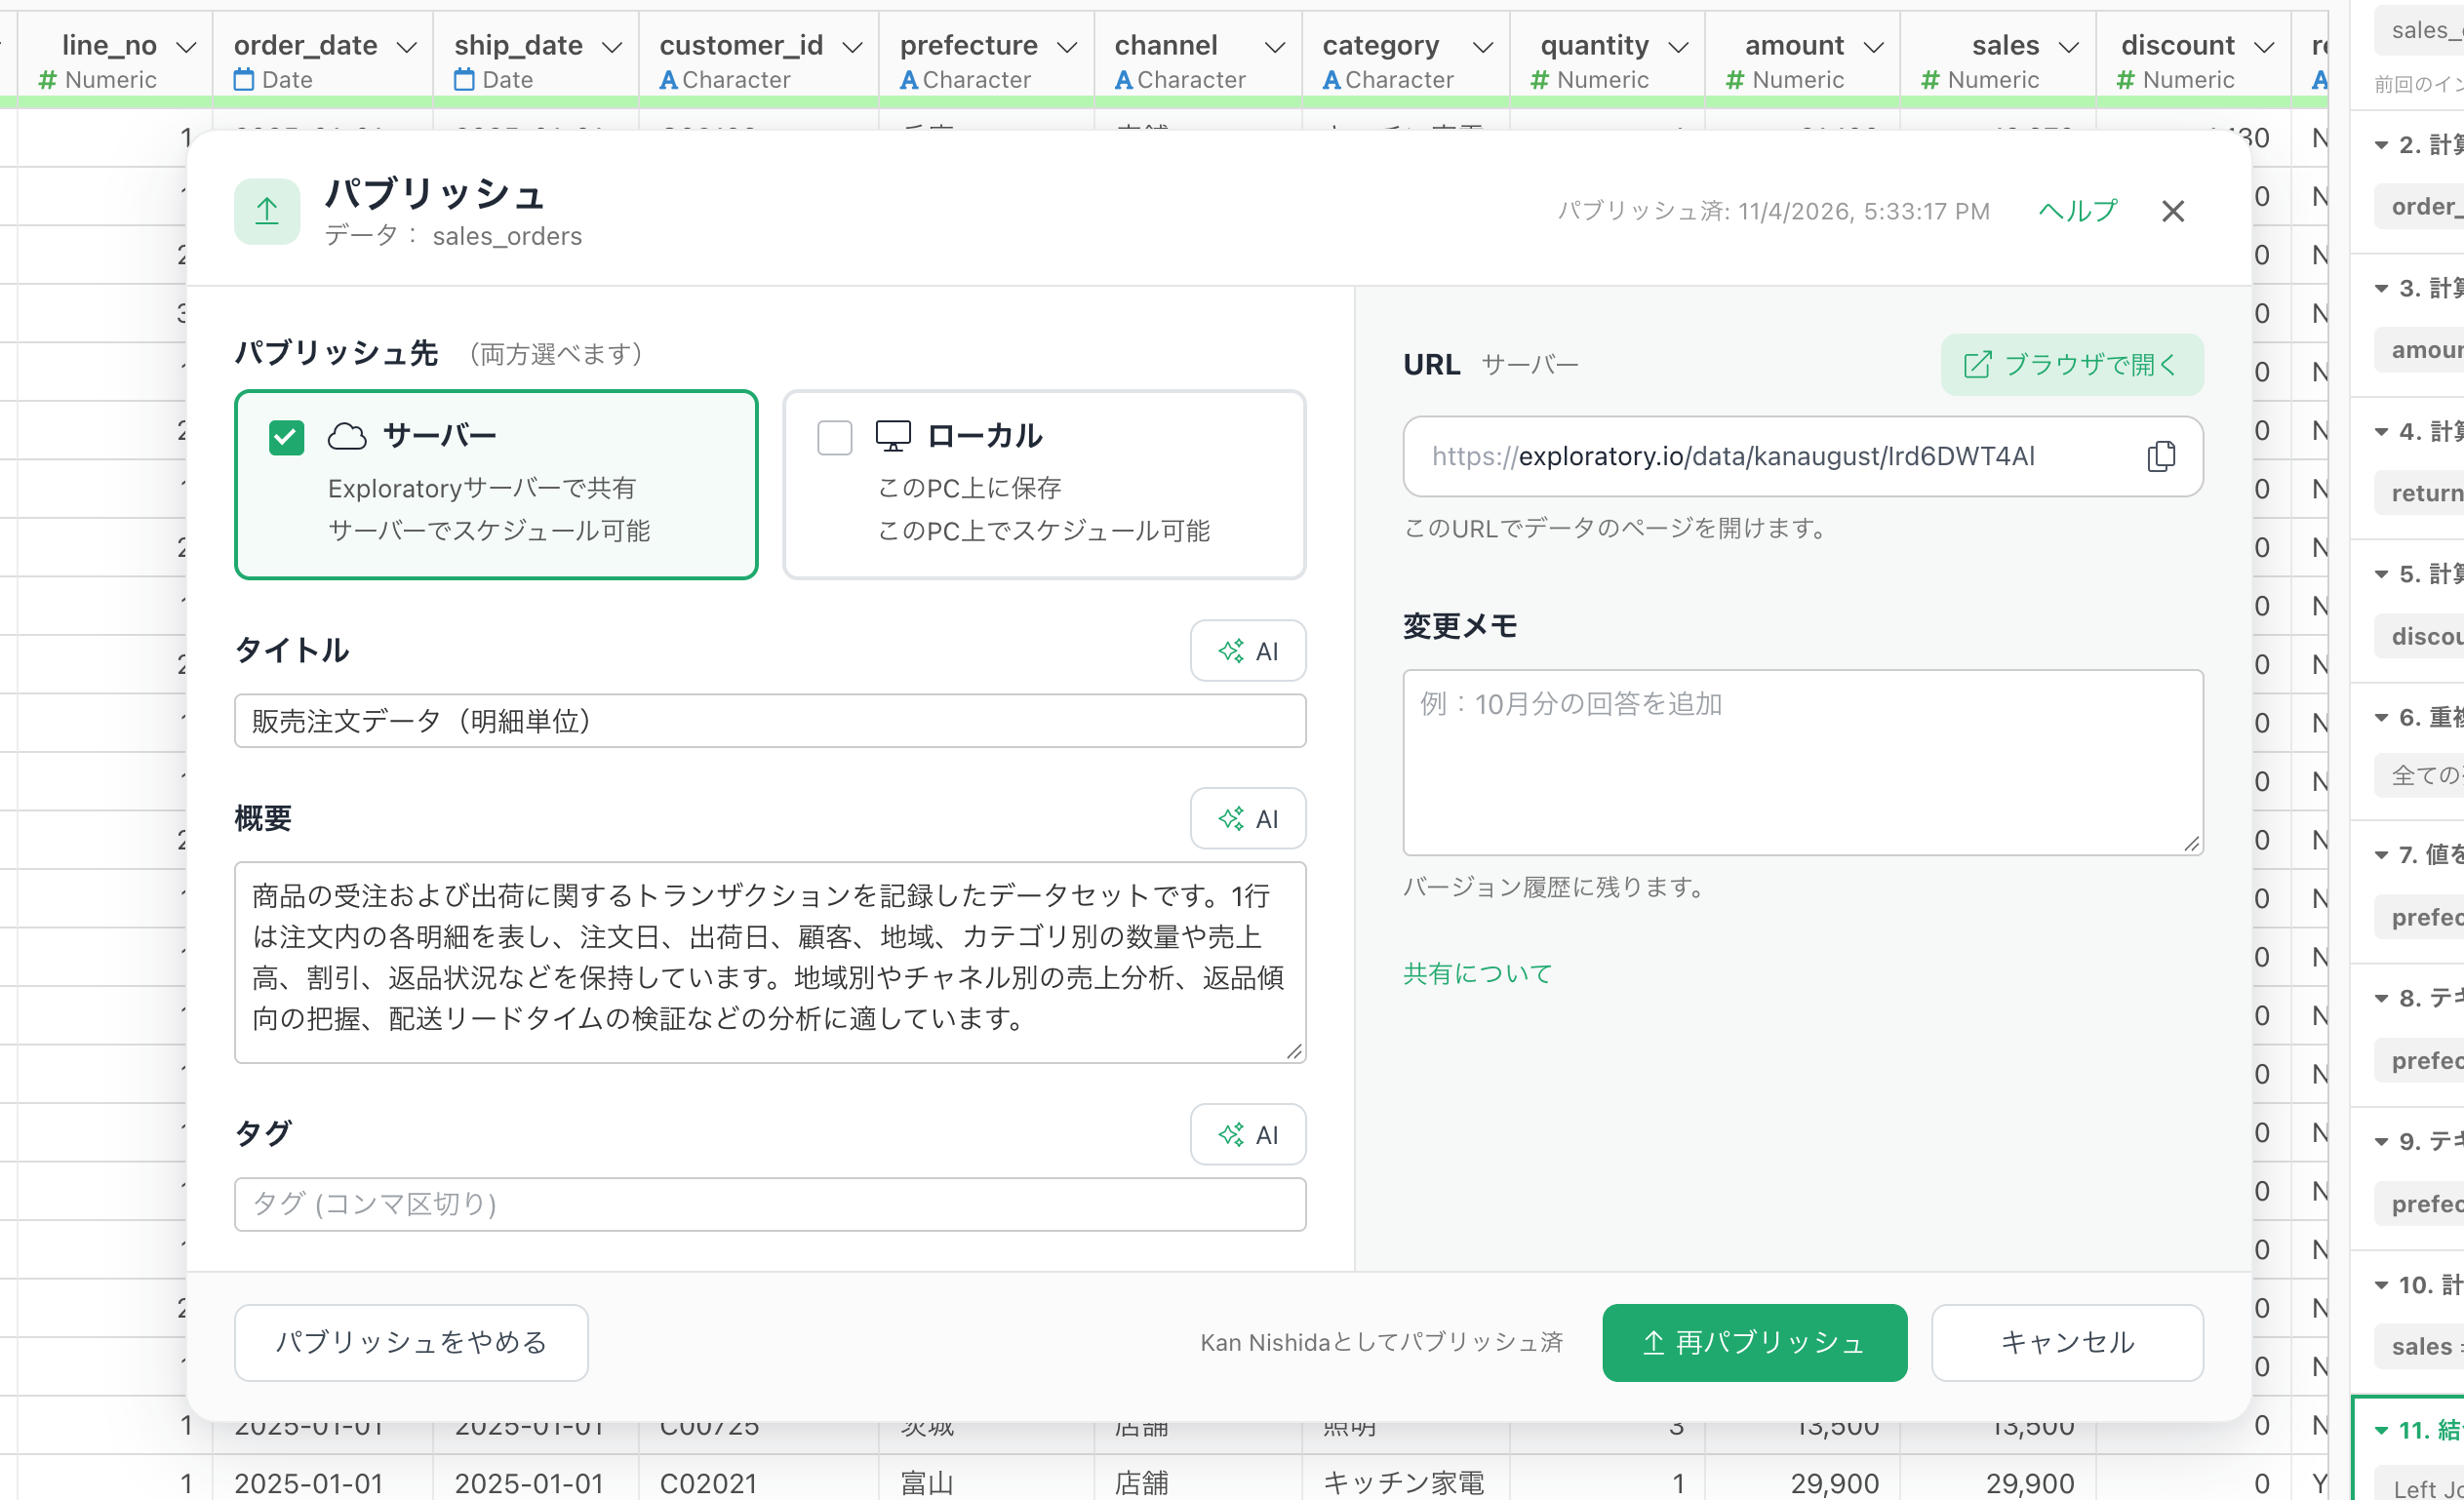
データ加工の過程
データがきれいに整理されていたとしても、そのデータがどのように作られたのかわからなければ、安心して利用することはできません。
例えば、「純売上」という列があった場合、その値がどのように計算されたのかを確認したいことがあります。
Exploratory データカタログでは、パブリッシュされたデータの加工ステップを、ダイアグラムとして確認できます。
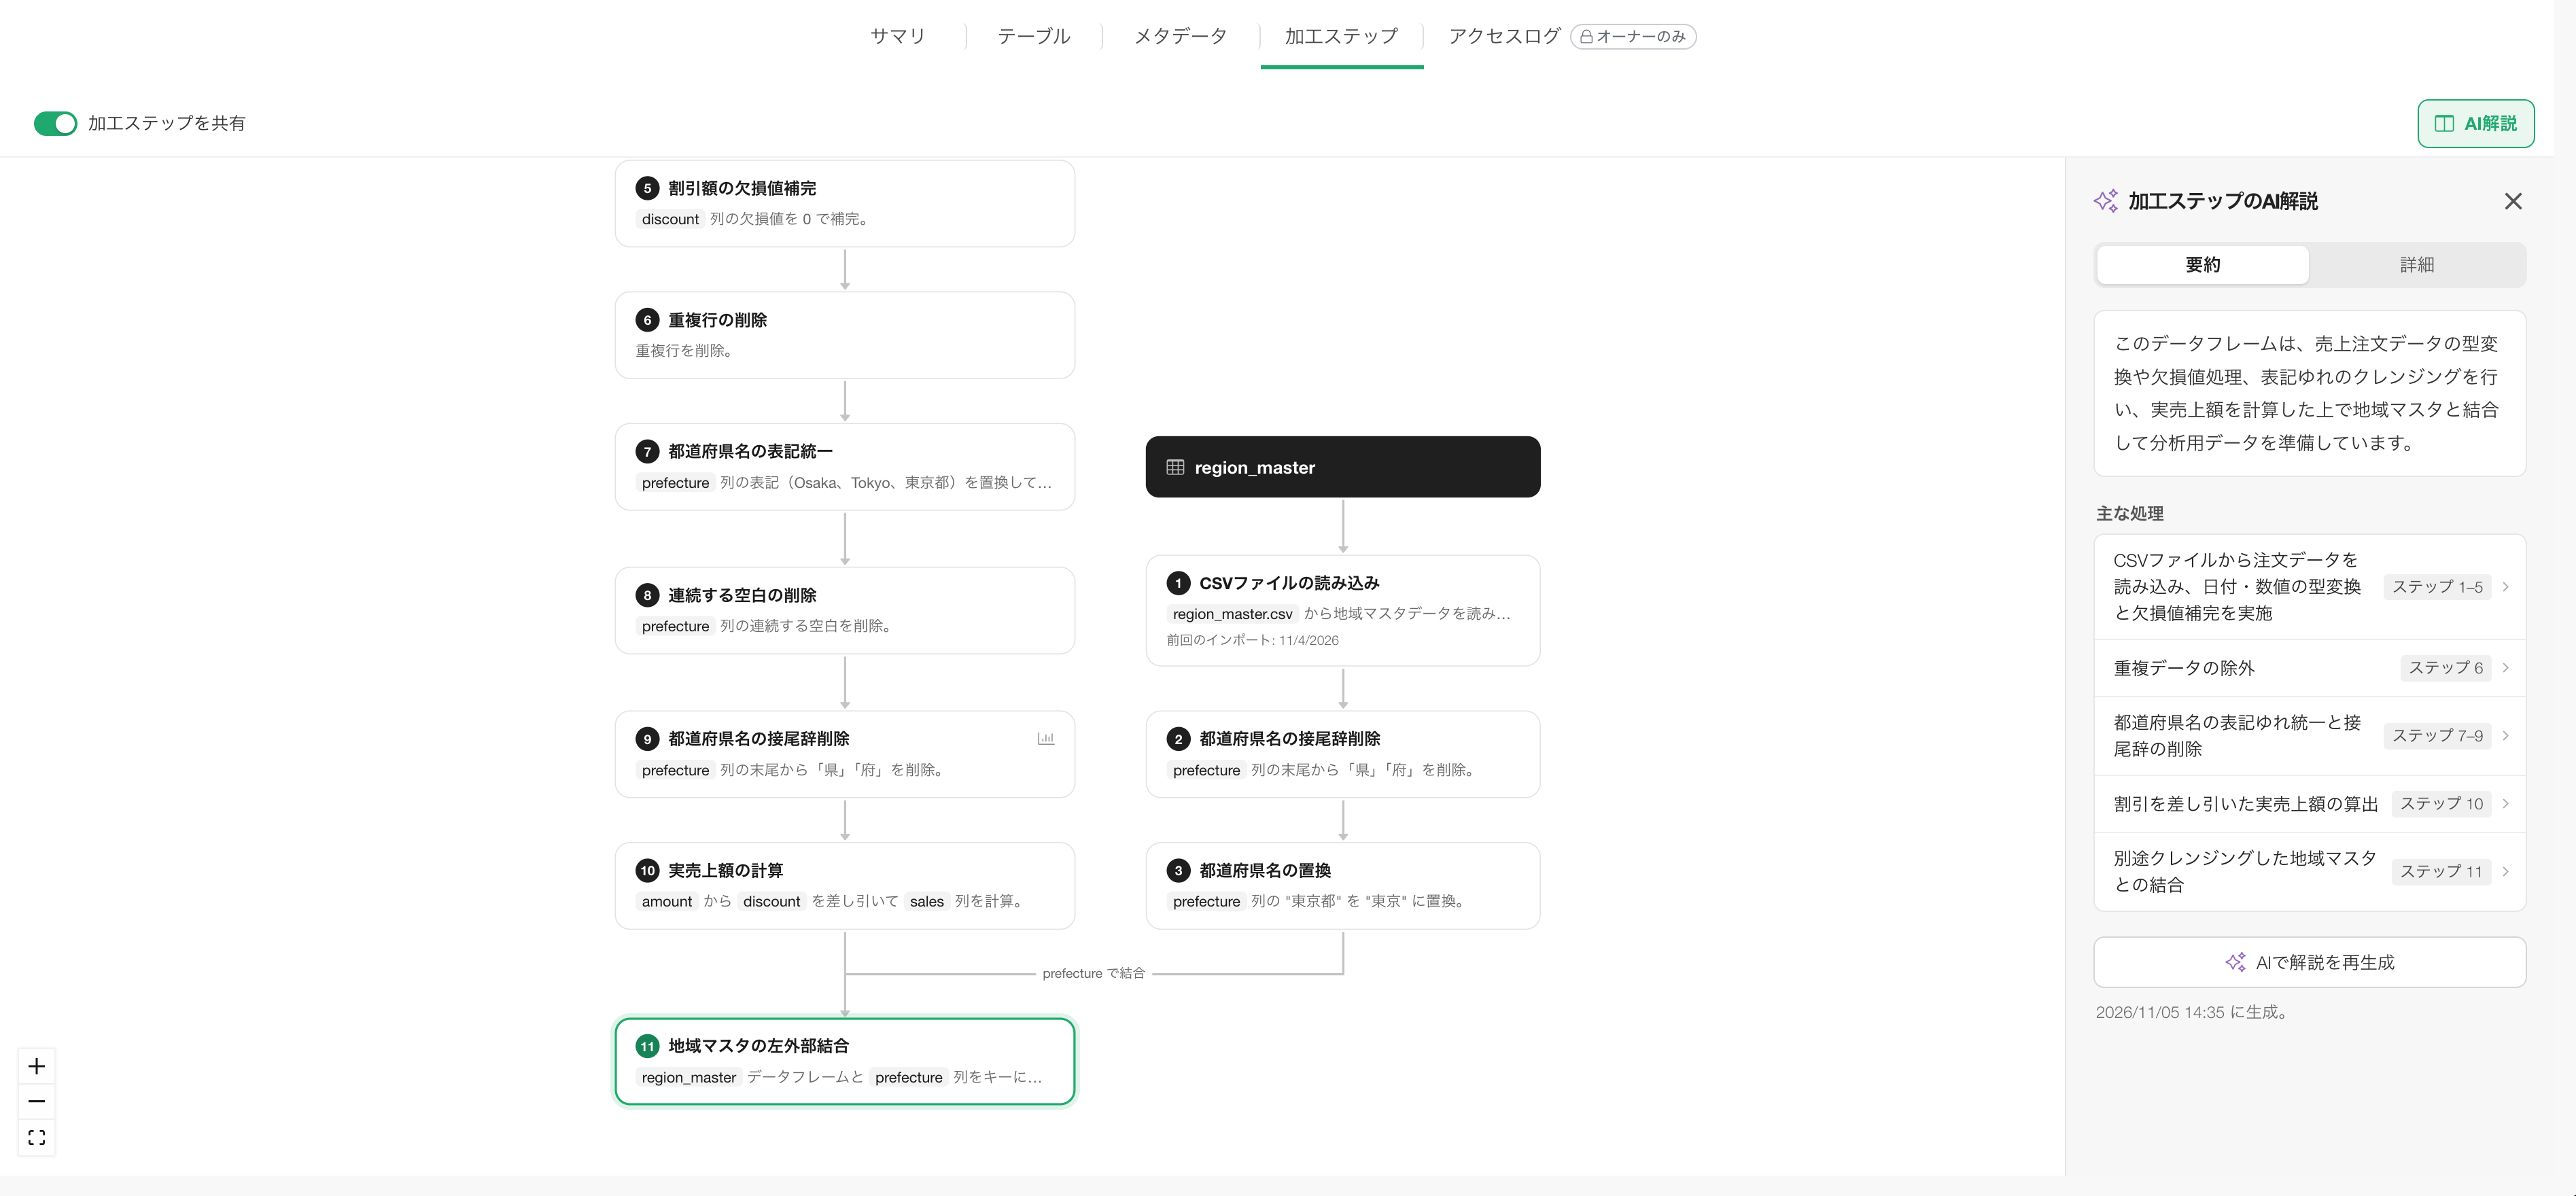
元のデータがどこから来て、どのようなフィルタや結合、計算が行われ、最終的なデータが作られたのかを視覚的に把握できます。
スケジュールで最新の状態を保つ
データは、一度準備すれば終わりというものではありません。
売上データであれば、新しい注文や返品が日々追加されていきます。
そのため、データカタログにパブリッシュしたデータも定期的に更新する必要があります。
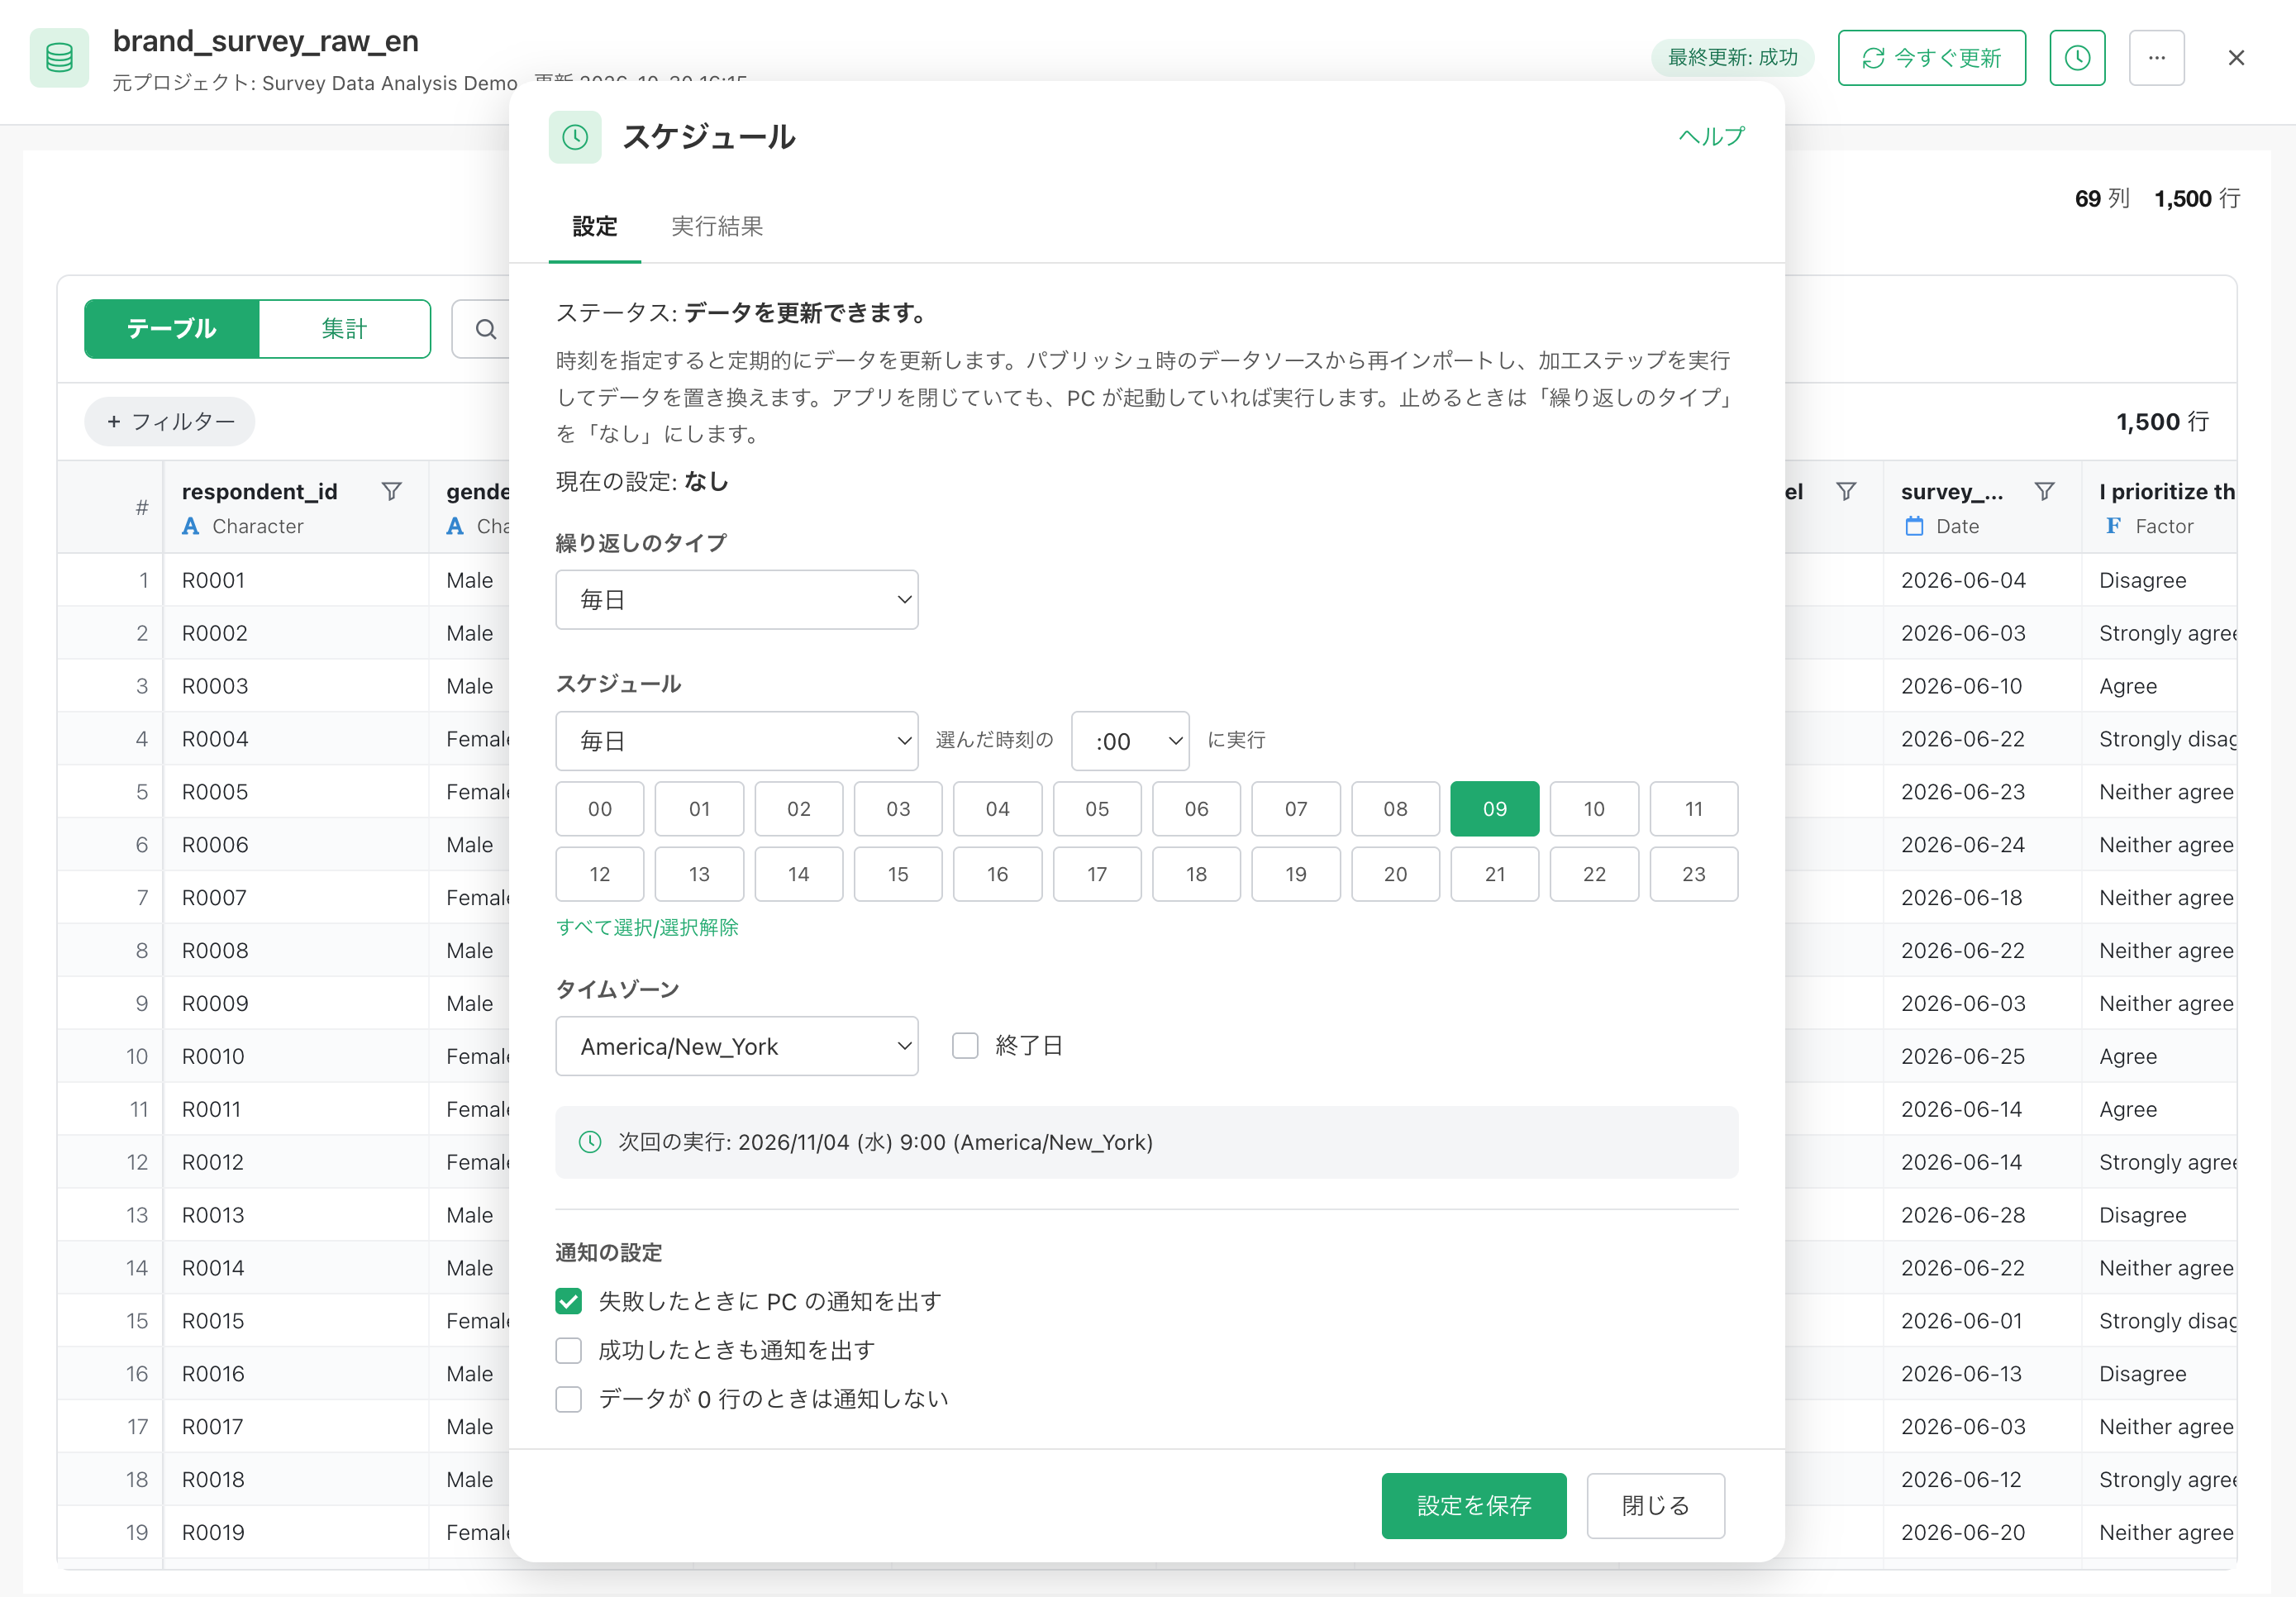
スケジュールを設定すると、決まった時間にデータソースからデータが取得され、必要な加工ステップも自動で実行されます。加工が再現可能だから、新しいデータにも同じルールを適用できます。
Exploratory v17から、ローカルのデータカタログにパブリッシュしたデータも、データの更新をスケジュールできるようになりました。
PCのスケジュール機能を使うため、Exploratoryが立ち上がっていなくても、決められた時間に実行されます。(ただし、指定した時刻にPCが稼働し、データソースにアクセスできる状態であることが必要です。)
意味づけ:データの意味とビジネスルールをエージェントに伝える
データが整っていることと、そのデータをエージェントが意図した通りに使えることは、別の話です。そこで、データカタログにパブリッシュしたデータに「セマンティクス情報」を加えることができます。
列名だけでは分からない
例えば、売上データに以下のような列があったとします。
| 列名 | 内容 |
|---|---|
gross_sales |
割引前の売上 |
discount_amount |
割引額 |
return_amount |
返品額 |
net_sales |
純売上 |
order_date |
注文日 |
region |
地域 |
ここでAI エージェントに、「2026年の地域別の純売上は?」と質問したとします。
AI エージェントは、どの列を使うべきでしょうか。
gross_salesでしょうか。それともnet_salesでしょうか。
純売上の計算に返品や割引をどう反映させるべきでしょうか。
こうしたことは、列名やデータ型だけでは必ずしもわかりません。
正しく判断するためには、データの意味だけでなく、ビジネスルールやドメイン知識が必要になります。
セマンティクス — データに意味とビジネスルールを加える
そこで、Exploratory データカタログでは、パブリッシュしたデータにセマンティクス情報を追加できるようになりました。セマンティクスとは直接は「意味」と訳される英語ですが、データ分析の文脈ではデータに対してビジネス上のルールや文脈(コンテクスト)情報を持たせるといった意味で使われます。
セマンティクス情報には、単なる列の説明だけでなく、さまざまな情報を含めることができます。
例えば、データ全体の概要、データの粒度、主要な日付列、更新状況、各列の意味や役割、別名、ビジネス指標とその計算方法、よくある質問と集計例などです。
先ほどの売上データであれば、「純売上」というビジネス指標について、次のような定義を加えることができます。
純売上(Net Sales)- 「純売上」は、割引と返品を反映した売上を表す指標です。純売上の集計には`net_sales`列の合計を使用し、`gross_sales`を使用したり、割引や返品を再度差し引いたりしないでください。`net_sales`列に、キャンセル注文の除外、割引、返品の処理を反映した計算済みの値が保存されています。
こうした情報をAI エージェントに提供することで、エージェントはどの列を使い、どのように集計すべきか判断しやすくなります。
Exploratoryのデータ加工情報から、AIがセマンティクスを自動生成
ここで、一つ重要な問題があります。
セマンティクス情報がAI エージェントにとって重要だとしても、それを人間が一から作成するのは大変です。
大量のデータや列がある場合、それぞれの意味、ビジネスルール、計算方法などを一つずつ調べ、記述していくには多くの時間がかかります。
そこで、Exploratoryではデータ加工の情報を使って、AIがセマンティクス情報を自動生成する仕組みを用意しました。
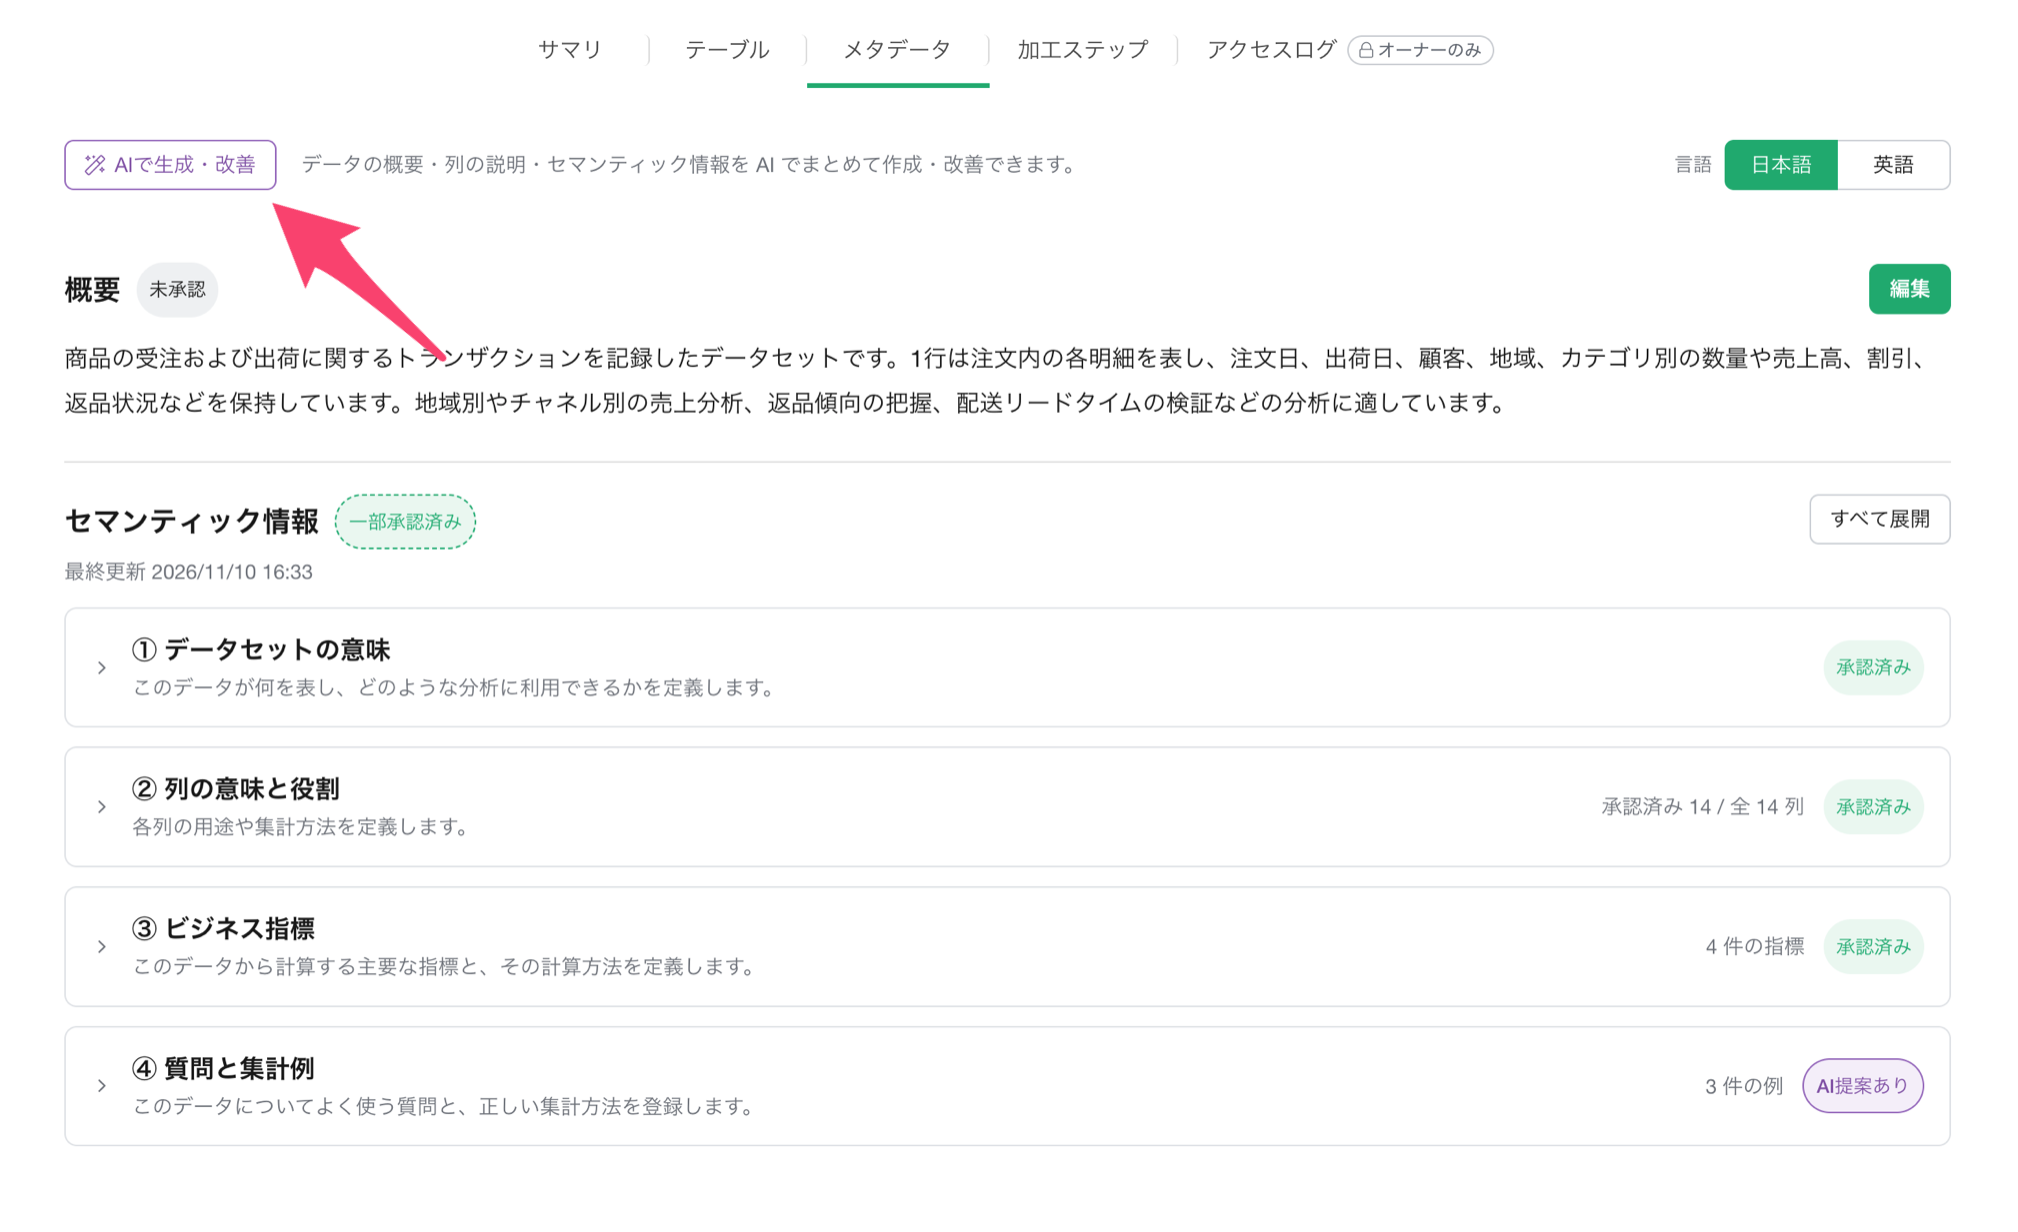
Exploratoryでデータを準備した場合、そのデータがどのように加工されたのかという情報がすでに存在しています。
例えば、どの列を結合したのか、どのような条件でデータをフィルタしたのか、どのような計算式を使って新しい列を作成したのか、といった具合です。
こうした加工情報は、データの意味やビジネスルールを理解するための重要な手掛かりになります。
Exploratoryでは、この情報をAIに提供して、データの概要や列の説明、ビジネス指標などのセマンティクス情報を生成できます。
もちろん、AIが生成した説明が必ず正しいとは限りません。
例えば、計算式から純売上の算出方法を推測できても、その計算方法が現在の会社のルールと一致しているかどうかは、AIだけでは判断できない場合があります。
そのため、ExploratoryではAIが生成したセマンティクス情報を人間が確認し、承認または棄却できるようにしています。
これによって、セマンティクス情報を作成する負担を減らしながら、自分たちの意図したビジネスルールをAI エージェントに伝えられるようになります。
エージェントが受け取るのは、人が承認したセマンティクス情報だけです。
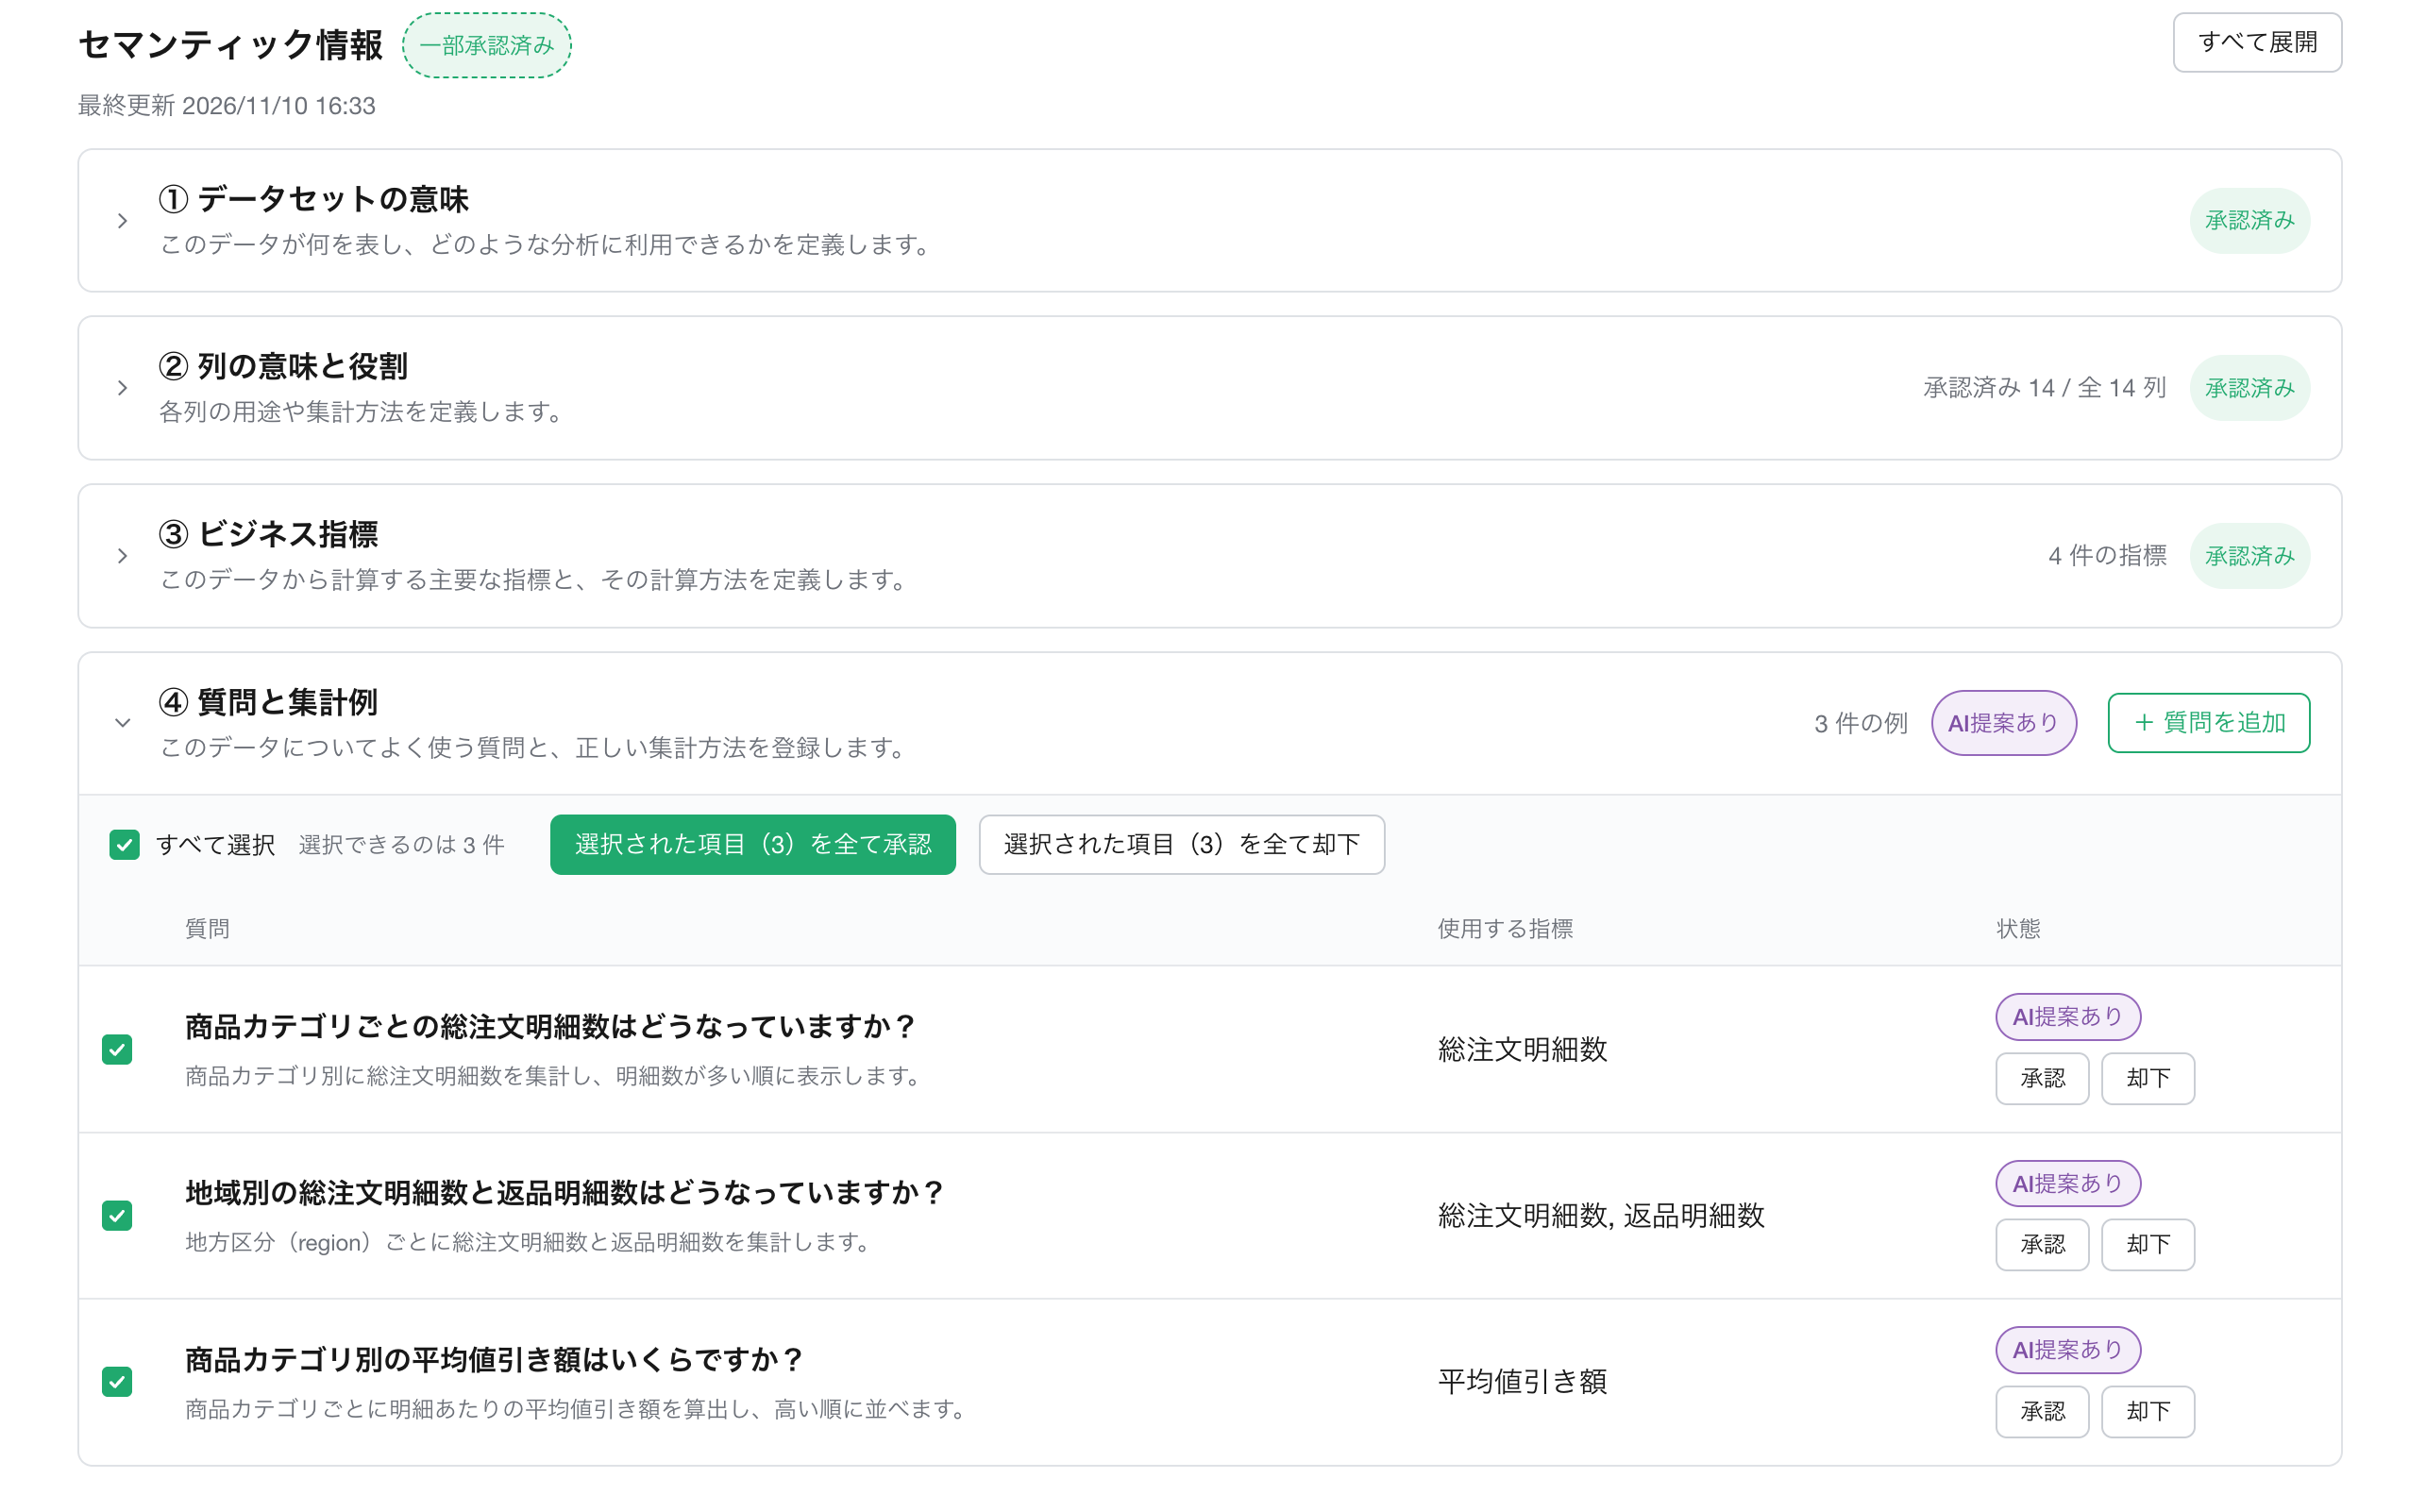
ローカルデータカタログでもセマンティクスを利用できる
こうしたセマンティクス情報は、サーバー上のデータカタログだけでなく、Exploratory デスクトップ内のローカルデータカタログにも追加できます。
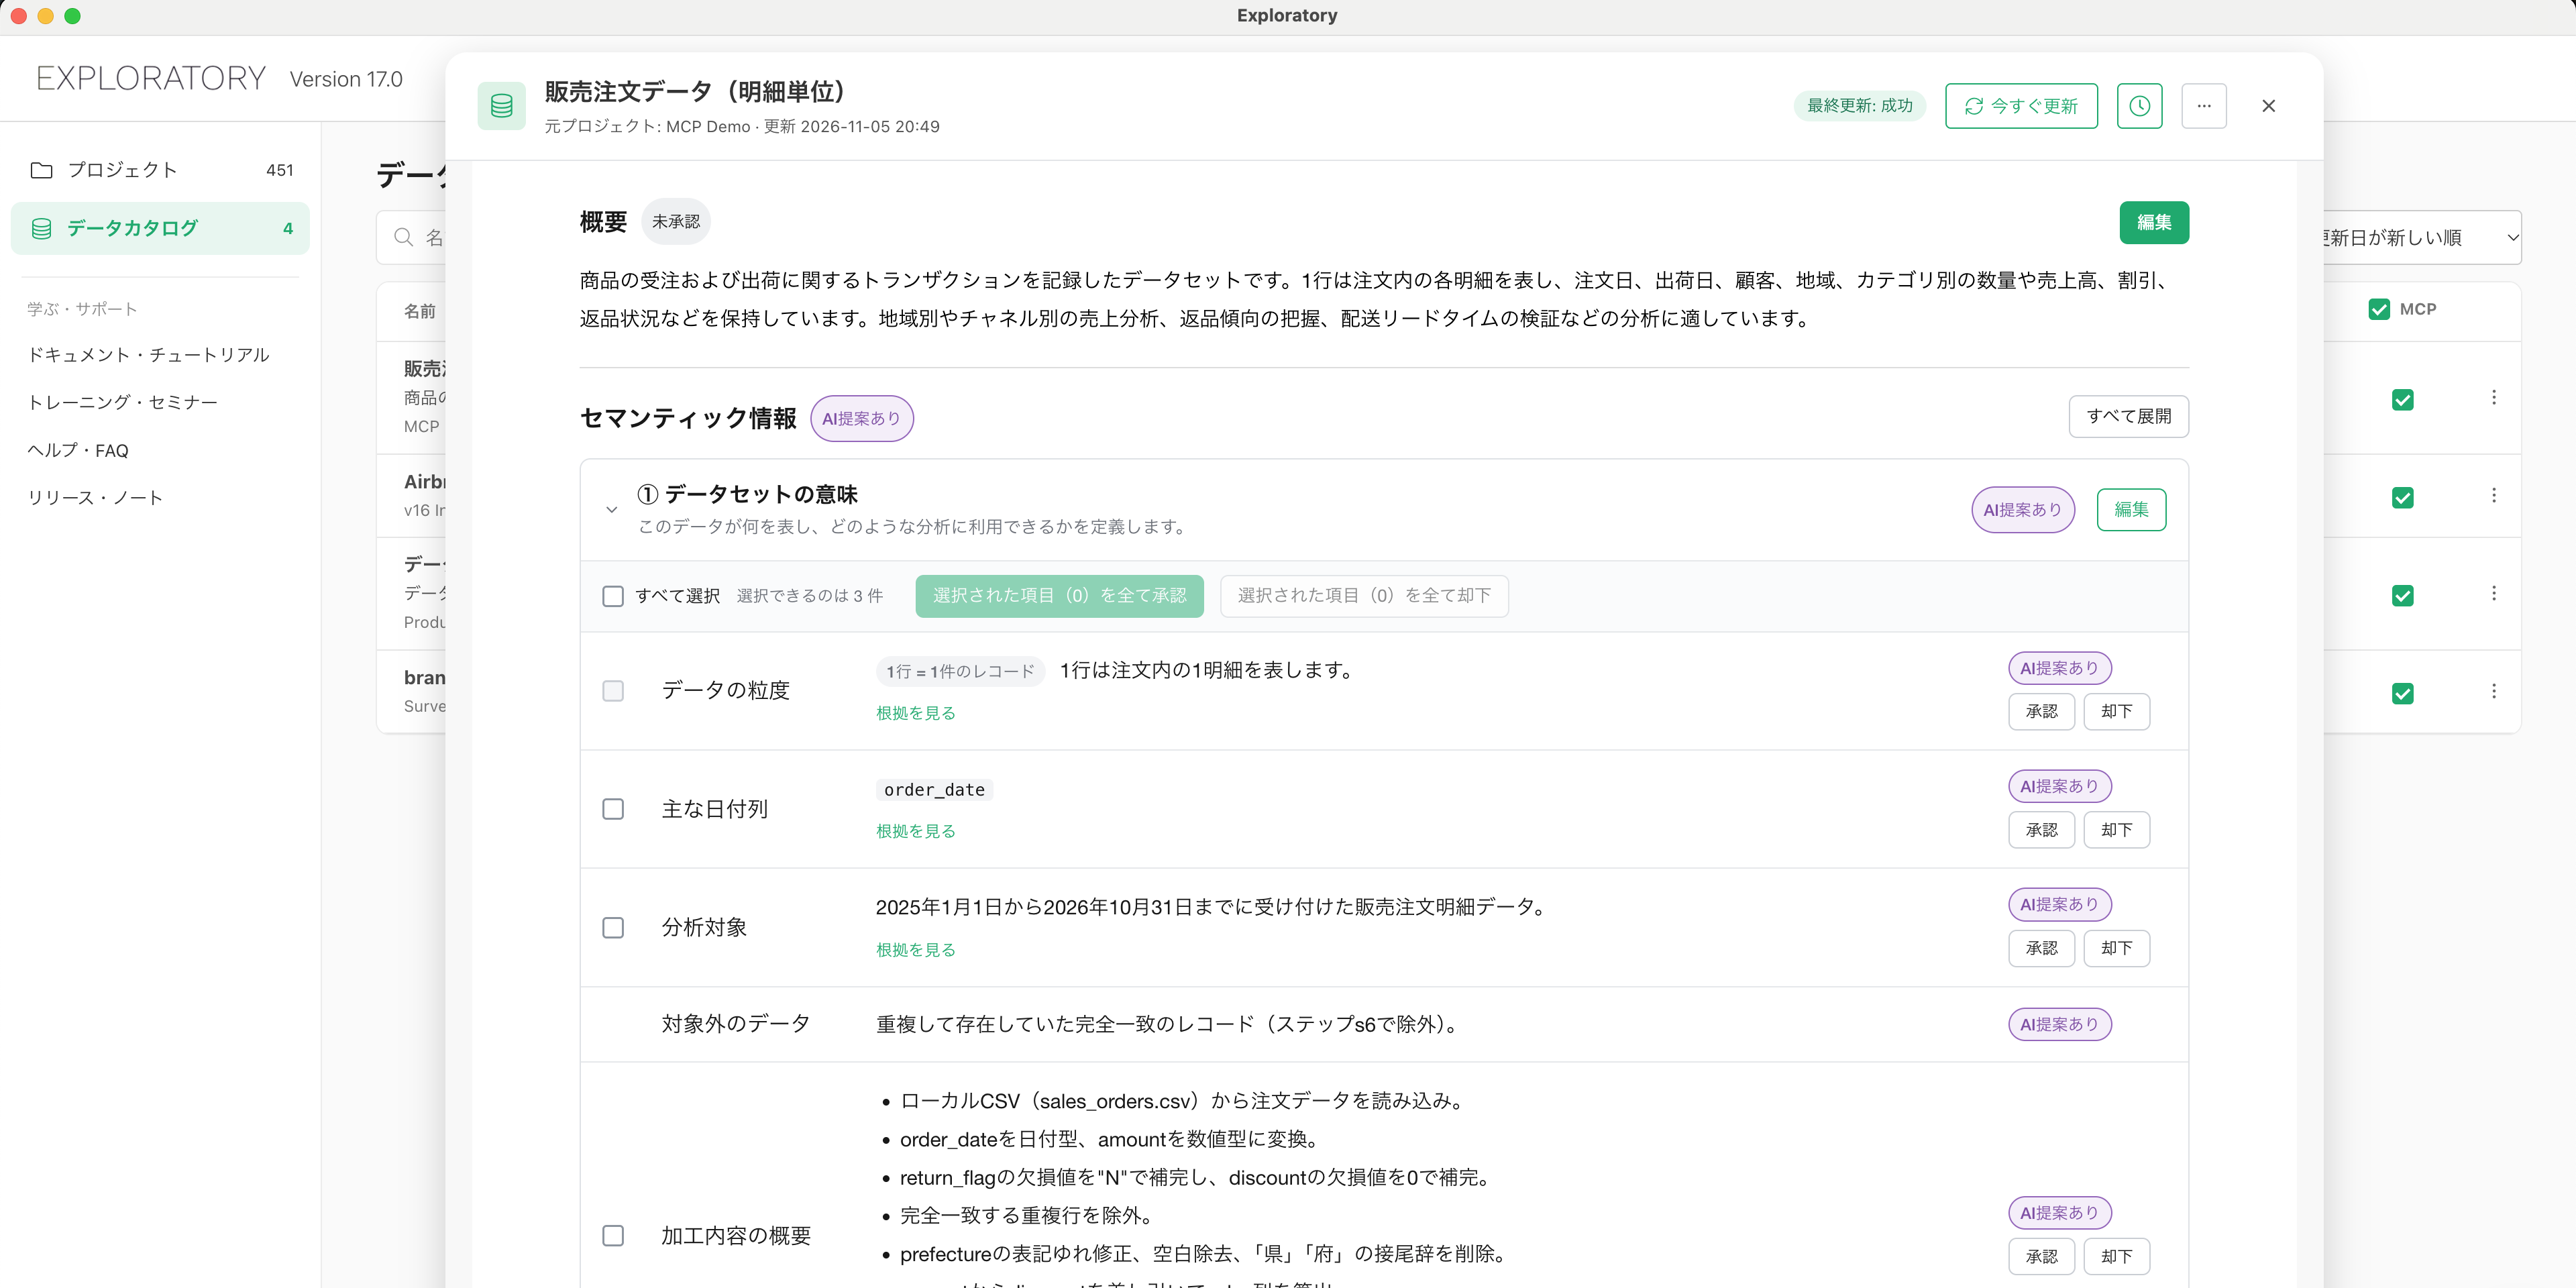
ローカルで準備・検証したデータにセマンティクス情報を加えることで、同じPC上のAI エージェントは、ビジネスの文脈を踏まえたうえでデータカタログのデータを活用することができるようになります。
アクセス:必要なデータを、必要なときに、必要な量だけ
エージェントがデータにアクセスできるようになっても、それだけで分析が効率的になるわけではありません。
AI エージェントに「2026年の地域別の純売上は?」と質問したとき、その1,000万行すべてをダウンロードして、エージェント側で必要なデータを探したり集計したりする必要があるのでしょうか。
毎回全データをダウンロードし、そこから必要な部分を探すのでは、時間がかかり、トークンのコストも高くなります。
そもそも、今回必要なのは1,000万行のデータではありません。
地域別に集計された、わずか数十行の結果だけかもしれません。
であれば、最初から必要なデータだけを取得させたいものです。
柔軟なクエリ
そこで、Exploratory データカタログでは、データを取得する際に柔軟なクエリを実行できるようにしました。
例えば、以下のような操作が可能です。
- フィルタ: 条件を指定して、必要な行だけを取得する。
- 列の選択: 必要な列だけを選択する。
- 集計: グループ別に合計や平均などを計算する。
- 結合: データカタログにある複数のデータを結合する。
先ほどの「2026年の地域別の純売上は?」という質問であれば、2026年のデータに絞り込み、地域別にnet_salesを合計した結果だけを取得できます。
これなら、AI エージェントは大量のデータをダウンロードする必要がありません。
必要な情報だけを受け取れるため、データ転送やエージェント側の処理が効率的になり、AIモデルに渡す情報量も抑えられます。
クエリの高速化
さらに、Exploratory データカタログでは、DuckDBとのインテグレーションによって、クエリの高速化にも取り組みました。私たちが開発時に行ったテストでは、数百万〜数千万行のデータでも、1秒以内にデータを取得できることを確認しています。(ただ、エージェント環境からExploratoryサーバーへのネットワークの速度が影響しますので、みなさんの環境でまったく同じようなパフォーマンスが出るとは限りません。)
柔軟なクエリと高速な処理によって、エージェントは必要なデータを、必要なときに、必要な量だけ取得できます。その結果、レポート作成や分析を効率的に進めることができます。
MCPを通じて、AI エージェントから直接アクセス
Exploratory データカタログは、MCP(Model Context Protocol)をサポートしています。
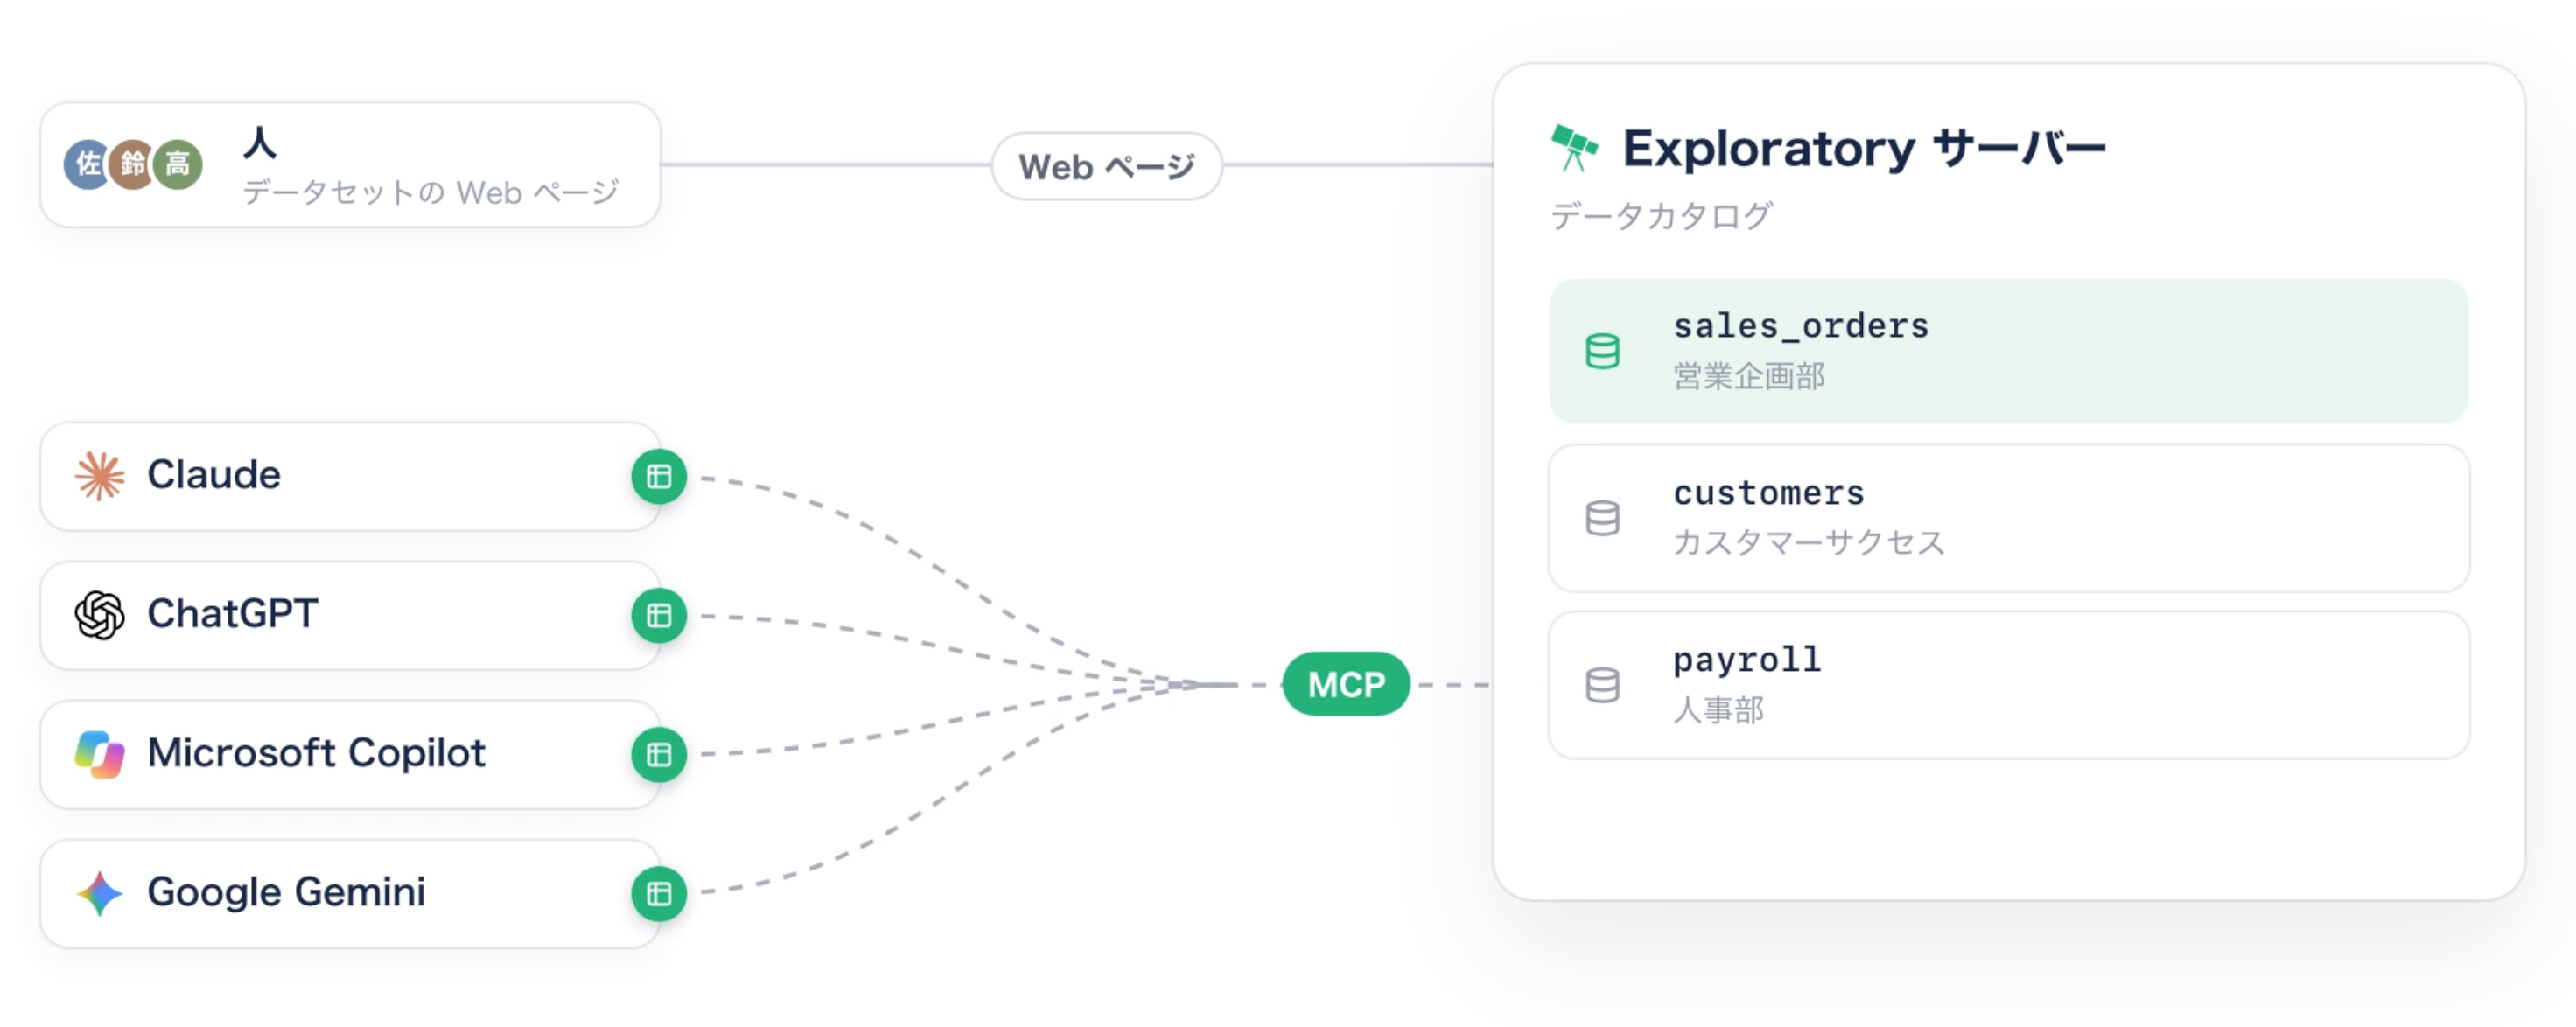
MCPは、AI エージェントが外部のデータやツールにアクセスするための仕組みです。
Exploratory Serverにデータをパブリッシュすれば、Server MCPを通じてAI エージェントからアクセスできます。
Exploratory Server MCPの詳細や、お使いのAI エージェント(Claude Codeなど)への登録方法などはこちらのページをご覧ください。
また、Exploratory デスクトップ内のローカルデータカタログにパブリッシュしたデータには、Desktop MCPを通じて、同じPC上にあるClaude CodeやCodexなどのAI エージェントからアクセスできます。
Exploratory Desktop MCPの詳細は、こちらのページをご覧ください。
つまり、あなたのAI エージェントはデータの内容やセマンティクス情報を確認し、必要なクエリを実行し、その結果を使って分析やレポート作成を進められるようになります。
データをサーバーにアップロードする必要もない
企業によっては、データを外部のサーバーにアップロードすることが制限されている場合があります。
そのような場合でも、ローカルデータカタログを利用すれば、データをExploratory Serverにアップロードすることなく、ローカルのAI エージェントからアクセスできます。
ローカルでもデータの準備、スケジュールによるデータの自動更新、セマンティクス情報の追加、高速クエリを利用できます。
コントロール: AI エージェントからのデータアクセスを管理・監視する
AI エージェントからデータを簡単に取得できるようになることは便利ですが、一方で、データへのアクセスを適切に管理することが重要となります。
例えば、誰がどのデータにアクセスしているのか。
どのような方法でアクセスしたのか。
AI エージェントがどのようなクエリを実行したのか。
大量のデータを繰り返し取得するようなアクセスが発生していないか。
こうしたことを把握することは、データを安心してAI エージェントに利用させるためにも重要です。
データごとのMCPアクセス管理
Exploratoryのデータカタログでは、データごとにMCP経由のアクセスを管理できます。
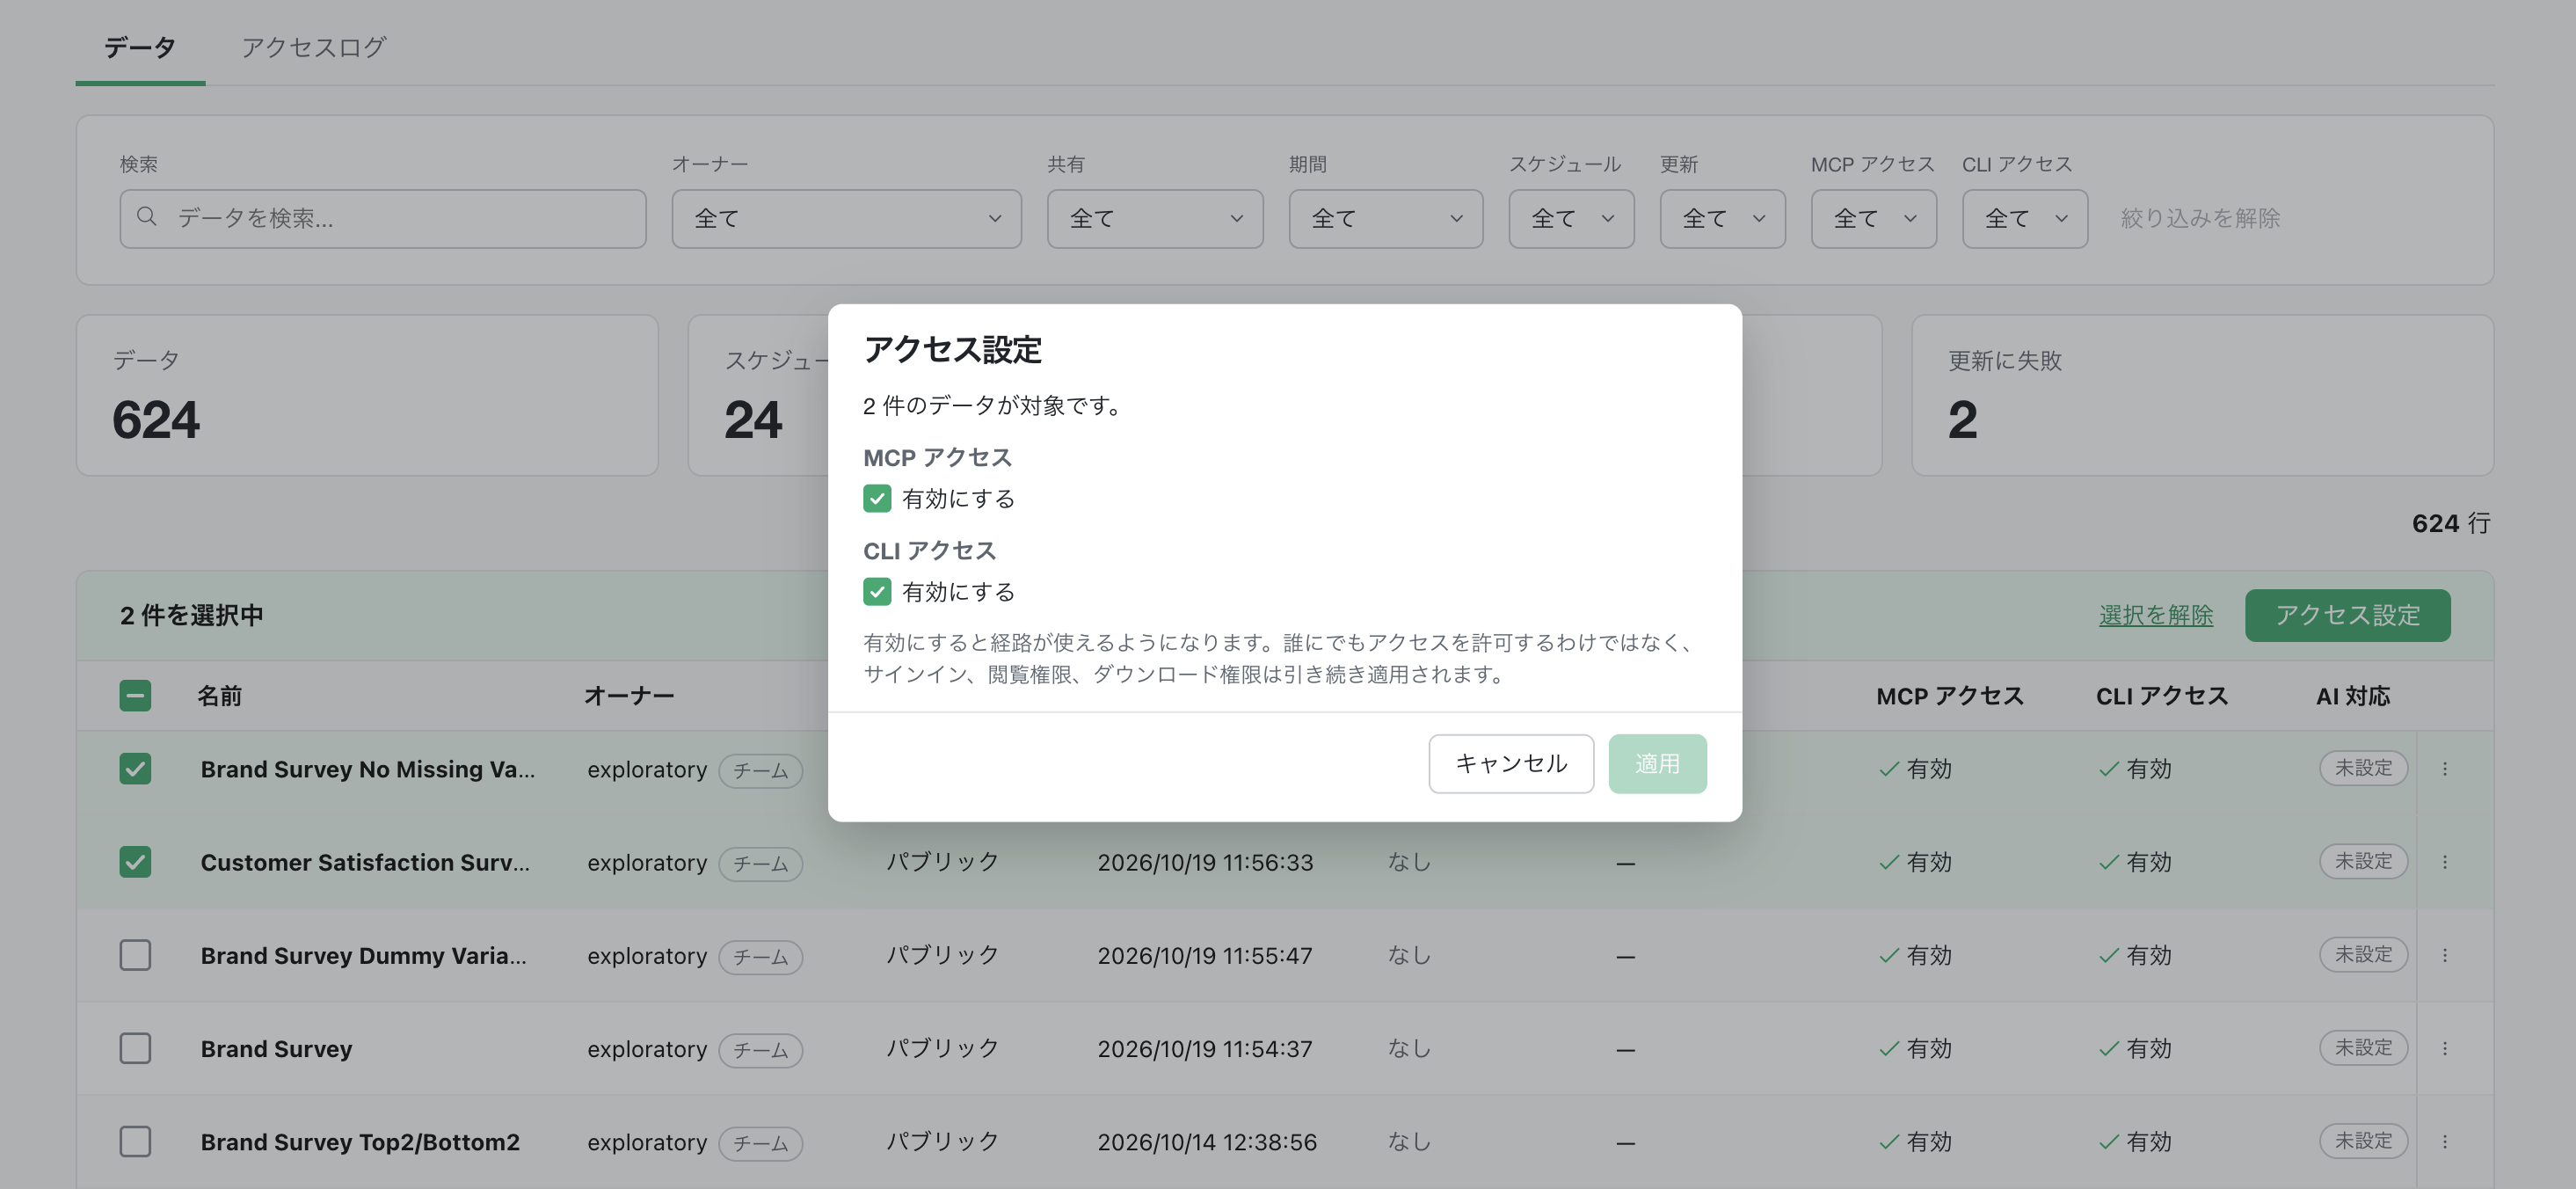
これによって、どのデータをAI エージェントから利用できるようにするかを、データ単位でコントロールできます。
アクセスログとクエリ履歴
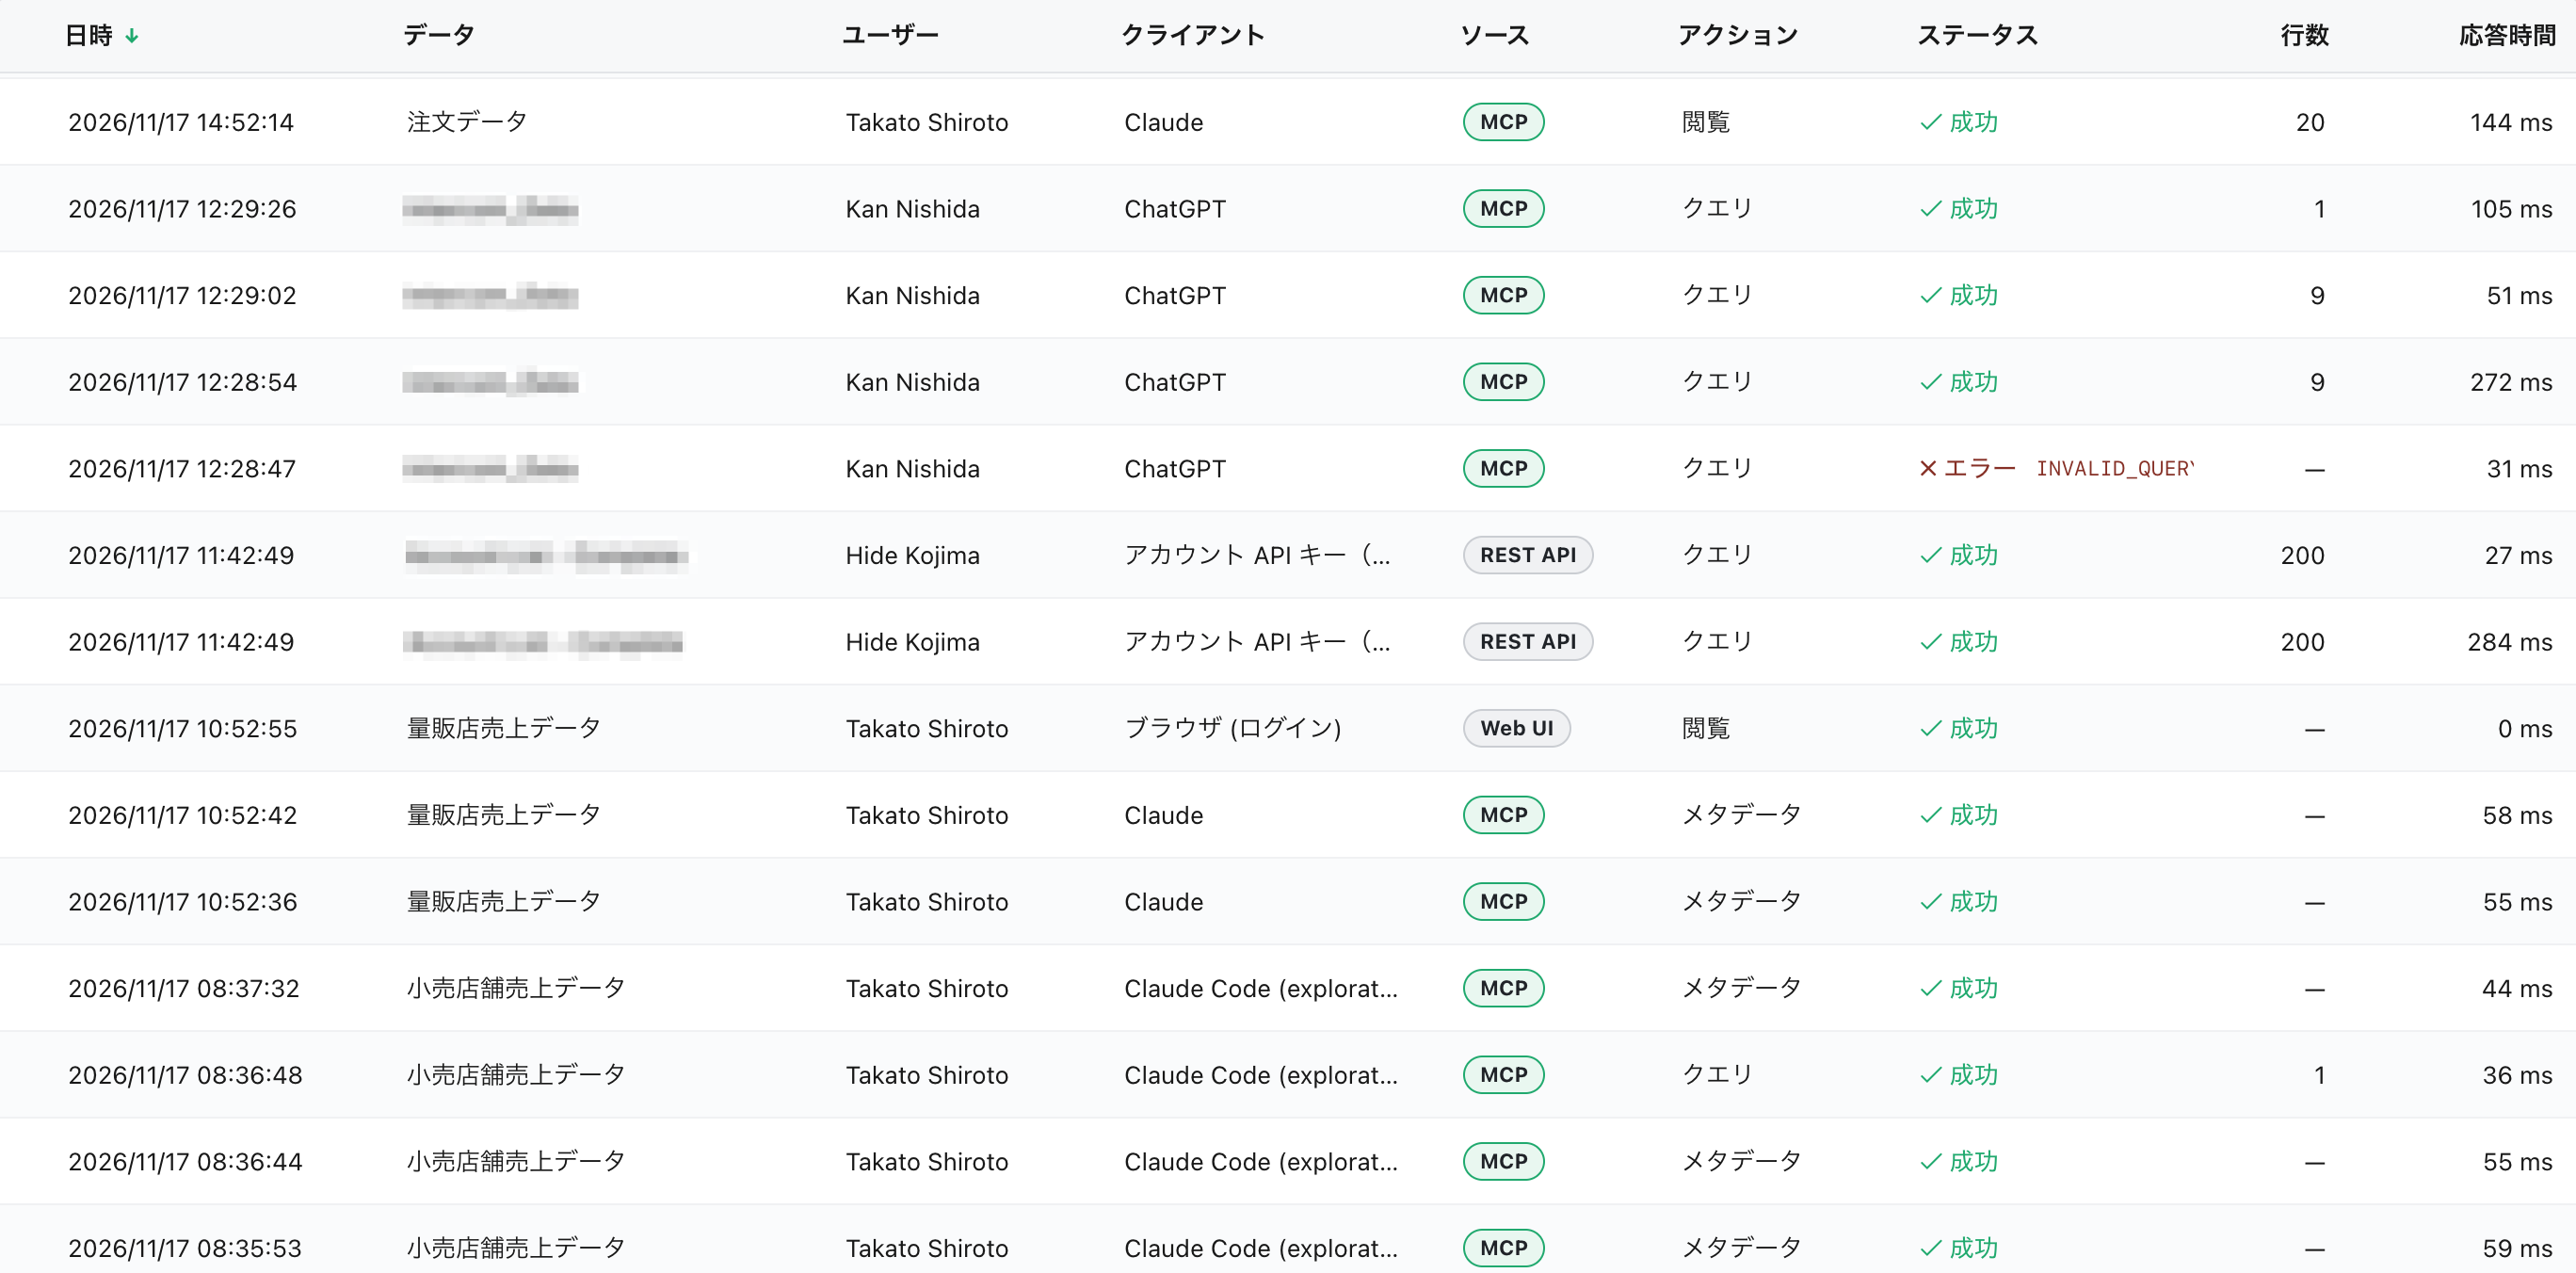
さらに、データに対するアクセスを記録し、アクセスログのページから確認できるようになりました。
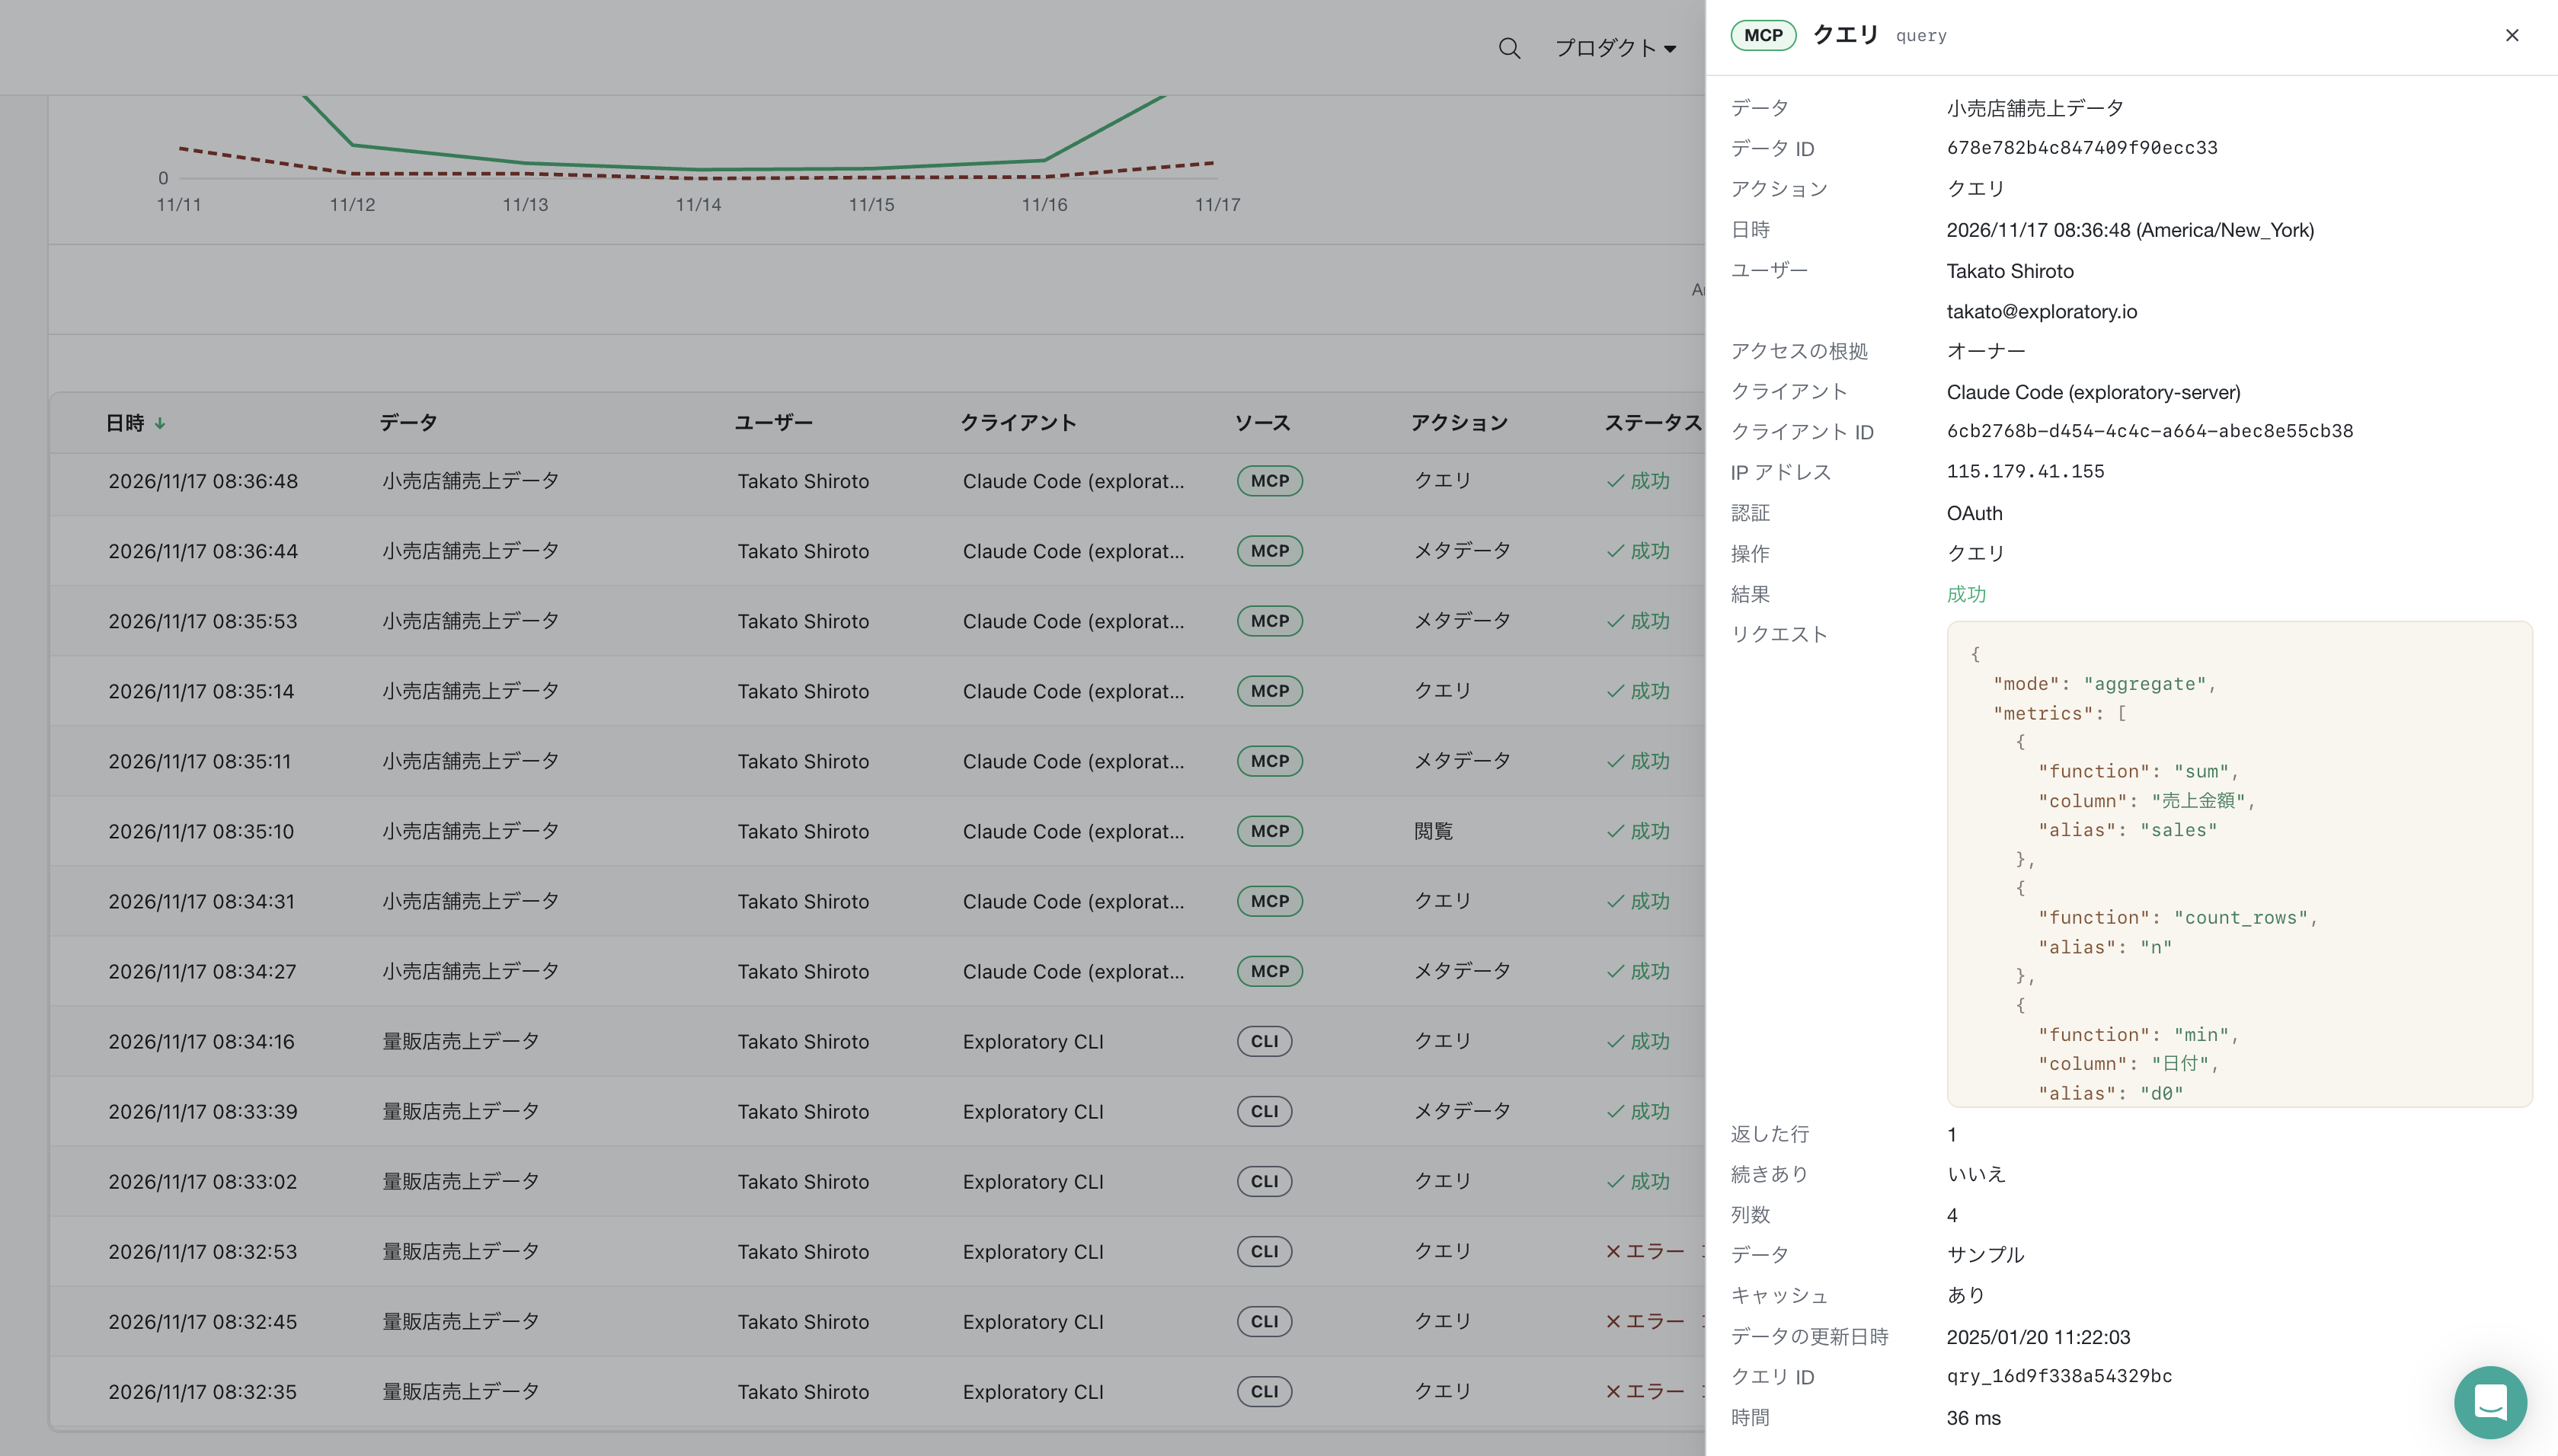
アクセスログでは、MCP、API、UIなどのアクセス方法に加え、国、IPアドレス、クライアントなどの情報も確認できます。
アクセス方法:MCP、API、UI
アクセス元:国、IPアドレス、クライアント
クエリ:内容、処理時間、ステータス
これらは、データ所有者がアクセス状況を確認するための情報です。
AI エージェントにデータを活用させながらも、データの所有者がアクセス状況を把握し、管理できる。
これも、Exploratory データカタログが提供する重要な価値の一つです。
まとめ: エージェントを使ったデータ分析は、信頼できるデータから始まる
AI エージェントの進化によって、データ分析は大きく変わろうとしています。
データの集計や分析、チャートやダッシュボード、レポートの作成など、これまで人間が多くの時間をかけていた作業を、AI エージェントが担えるようになってきました。
しかし、AI エージェントがどれほど優秀になっても、元となるデータに問題があれば、その分析結果を信頼することはできません。
また、データそのものが正しくても、その意味やビジネスルール、背景が正しく伝わらなければ、AI エージェントは意図した分析を行えない可能性があります。
だからこそ、データを正しく準備し、人間がデータがどう準備されたのかをしっかりと検証することがこれまで以上に重要になります。
一度信頼できるデータが準備されたら、そのデータをAI エージェントに提供し、さまざまな分析やレポート作成に繰り返し活用することができるようになります。
Exploratory データカタログは、AI エージェント時代の新しいデータ分析のワークフローを実現するために、4つの価値を提供します。
準備:再現可能な加工で、人が検証したデータを準備する
意味づけ:人が承認したセマンティクス情報で、データの意味を伝える
アクセス:必要なデータだけを、高速に取得する
管理:データの置き場所を選び、利用状況を管理する
これらを組み合わせることで、データの準備からAI エージェントによる利用までを、一つの継続的なワークフローとして実現できます。
AI エージェントに分析を任せる前に、まずはあなたのデータをあなたのAI エージェントにとって使いやすい状態にしてみませんか?
Exploratory v17.0を試す
Exploratory データカタログを、ご自身のデータで試してみてください。
最新版のExploratoryをダウンロードします:https://exploratory.io/download
初めての方は、30日間の無料トライアルがあります:https://exploratory.io/
関連情報:
- MCPの接続手順: リンク