K-Medoidsクラスタリングって何?図表を使って説明!
K-Medoids クラスタリングは、似ている行をグループにまとめる手法です。各グループの中心には、データに実在する1行を使います。この記事では、手法のしくみ、アンケートデータに向いている理由、Exploratory での使い方を、図と動かせるグラフで説明します。
こちらに5分ほどのビデオもあります。
読み取れるクラスターの中心
K-Means クラスタリングは、最もよく使われるクラスタリングの手法です。各クラスターに中心を持たせ、その中心にはクラスターの平均を使います。平均は計算で求めた位置です。ふつうは、その位置にデータの行はありません。
これは、クラスターを説明したいときに困ります。たとえば、1〜5の尺度で答えるアンケートを考えます。クラスターの平均は3.7になることがありますが、3.7と答えた回答者はいません。
K-Medoids クラスタリングは、この問題を解決します。各クラスターの中心に、行の1つを使います。この行を Medoid(メドイド)と呼びます。同じクラスターのほかの行までの距離の合計が、最も小さい行です。
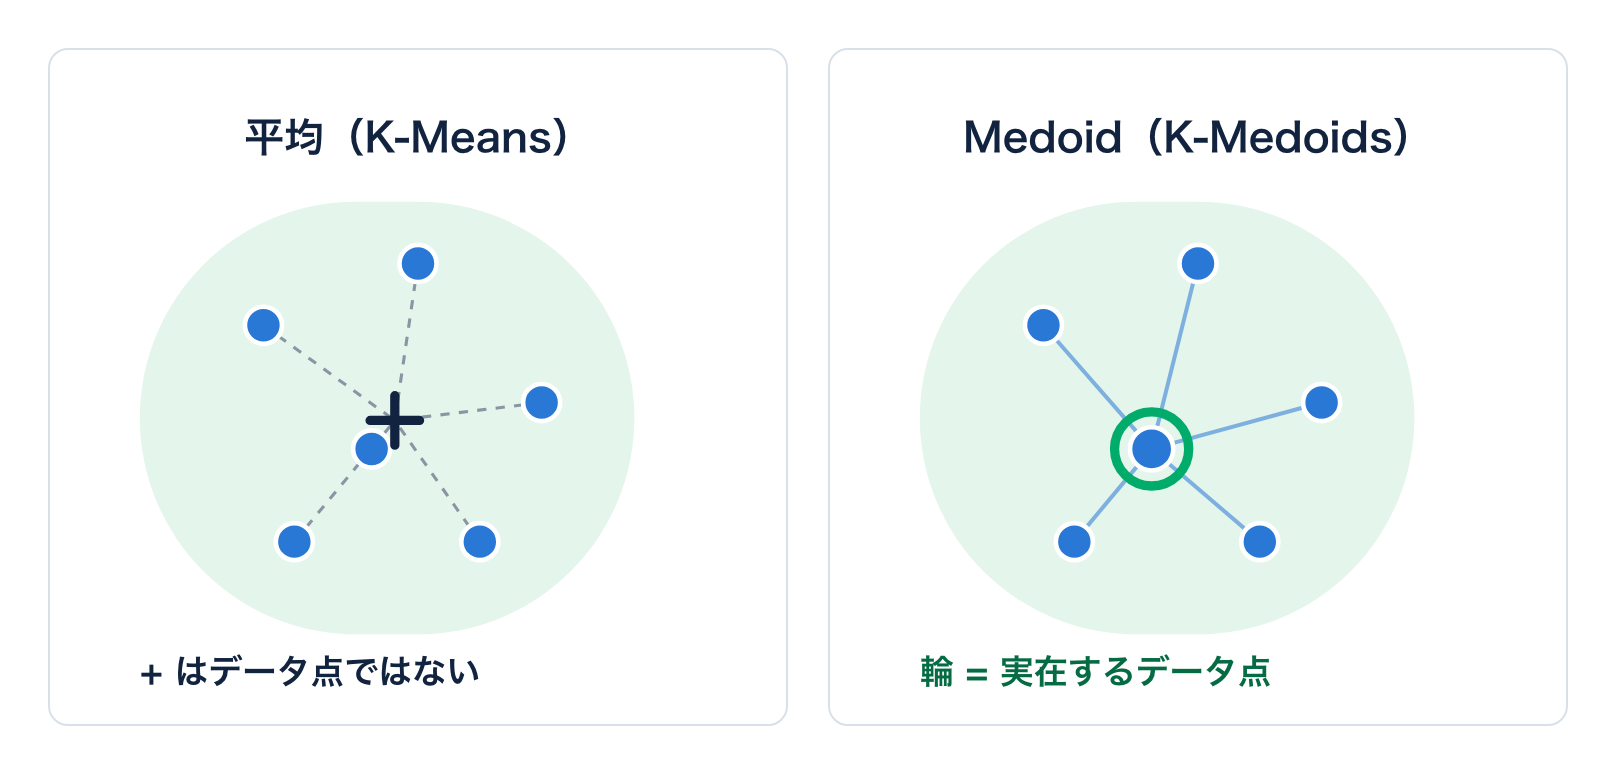
図1. 左:平均(+)は計算で求めた位置です。右:Medoid(輪)は、同じクラスターのほかの点までの距離の合計が最も小さいデータ点です。
各クラスターには Medoid があります。Medoid はデータに実在する1行なので、クラスターの典型的な例として読めます。
PAM はどうやって Medoid を見つけるか
K-Medoids で最もよく使われるアルゴリズムは、PAM(Partitioning Around Medoids)です。各行からその Medoid までの距離の合計を、できるだけ小さくします。PAM には2つのフェーズがあります。BUILD フェーズでは、最初の Medoid をうまく選びます。SWAP フェーズでは、距離の合計が減るかぎり Medoid を入れ替えます。
BUILD フェーズ
すべてのデータ点の組について、距離を計算します。
ほかのすべての点までの距離の合計が最も小さいデータ点を選びます。これが最初の Medoid です。
距離の合計を最も大きく減らすデータ点を加えます。Medoid が k 個になるまで、この手順をくり返します。
SWAP フェーズ
各データ点を、最も近い Medoid のクラスターに割り当てます。
各 Medoid とほかの各データ点について、入れ替えた後の距離の合計を計算します。
最良の入れ替えで距離の合計が減るなら、その入れ替えを行います。そして手順4〜6をくり返します。
距離の合計を減らす入れ替えがなくなったら、止めます。
14個のデータ点で試してみましょう。次のステップをクリックすると、1ステップずつ進みます。グラフの上のラベルには、いまのフェーズと手順の番号が表示されます。SWAP の各ラウンドでは、まず PAM が試すすべての入れ替えを表示します。そのあと最良の入れ替えを行い、各点をもう一度クラスターに割り当てます。
BUILD から始めると、SWAP フェーズの前に Medoid はほぼ正しい位置にあります。SWAP フェーズを長く見たいときは、悪いスタートを選んでください。3つの Medoid がすべて同じグループから始まり、SWAP が3ラウンドかけて直していきます。
入れ替えのたびに、距離の合計は減ります。どの入れ替えでも減らなくなったら、PAM は止まります。悪いスタートからでも、SWAP は BUILD から始めたときと同じ Medoid にたどり着きます。
実在する中心が大切な理由
平均は、極端な値のほうへ動きます。Medoid は行の1つでなければならないので、動きません。下の例では、顧客 G の月間の支出が1,000です。ほかの6人の支出は120〜175です。平均は269まで動き、7人中6人より高い値になります。Medoid は150のまま、顧客 D にとどまります。
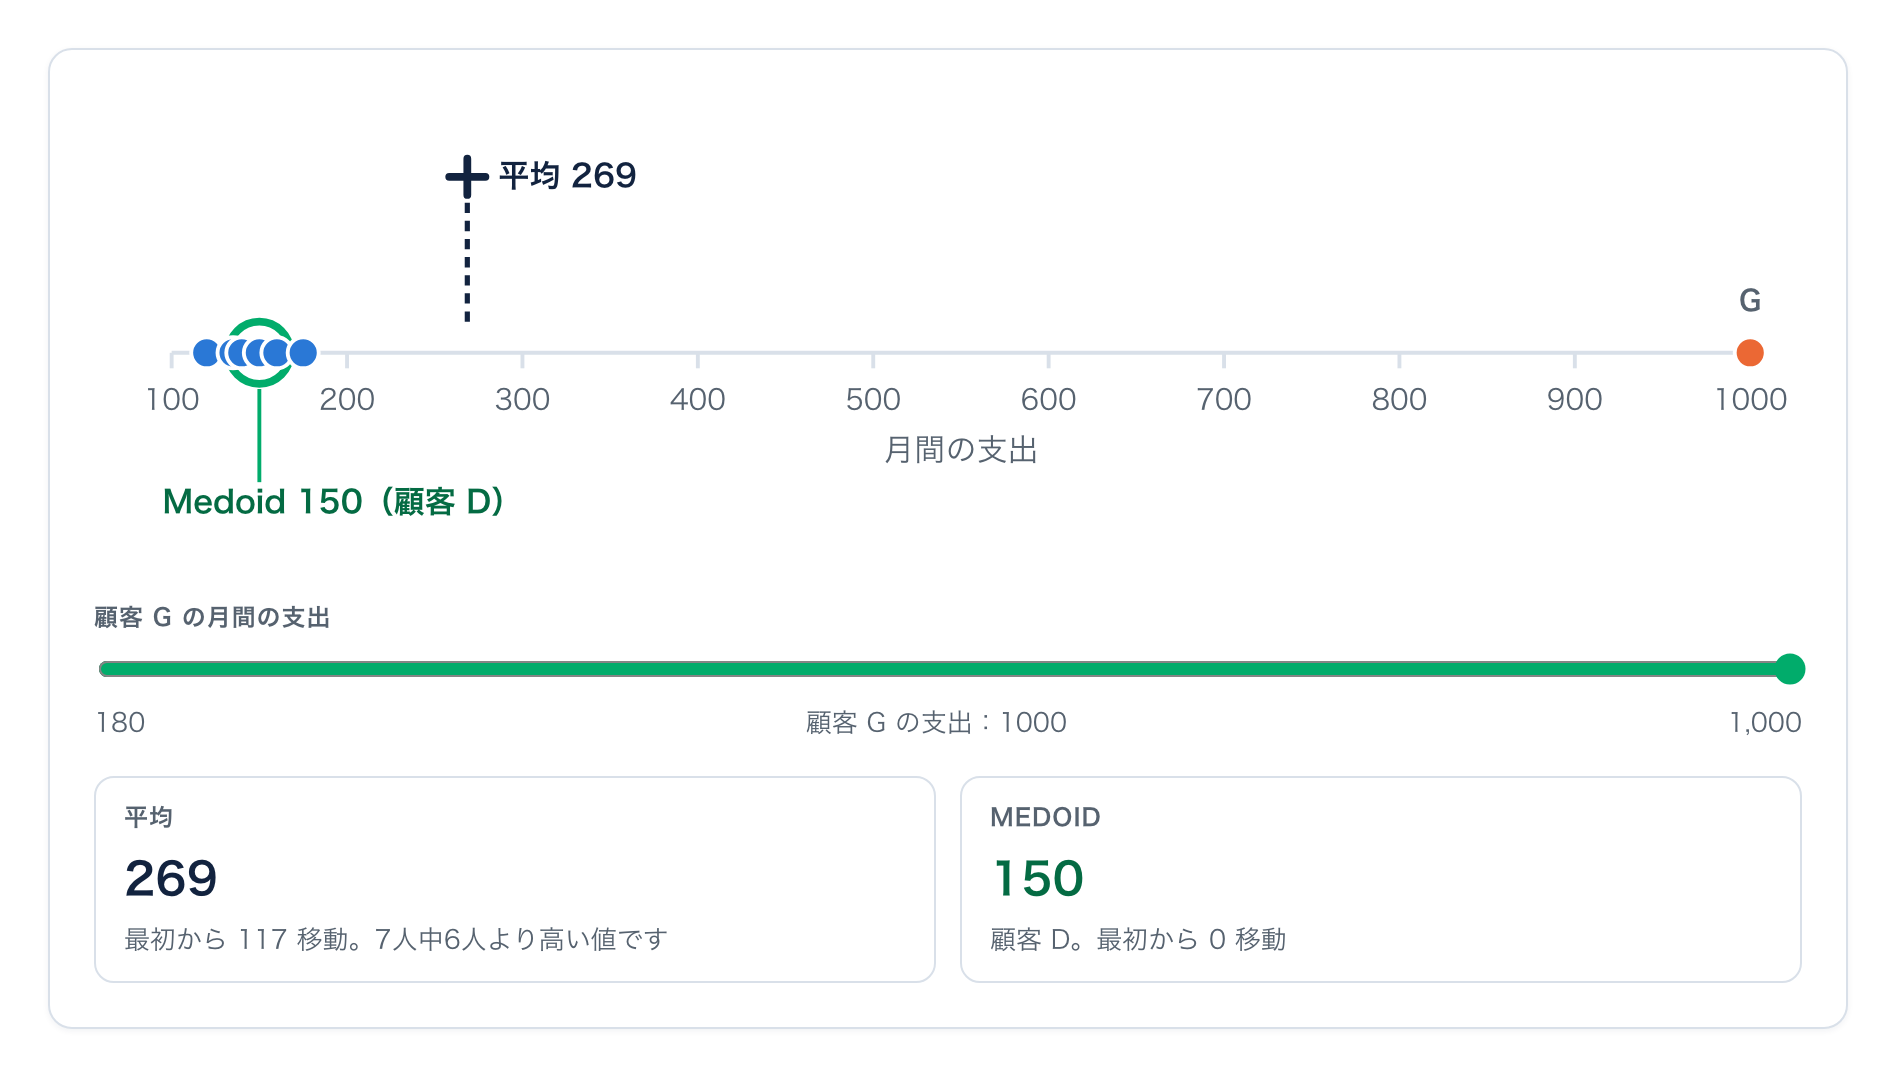
図2. 顧客 G の支出が1,000になると、平均は151から269に動きます。Medoid は150のままです。
クラスターの中心を読む
値が尺度の目盛りのときも、この違いが効いてきます。アンケートの回答者のクラスターを1つ取り上げ、その中心を見てみます。回答者は、3つの質問に1〜5の尺度で答えています。
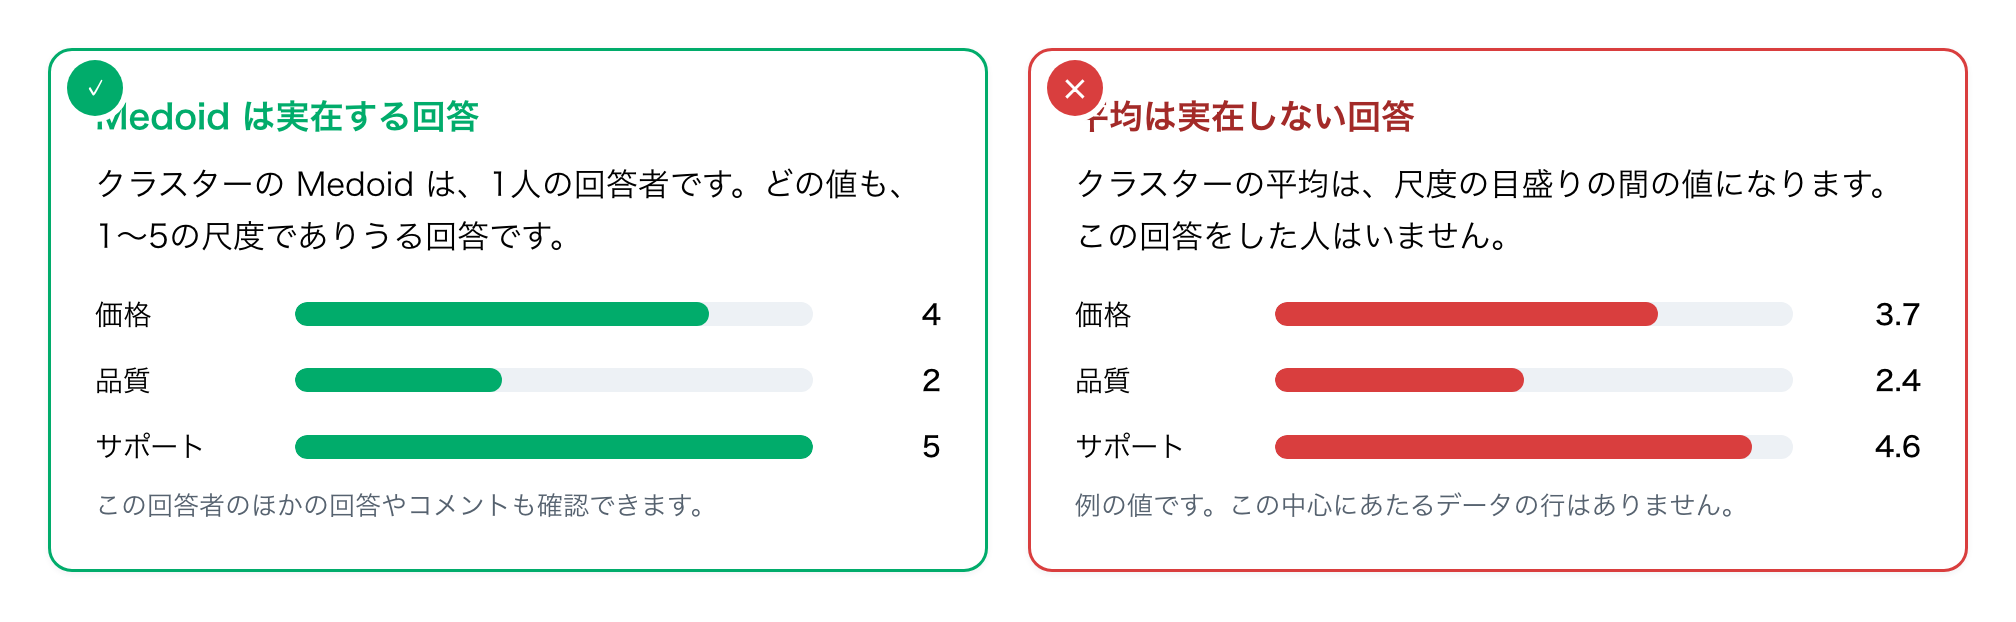
図3. クラスターの Medoid は、ありうる回答をした1人の回答者です。平均は、尺度の目盛りの間の値になります。例の値です。
データに外れ値があるときや、値が尺度の目盛りのときは、K-Medoids を使いましょう。各クラスターの中心が、実在する、ありうる行になります。
マンハッタン距離とユークリッド距離
K-Medoids が使うのは、行どうしの距離だけです。平均は一度も計算しません。そのため、いろいろな距離の測り方を使えます。よく使われるのは、マンハッタン距離とユークリッド距離の2つです。
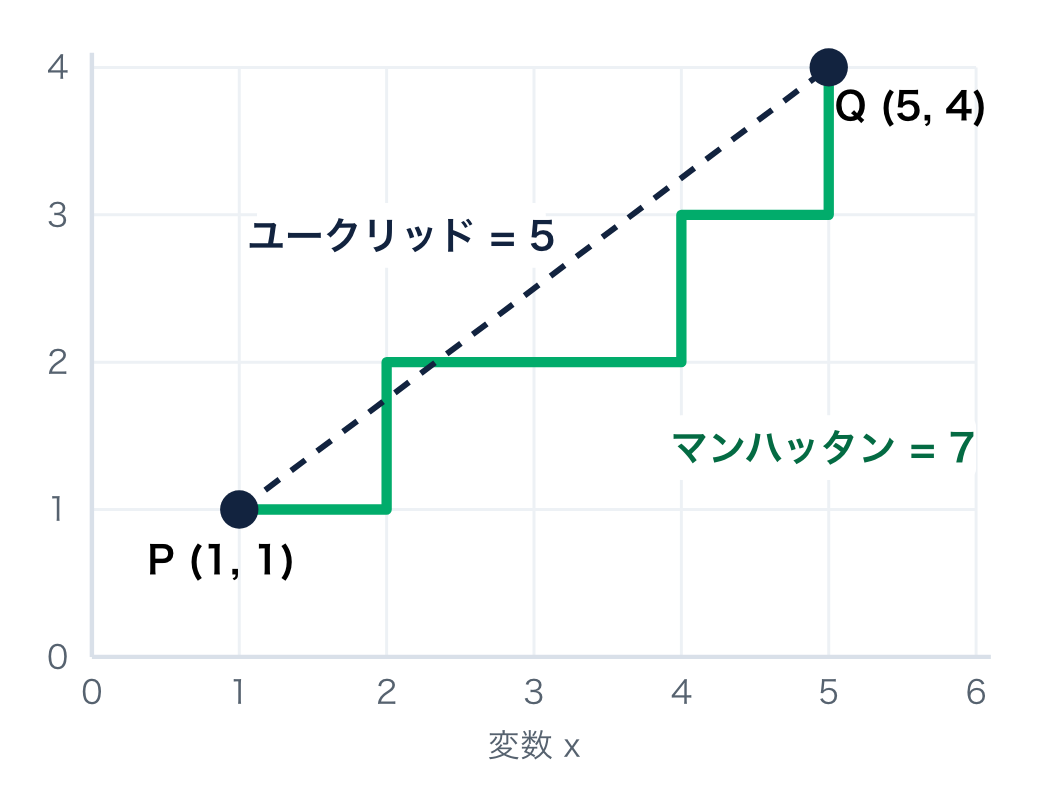
図4. P から Q まで、マンハッタン距離は 4 + 3 = 7、ユークリッド距離は 5 です。
マンハッタン距離は、変数ごとの差の絶対値を足したものです。道のりは、街の通りのように格子に沿って進みます。
\[\begin{aligned} d(P, Q) = |x_2 - x_1| + |y_2 - y_1| \end{aligned}\]ユークリッド距離は、2つのデータ点を結ぶ直線の長さです。
\[\begin{aligned} d(P, Q) = \sqrt{(x_2 - x_1)^2 + (y_2 - y_1)^2} \end{aligned}\]ユークリッド距離は、差をそれぞれ2乗します。そのため、1つの大きな差が大きく効きます。マンハッタン距離は2乗しないので、外れ値の影響が小さくなります。
注意:距離を計算する前に、変数を標準化します。そうすれば、値の大きい変数が結果を左右しません。
外れ値や尺度の値があるデータには、マンハッタン距離を使いましょう。Exploratory のデフォルトもマンハッタン距離です。
クラスターの数をどう決めるか
クラスターの数 k は、分析の前に決めます。k を選ぶには、いくつかの k で分析を実行し、シルエットスコアやエルボー曲線で結果を比べます。
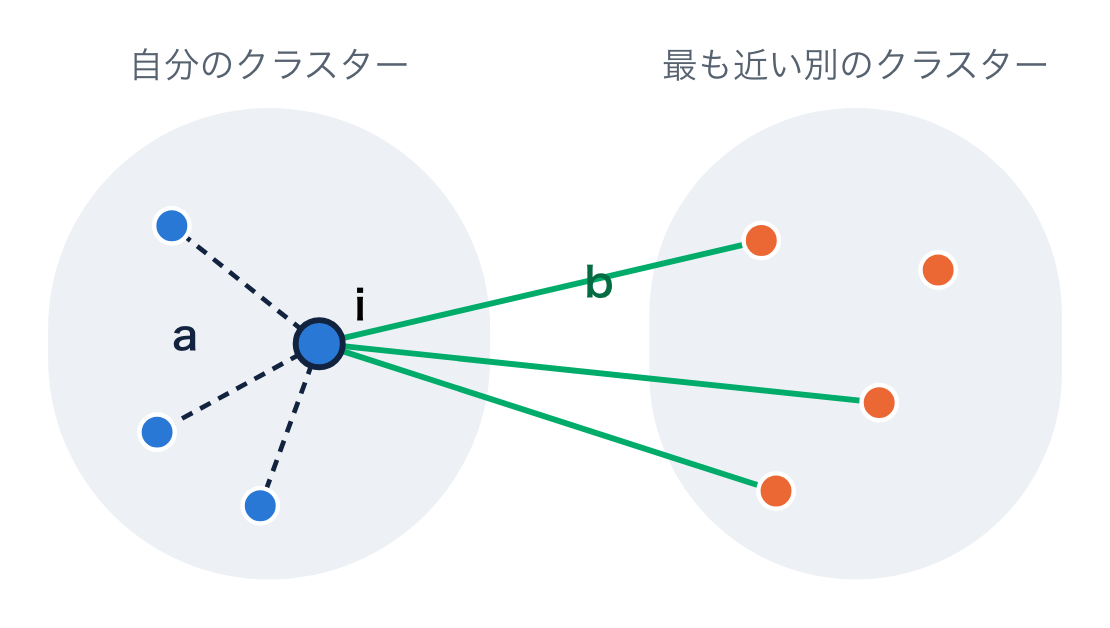
図5. a は点 i から同じクラスターのほかの点までの平均距離、b は最も近い別のクラスターの点までの平均距離です。
1つのデータ点のシルエットスコアは、次の式で求めます。
\[\begin{aligned} s(i) = \frac{b - a}{\max(a, b)} \end{aligned}\]1に近い。その点は、自分のクラスターに近く、ほかのクラスターから離れています。
0に近い。その点は、2つのクラスターの境目にあります。
0より小さい。その点は、別のクラスターのほうに近く、割り当てが誤っている可能性があります。
k ごとに、すべての点のシルエットスコアの平均を計算します。平均が最も高い k か、それに近いスコアで説明しやすいクラスターになる k を選びます。
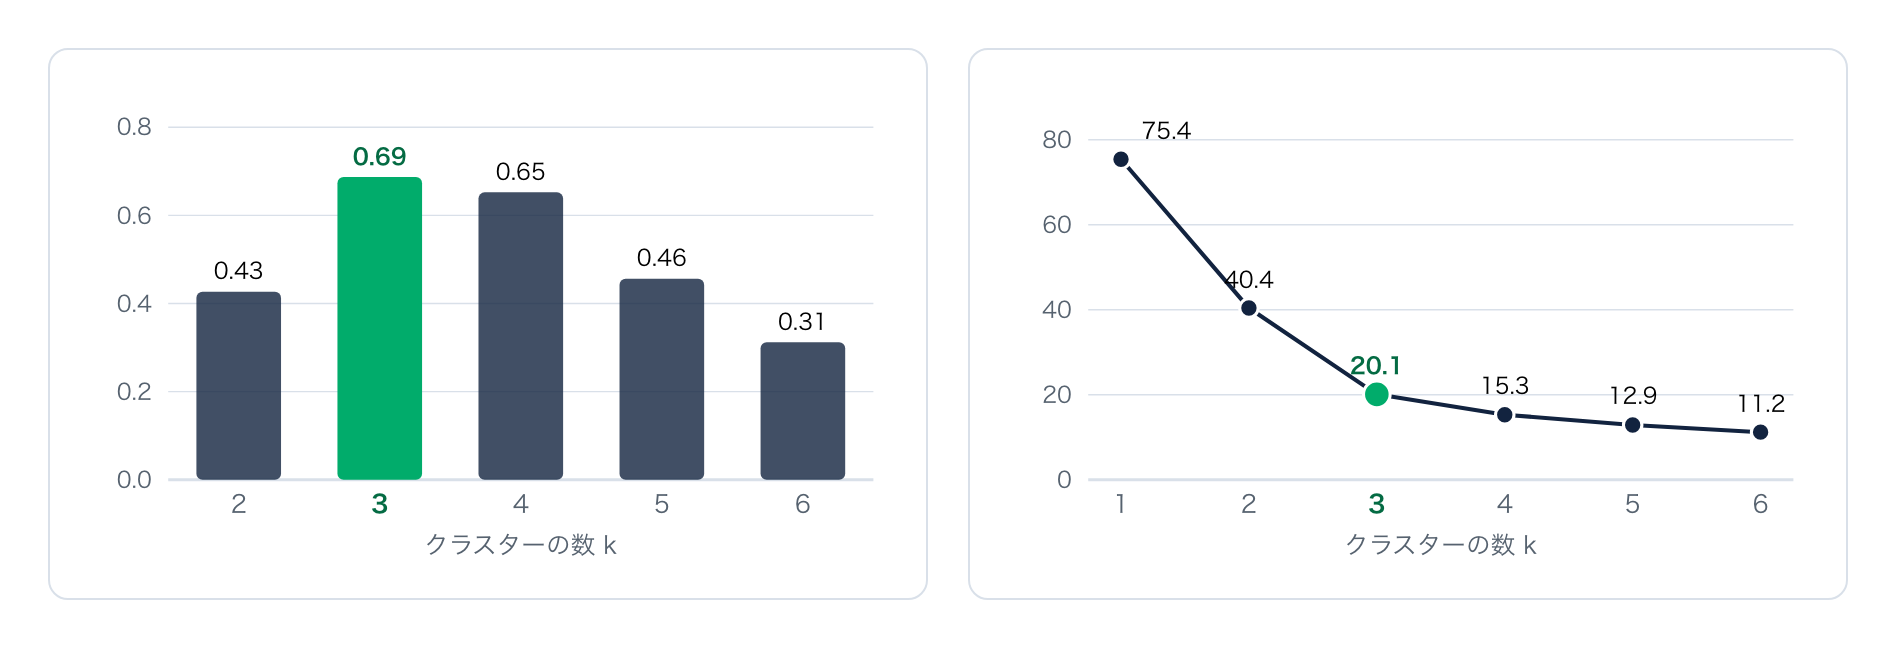
図6. 左:エクスプローラーの14点の平均シルエットスコア。右:Medoid までの距離の合計。どちらもマンハッタン距離です。
エクスプローラーの14点では、k = 3 のシルエットスコアが最も高く、エルボー曲線も k = 3 で曲がります。
大きなデータ:PAM と CLARA
PAM は正確ですが、大きなデータでは時間がかかります。SWAP の各ラウンドで k × (n − k) 通りの入れ替えを調べ、それぞれで n 行すべての距離を使うからです。CLARA(Clustering LARge Applications)は、より速い方法です。行の小さなサンプルで PAM を実行し、すべての行で距離の合計が最も小さくなる Medoid を残します。
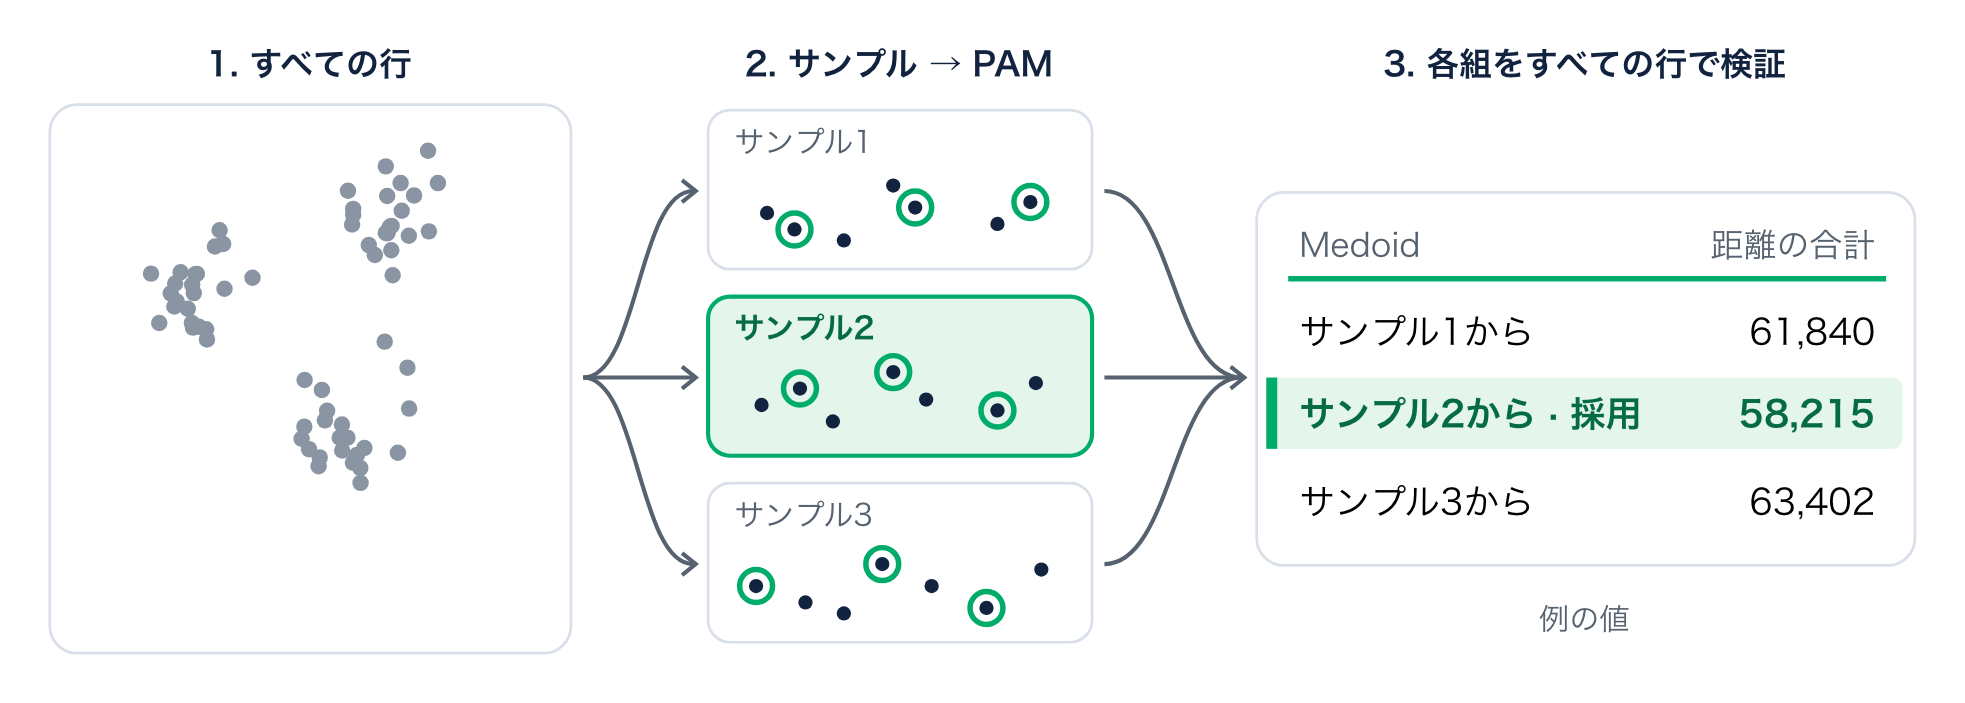
図7. CLARA は小さなサンプルで PAM を実行し、すべての行で距離の合計が最も小さくなる Medoid を残します。距離の合計は例の値です。
| 項目 | PAM | CLARA |
|---|---|---|
| 探索に使うデータ | すべての行。 | 行からランダムに取り出した、いくつかのサンプル。 |
| 結果 | 入れ替えの探索で見つかる、最良の Medoid。 | 近似の結果。サンプルが多いほど、結果が安定します。 |
| 時間 | 行数が増えると、急に長くなります。 | 行数が増えても、ゆるやかに長くなります。 |
| Exploratory(自動、デフォルト) | 有効な行が5,000行以下のときに使います。 | 有効な行が5,000行を超えるときに使います。 |
小〜中規模のデータには PAM、大規模なデータには CLARA を使います。Exploratory では、「自動」の設定がアルゴリズムを選びます。
K-Medoids と K-Means
どちらの手法も、データを k 個のクラスターに分けます。違いは、各クラスターの中心です。次の表を参考に、手法を選んでください。
| 項目 | K-Medoids クラスタリング | K-Means クラスタリング |
|---|---|---|
| クラスターの中心 | Medoid。実在するデータ点です。 | 平均。ふつうはデータ点ではありません。 |
| 距離 | 多くの測り方。Exploratory ではマンハッタン距離とユークリッド距離。 | ユークリッド距離の2乗。 |
| 外れ値 | Medoid への影響は小さい。 | 平均への影響は大きい。 |
| 尺度の値 | 中心は、ありうる回答です。たとえば1〜5の尺度の4。 | 中心が3.7になることがあり、そう答えた人はいません。 |
| 毎回同じ結果 | はい。PAM の BUILD から始める場合。 | いいえ。ランダムな開始点によって結果が変わります。 |
| データの大きさ | PAM で小〜中規模。CLARA で大規模。 | 大規模なデータも扱えます。 |
活用例:アンケートデータ
K-Medoids の最も一般的な活用例は、アンケートデータです。多くのアンケートでは、1〜5の尺度で「そう思う」「そう思わない」を答えてもらいます。これをリッカート尺度と呼びます。回答は順序のあるカテゴリーで、厳密な量ではありません。
下の表は、3つのクラスターに分けた9人の回答者です。各クラスターの1行目が Medoid です。各クラスターの下にある平均は、4.3や1.7のような値になります。この回答をできる人はいません。
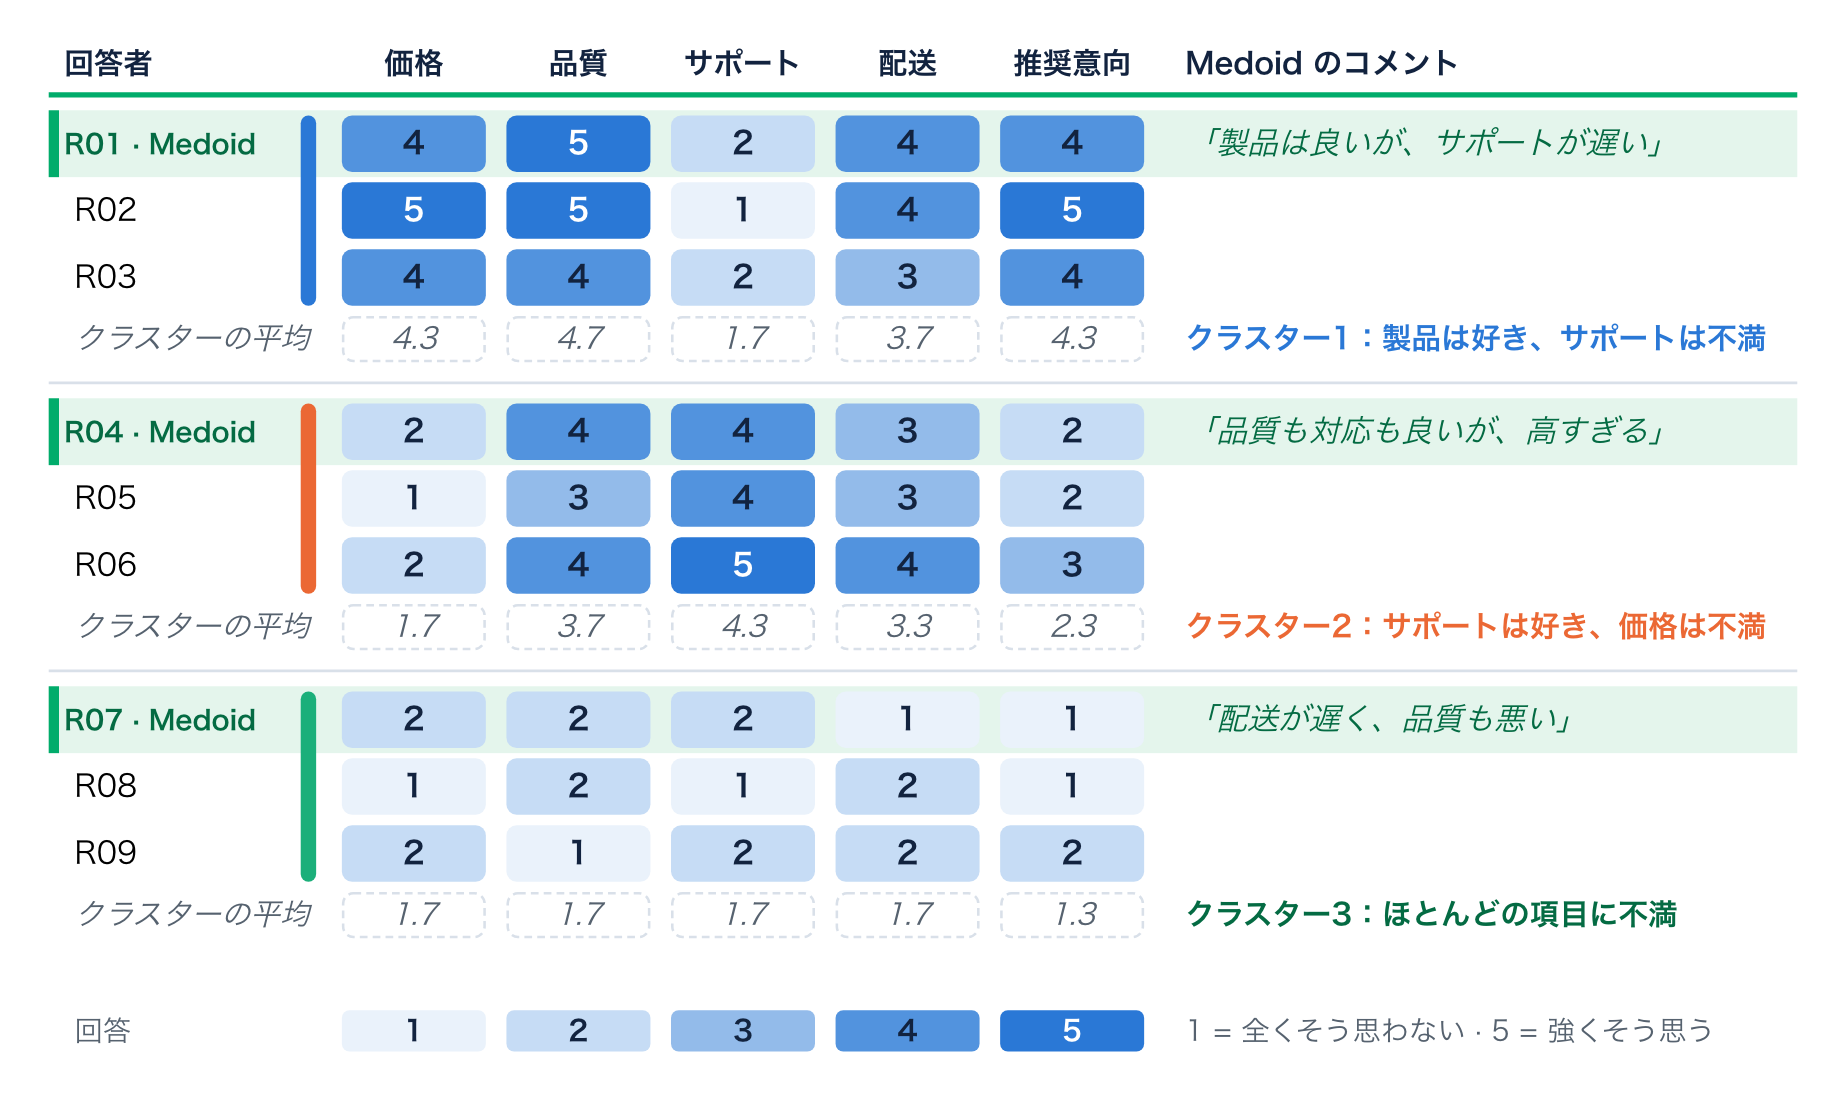
図8. 3つのクラスターに分けた9人の回答者(マンハッタン距離)。各クラスターの Medoid は実在する1人の回答者です。クラスターの平均は、誰も答えられない値になります。例のデータです。
K-Medoids がアンケートデータに向いている理由
実在する回答パターン。Medoid の値は、どれも尺度の目盛りの1つです。Medoid をそのまま報告できます。
2乗ではなく、目盛りの数。マンハッタン距離は、2つの回答の間の目盛りの数を足します。2目盛りの差は、4ではなく2と数えます。
極端な回答者。1だけ、または5だけを選ぶ回答者がいます。Medoid への影響は小さくなります。
実在する1人。Medoid は1人の回答者です。その人のコメントやプロフィールを読めば、クラスターを説明できます。
アンケートデータの準備
回答に数値を付けます。1 = 全くそう思わない 〜 5 = 強くそう思う。
各質問の列が数値型であることを確認します。Exploratory の K-Medoids は、数値の変数だけを受け付けます。
すべての質問の向きをそろえます。否定的な質問は、6 − 回答 を計算します。
すべての質問が同じ尺度なら、変数を標準化する を FALSE にしてもかまいません。すると、距離は尺度の目盛りの数になります。
その他のよくある活用例
K-Medoids は、ほかの分野でも役に立ちます。理由はどれも同じで、中心が実在する行であること、そして外れ値の影響が小さいことです。
| 用途 | データの例 | K-Medoids で得られるもの |
|---|---|---|
| アンケートやフィードバックの分析(最も一般的) | 1〜5の尺度で聞いた顧客満足度、従業員エンゲージメント、製品へのフィードバック。 | ありうる回答としての中心。クラスターごとに実在する1人の回答者。 |
| 外れ値のある顧客セグメンテーション | 支出、注文回数、最後の注文からの日数。ごく一部の顧客が非常に多く支出しています。 | 大口の顧客に引っぱられない中心。セグメントごとに確認できる実在の顧客1人。 |
| 代表的な店舗や拠点 | 売上、規模、場所のデータを持つ店舗や倉庫。 | クラスターごとに実在する1店舗。テスト店舗や、ほかの店舗のモデルとして使えます。 |
| 確認用の典型的なケース | 数値の属性を持つ製品、患者の記録、サポートチケット。 | k 個の平均ではなく、クラスターごとに1つ、読める実在のケースが k 個。 |
| 測定誤差を含むデータ | 急なスパイクを含むセンサーの値。 | スパイクに動かされない Medoid。 |
ほかの手法を使うとき
| データや目的 | 手法 |
|---|---|
| 回答が順序のないカテゴリー。たとえば地域や「はい・いいえ」。 | K-Modes(カテゴリ) |
| 外れ値のない大量の数値データで、中心が実在の行である必要がない。 | K-Means(数値) |
| クラスターの数がわからず、すべてのグループをツリーで見たい。 | 階層クラスタリング |
1〜5の尺度のアンケートデータには、K-Medoids を使いましょう。各クラスターに、典型的な例として実在する回答者がいます。
Exploratory での K-Medoids クラスタリング
Exploratory では、アナリティクスで K-Medoids クラスタリングを使えます。コードを書く必要はありません。Exploratory は、R の cluster パッケージの PAM と CLARA のアルゴリズムを使います。
手順
データフレームのアナリティクス・ビューを開き、新しいアナリティクスを追加します。
タイプのメニューで、クラスタリング分析 › K-Medoids(順序 / 数値) を選びます。
変数に、数値の列を選びます。
設定を開き、クラスターの数を指定します。
実行をクリックします。
クラスター数の選択で、シルエットスコアを比べます。必要なら、クラスターの数を変えて実行し直します。
Medoidの詳細で、各クラスターの Medoid の行を確認します。
結果の見方
例は、コーヒー製品についてのアンケートです。1〜5の尺度で答える16の質問があり、クラスターの数はデフォルトの3です。
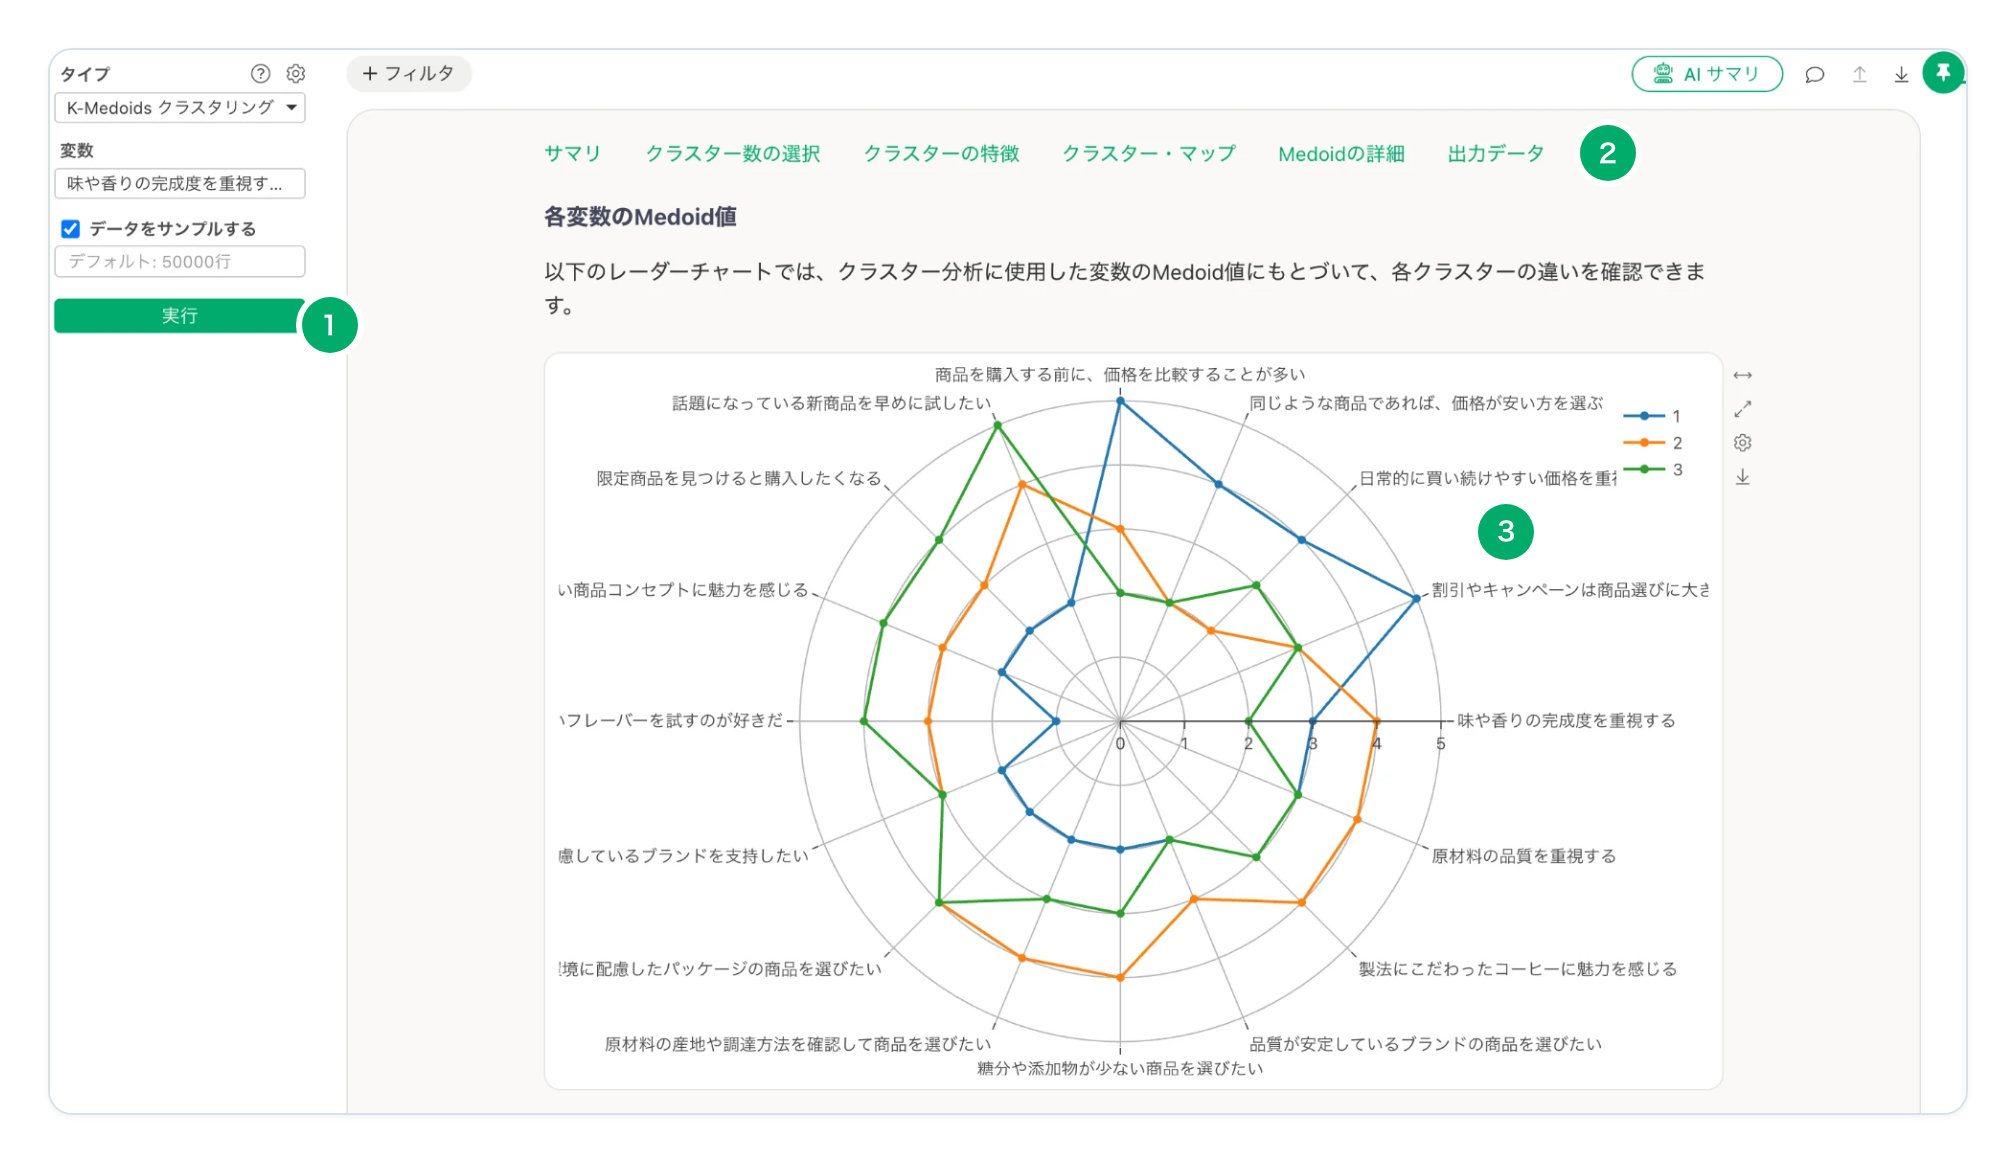
図9. クラスターの特徴 › 各変数のMedoid値。各線は1つのクラスターの Medoid、つまり実在する1人の回答者です。Exploratory の画面。
設定。タイプで K-Medoids クラスタリングを、変数で質問の列を選び、実行をクリックします。
レポートのセクション。レポートには6つのセクションがあります。各セクションの内容は、下の表のとおりです。
Medoid の線。クラスター1の Medoid は、「商品を購入する前に、価格を比較することが多い」と割引やキャンペーンの質問に5を付けています。どの点も実在する回答です。
この例では、クラスター1は価格の質問に高い回答をしています。クラスター2は、原材料の品質や糖分の少なさなど、品質の質問に高い回答をしています。クラスター3は、新商品、新しいフレーバー、限定商品の質問に高い回答をしています。
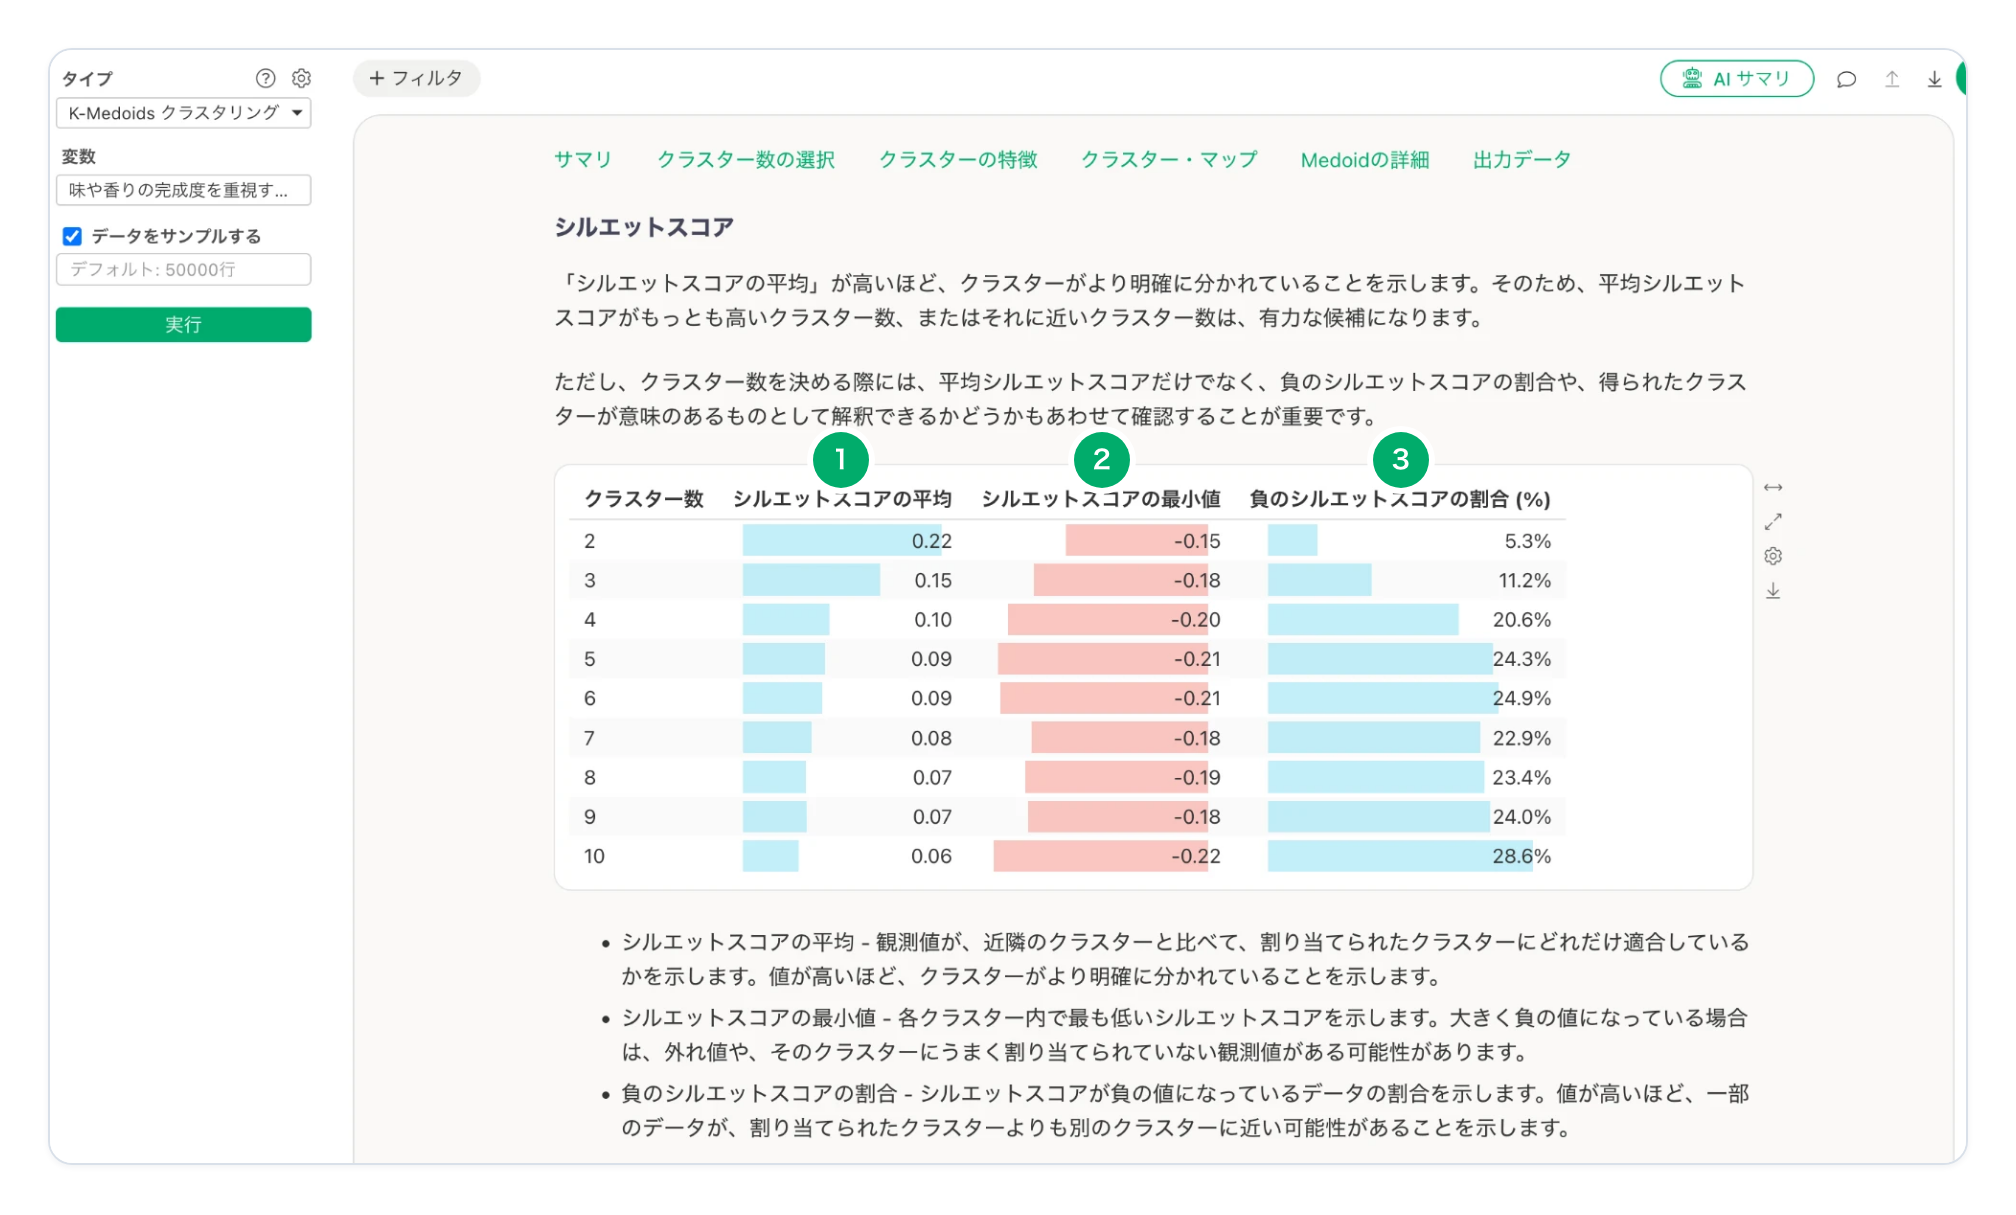
図10. クラスター数の選択 › シルエットスコア(クラスター数2〜10)。Exploratory の画面。
シルエットスコアの平均。クラスター数ごとのシルエットスコアの平均です。ここでは、クラスター数2が最も高く、0.22です。
シルエットスコアの最小値。クラスター数ごとに、回答者1人のシルエットスコアの最も低い値を示します。
負のシルエットスコアの割合 (%)。別のクラスターのほうに近い回答者の割合です。クラスター数2の5.3%から、10の28.6%まで増えます。
注意:アンケートデータは、回答者どうしの回答が重なりやすいため、シルエットスコアが低くなりがちです。スコアだけでクラスターの数を決めないでください。ここでは、クラスター数3のスコアは2より低い(0.15と0.22)ものの、3つのクラスターは「価格」「品質」「新商品」とはっきり説明できます。
レポートの読み方
実行をクリックすると、Exploratory は6つのセクションからなるレポートを表示します。
| レポートのセクション | 内容 |
|---|---|
| サマリ | 分析条件。クラスターごとの行数、比率、Medoidまでの平均距離と最大距離、Medoidの行ID、シルエットスコア。各クラスターのMedoid値。 |
| クラスター数の選択 | シルエットスコア、またはエルボー曲線とばらつきの減少度。 |
| クラスターの特徴 | 各変数のMedoid値と平均値、クラスターの違いを特徴づける変数(η²)、クラスターの代表的な値、クラスター内のばらつき。 |
| クラスター・マップ | クラスタリングの距離から PCoA で求めた、2次元での行の配置。大きな点が Medoid です。 |
| Medoidの詳細 | 各クラスターの Medoid の行。 |
| 出力データ | 各行と、そのクラスター、Medoidであるか、Medoidまでの距離、シルエットスコア。 |
まずはデフォルトのまま使いましょう。マンハッタン距離、自動のアルゴリズム、変数の標準化です。そのうえで、シルエットスコアを見てクラスターの数を選びます。
まとめ
K-Medoids は、データに実在する行(Medoid)を各クラスターの中心にします。
PAM は BUILD で最初の Medoid を選び、SWAP で距離の合計が減るかぎり Medoid を入れ替えます。
外れ値は Medoid にほとんど影響しません。マンハッタン距離を使うと、その影響はさらに小さくなります。
シルエットスコアを比べつつ、説明できるクラスターの数を選びます。
1〜5の尺度のアンケートデータでは、各 Medoid が、ありうる回答パターンを持つ実在の回答者になります。
Exploratory で試してみる
K-Medoids クラスタリングを、お手持ちのデータで Exploratory を使って試してみてください。
👉 最新版の Exploratory をダウンロード
https://exploratory.io/download
Exploratory のアカウントをまだお持ちでない場合は、こちらからサインアップして、30日間の無料トライアルを始められます。
トライアルの期間が終わっている場合は、最新版を起動して「トライアルを延長」をクリックすると、もう一度お試しいただけます。