大学IRって何? 新しくIR担当になった人のための基本と仕事の進め方
「4月からIR担当になりました。でも、IRって結局何をする仕事なんでしょうか?」
大学の方とお話ししていると、こうした声をよく耳にします。いまでは多くの大学にIR室や評価室、あるいはIRを担当する部署や委員会がありますが、その役割は大学によってさまざまです。ある大学では認証評価の資料づくりが中心で、別の大学では学生アンケートの集計が中心。学内からは「データを出してくれる部署」と見られていて、依頼された数字を出すだけで一年が終わってしまう、という話も珍しくありません。
この記事では、新しくIR担当になった教職員の方、IRの立ち上げや立て直しを考えている大学執行部の方に向けて、大学IRとは何か、どんな業務があり、どう進めるとうまくいくのかを、できるだけ具体的にお話ししたいと思います。
大学IRとは
IRは「Institutional Research(インスティテューショナル・リサーチ)」の略です。日本語では「機関調査」と訳されることもありますが、ひと言でいえば、大学が自分自身について、データを集め、分析し、その結果を意思決定や改善につなげる活動のことです。
学生がどのように学び、どこでつまずき、どんな成果を上げて卒業していくのか。入学してくる学生はどんな層で、入試の区分によって入学後の様子に違いはあるのか。こうした問いに、勘や経験だけでなくデータで答えようとするのがIRです。
IRはもともと米国の大学で発展してきた考え方で、日本でも、大学が自らの教育の質を点検し改善していく「内部質保証」や、認証評価への対応といった流れの中で、IRの機能を整える大学が増えてきました。文部科学省や中央教育審議会が示している教学マネジメントの考え方の中でも、データに基づいて教育を点検・改善していくことの大切さが繰り返し語られています。(リンク)
ここで大事なのは、IRの目的は「データを集計すること」そのものではない、という点です。集計や分析は手段であって、目的は大学の意思決定や教育・学生支援の改善に役立てることにあります。
なぜ今、大学IRが大事なのか
大学IRへの関心が高まっている背景には、いくつかの流れがあります。
一つ目は、内部質保証と認証評価です。内部質保証とは、大学が自らの教育の質を自分たちで点検し、改善し続ける仕組みのことです。外部の評価機関が定期的に大学をチェックする認証評価でも、この仕組みが機能しているかどうかが重視されています。そのとき「改善しています」と言うだけでなく、何をもとにそう判断したのかを示す必要があります。その根拠となるデータを整え、分析するのがIRの重要な役割です。
二つ目は、学修成果の可視化です。学生が大学で何を身につけたのかを、成績やGPA、アンケート、各種の調査などを組み合わせて示すことが求められるようになっています。単位を取ったかどうかだけでなく、どんな力がどれくらい伸びたのかを、学内外に説明できることが大切になってきました。
三つ目は、学生支援です。休学や退学に至る学生の中には、成績や出席、アンケートの回答などに早い段階で兆しが表れているケースもあります。データから傾向をつかむことで、支援が必要な学生に早めに手を差し伸べる取り組みにつなげることができます。
四つ目は、入試・学生募集です。18歳人口が減っていく中で、どんな学生がどの入試区分から入学し、入学後にどう学んでいるのかを把握することは、多くの大学にとって切実なテーマになっています。
IRの主な業務と、答えようとする「問い」
IRの業務は大学によって異なりますが、多くの大学で共通しているのは次のような領域です。
学生アンケート・授業評価:学生は授業や大学生活に満足しているか。学部や学年によって違いはあるか。自由記述にはどんな声が多いか。
成績・GPA・学修成果:科目や学部ごとの成績分布はどうなっているか。入試区分によって入学後の成績に違いはあるか。年度を追ってどう変化しているか。
自己点検評価・認証評価:毎年の指標はどう推移しているか。目標に対して、どこまで達成できているか。その根拠をどう示すか。
学内データブック・ダッシュボード:在籍者数、休学率、退学率、卒業率などの基本的な指標を、学内の誰もが同じ数字で確認できるか。
入試・学生募集:志願者・合格者・入学者はどう推移しているか。地域や出身高校、入試区分による違いはあるか。
学生支援・休学・退学:休学や退学に関係していそうな要因は何か。どんな学生に、どのタイミングで支援が必要か。
こうして並べてみると分かるように、IRの業務は一つひとつが「問い」とセットになっています。アンケートを集計すること自体が業務なのではなく、「学生は何に満足していて、何に困っているのか」という問いに答えることが業務なのです。
IRの仕事の流れ
どの領域であっても、IRの仕事はおおむね次のような流れで進みます。
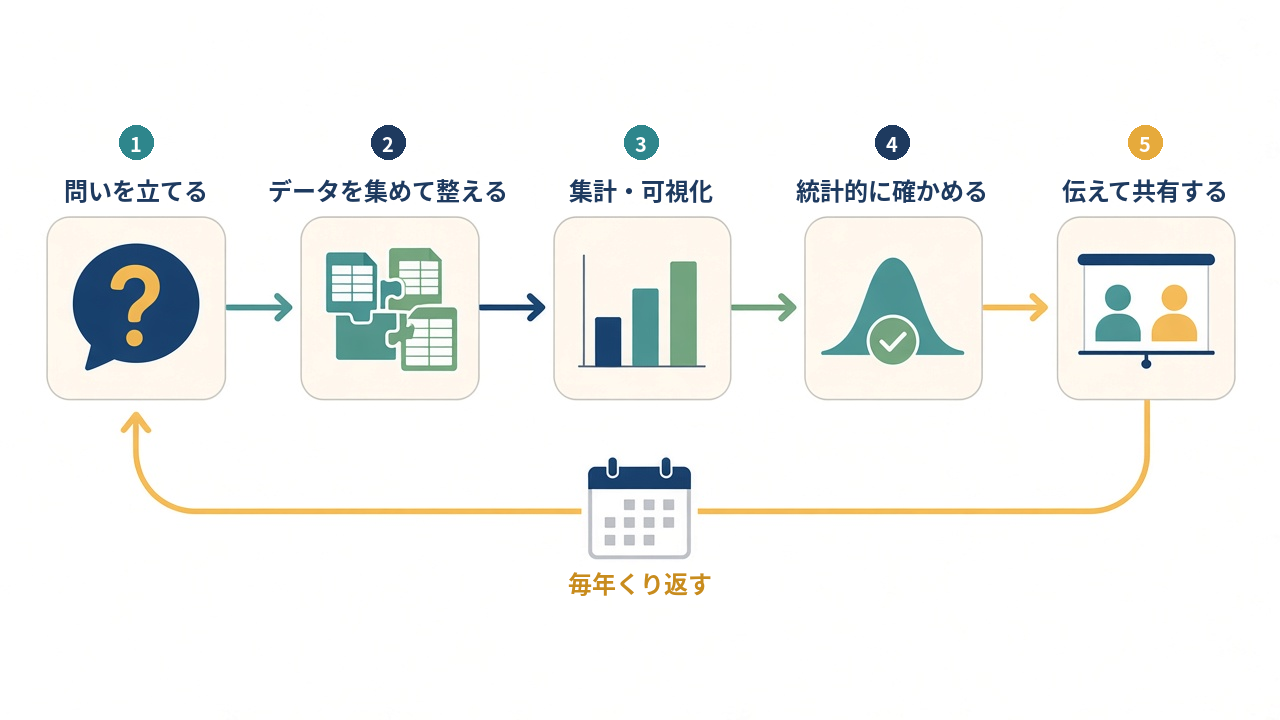
まず、問いを立てるところから始まります。「初年次の学生の満足度は学部によって違うのか」「出席率やGPAは翌年度の退学と関係しているのか」といった、答えるべき問いを明確にします。執行部や教員と話しながら、何を知りたいのか、その結果を何に使うのかをすり合わせておくことが大切です。
次に、データを集めて、結合・整形します。実際には、ここに一番時間がかかります。教務システム、入試のデータ、アンケートの結果などは、それぞれ別のシステムから別の形式で出てきます。学部名の表記が年度によって違っていたり、欠損値があったりもします。学籍番号をキーにして複数のデータを結びつけ、分析できる形に整えていく作業です。
データが整ったら、集計・可視化をします。学部別・学年別・年度別といった切り口で集計し、チャートにして傾向を見ていきます。
そして、見えてきた傾向が本当に意味のあるものなのかを、統計的に確かめます。たとえば、ある学部の満足度の平均が他の学部より少し高かったとしても、それが偶然のばらつきの範囲なのか、意味のある差なのかは、平均値を並べただけでは分かりません。仮説検定や回帰分析などを使って確かめることで、より確かな根拠をもって議論できるようになります。
分析の結果は、伝えて共有します。レポートやダッシュボードにまとめて、執行部や教員、関係部署に届けます。このとき、数字やグラフを並べるだけでなく、そこから何が読み取れるのか、どんな改善の可能性があるのかを添えることが大切です。
最後に、毎年更新します。IRの分析の多くは一回きりでは終わりません。学生アンケートも成績分布も認証評価の指標も、毎年、毎学期くり返し作ることになります。
この流れを通して忘れたくないのは、集計表やレポートを作ることがゴールではない、ということです。ゴールは、その結果をもとに学内で改善の議論が生まれ、実際の取り組みにつながることです。
IRでよくぶつかる壁
IRの現場でお話をうかがうと、多くの大学で似たような壁にぶつかっていることが分かります。
まず、毎年同じ作業を一から繰り返さなくてはいけないという壁です。学内システムから出力したCSVをExcelで加工し、学部別・年度別の表を手作業で作る。翌年度になると、また同じ作業を最初からやり直す。こうした作業に時間を取られて、肝心の分析や解釈にまで手が回らない、という声をよく聞きます。
次に、手順が残らず、人事異動で失われるという壁です。大学では職員の異動が定期的にあります。Excelの集計表は残っていても、それをどう作ったのかが残っていない。「前の担当者に聞いてください」で引き継ぎが終わってしまい、同じ分析を再現できなくなる。これはIRを続けていくうえで、とても大きなリスクです。
三つ目は、自由記述を読み切れないという壁です。授業評価や学生アンケートの自由記述には、学生の生の声が詰まっています。しかし件数が多いと全部を読むのは大変ですし、担当者が手作業で分類すると、その判断が人によってぶれてしまうこともあります。
四つ目は、平均の差が統計的に意味があるのか分からないという壁です。平均値を比べた表を作ることはできても、その差をどう解釈してよいのか判断しにくい。結果として「少し高い」「少し低い」という印象論で議論が終わってしまうことがあります。
五つ目は、学内で広く共有できないという壁です。せっかく分析をしても、IR室の中や一部の役職者にしか届かなければ、改善の議論はなかなか広がりません。
そして六つ目が、個人情報の扱いです。IRで扱うデータの多くは、学生一人ひとりの成績や回答といった、慎重に扱うべき情報です。誰がどのデータを使ってよいのか、どこまで見せてよいのかが曖昧なままだと、分析そのものに踏み出しにくくなります。
うまくいくIRのポイント
では、こうした壁を乗り越えて、IRをうまく回していくにはどうすればよいのでしょうか。どんなツールを使うかに関係なく大切だと思うポイントを、いくつかお話しします。
問いから始める。 「データがあるから集計する」のではなく、「何を知りたいのか」「その結果を誰が何に使うのか」から始めることです。問いがはっきりしていれば、集めるべきデータも、見るべき切り口も自然と決まってきます。逆に問いがないまま集計を始めると、たくさんの表はできても、議論にはつながりにくくなります。
作り方を残す。 完成した集計表だけでなく、どのデータをどう加工し、どう集計したのかという手順を残しておくことです。手順が残っていれば、翌年度は同じ手順を新しいデータに当てはめるだけで済みますし、担当者が変わっても引き継ぐことができます。IRを「個人の頑張り」ではなく「組織の仕組み」にするための、一番の土台だと思います。
平均だけでなく、分布とばらつきを見る。 平均値は便利な指標ですが、それだけでは見えないことがたくさんあります。同じ平均点でも、全員がそこそこの成績なのか、よくできる学生とつまずいている学生に二極化しているのかで、取るべき対策はまったく違います。分布やばらつきを見たうえで、差が偶然の範囲を超えているのかを統計的に確かめる。この習慣があるだけで、議論の質は大きく変わります。
小さく始めて、毎年更新できる形にする。 最初から全学のあらゆるデータを網羅しようとすると、なかなか前に進めません。まずは学生アンケートのレポートなど、毎年必ず作るものを一つ選び、それを翌年度も同じように更新できる形にする。一つうまく回るようになったら、次のテーマに広げていく。そのほうが結果的に早く、確実に進みます。
学内で共有して、ともに考える。 IRは、IR室だけで完結する仕事ではありません。データを見た教員や職員から「この学科のこの数字はなぜだろう」という疑問が出てくることこそが、改善の出発点になります。「データを作って渡す」のではなく、「データを見ながら一緒に考える」関係をつくることを目指したいところです。
データの扱い方をルール化する。 どのデータを分析の対象にするのか、個人を特定できる情報をどう除外・匿名化するのか、誰にどこまで見せるのか。こうしたルールをあらかじめ決めておくことで、安心してデータを使えるようになります。ルールがあることは、分析を縛るものではなく、むしろ分析を前に進めるための土台です。
Exploratoryでできること
最後に、私たちExploratoryが大学IRのためにご提供していることを、簡単にご紹介させてください。
Exploratoryでは、データの取り込みから加工、集計・可視化、統計分析、レポート作成、ダッシュボードでの共有までを、一つの環境で行うことができます。主なポイントは次のとおりです。
作り方がステップとして残る:データに対して行った加工や集計がすべてステップとして記録されます。翌年度はデータを差し替えて再実行するだけで、担当者が変わっても、ステップ・ダイアグラムで処理の流れを確認しながら引き継げます。
自由記述をAIで分類・要約:AI関数で自由記述の分類・要約・センチメント分析ができ、その結果は新しい列として学部別・年度別などに集計できます。なお、AIを使わなくても、テキスト分析や統計分析を行うことができます。
統計分析をGUIで:回帰分析、決定木、仮説検定、因子分析などをプログラミングなしで実行できます。
学内で広く共有:閲覧者への追加課金はありません。セッション・パラメーターを使えば、一つのダッシュボードを共有しながら、ログインした人ごとに表示するデータを切り替えることもできます。
実際にExploratoryをすでに使われている多くの大学では、IR業務の大きな改善の声をよく聞かせていただきます。例えば、山形大学では、ExcelやAccess、R、BIツールを行き来していたIR業務をExploratoryにまとめ、半年かかっていた業務を約10日にまで短縮されました。
「処理の手順がステップとして残ることは、業務を継続していくうえで大きな財産です」
また、Exploratoryでは、実際のIR業務に近いテーマで、週1回ペース、4〜8週間かけて一緒に分析の仕組みをつくる無料導入支援サービスや、30日間の無料トライアルもご用意しています。
大学IR向けの活用方法や事例、無料導入支援サービスについては、こちらのページで詳しくご紹介しています。