リッカート尺度(5段階・7段階評価)の分析方法:集計・可視化から統計分析まで
アンケート調査では、「非常に満足」から「非常に不満」までの5段階評価や、「非常にそう思う」から「まったくそう思わない」までの7段階評価などがよく使われます。
このような段階的な評価を使った回答形式は、一般的にリッカート尺度(Likert Scale)と呼ばれています。
リッカート尺度は、顧客満足度調査、従業員エンゲージメント調査、ブランド調査、意識調査など、さまざまなアンケートで利用されています。
しかし、回答を集めた後、どのように分析すればよいのでしょうか。
例えば、次のような疑問があります。
- 「満足している」と答えた人は何%いるのか?
- どの評価項目が高く、どの項目が低いのか?
- 男性と女性では、満足度に違いがあるのか?
- その違いは統計的に有意なのか?
- 顧客満足度と関連する要因は何か?
- 複数の質問に共通する、回答者の潜在的な価値観や意識を見つけられるのか?
こうした疑問に答えるには、分析の目的に応じて適切な方法を選ぶことが重要です。
この記事では、リッカート尺度の基本的な考え方から、回答分布の集計、平均値、Top 2 Box、クロス集計、統計検定、相関分析、因子分析まで、実際のアンケートデータを例に解説します。
1. リッカート尺度(Likert Scale)とは?
リッカート尺度とは、回答者の態度や意見、評価などを、順序のある複数の選択肢によって測定する方法です。
例えば、商品やサービスの満足度を調べる場合、次のような5段階評価が使われます。
| 評価 | 回答 |
|---|---|
| 5 | 非常に満足 |
| 4 | やや満足 |
| 3 | どちらでもない |
| 2 | やや不満 |
| 1 | 非常に不満 |
同様に、7段階評価では「非常に満足」と「やや満足」の間などに追加の選択肢を設け、より細かい評価を取得します。
こうした評価形式は、満足度だけでなく、次のような質問にも使われます。
同意度:「このブランドは信頼できる」という意見に、どの程度同意しますか?
重要度: 商品を購入する際、価格をどの程度重視しますか?
購入意向: 今後、この商品を購入したいと思いますか?
従業員エンゲージメント: この会社で働き続けたいと思いますか?
いずれも、回答者の考えや態度を段階的に測定するという点で共通しています。
リッカート尺度は「順序尺度」
リッカート尺度を分析する際に理解しておきたいのが、順序尺度(Ordinal Scale)という考え方です。
順序尺度とは、値の大小や順番には意味があるものの、隣り合う値の間隔が等しいとは限らないデータのことです。
例えば、5段階評価では「非常に満足」は「やや満足」よりも高い満足度を表します。
しかし、「非常に満足」と「やや満足」の心理的な距離が、「やや満足」と「どちらでもない」の距離と同じとは限りません。
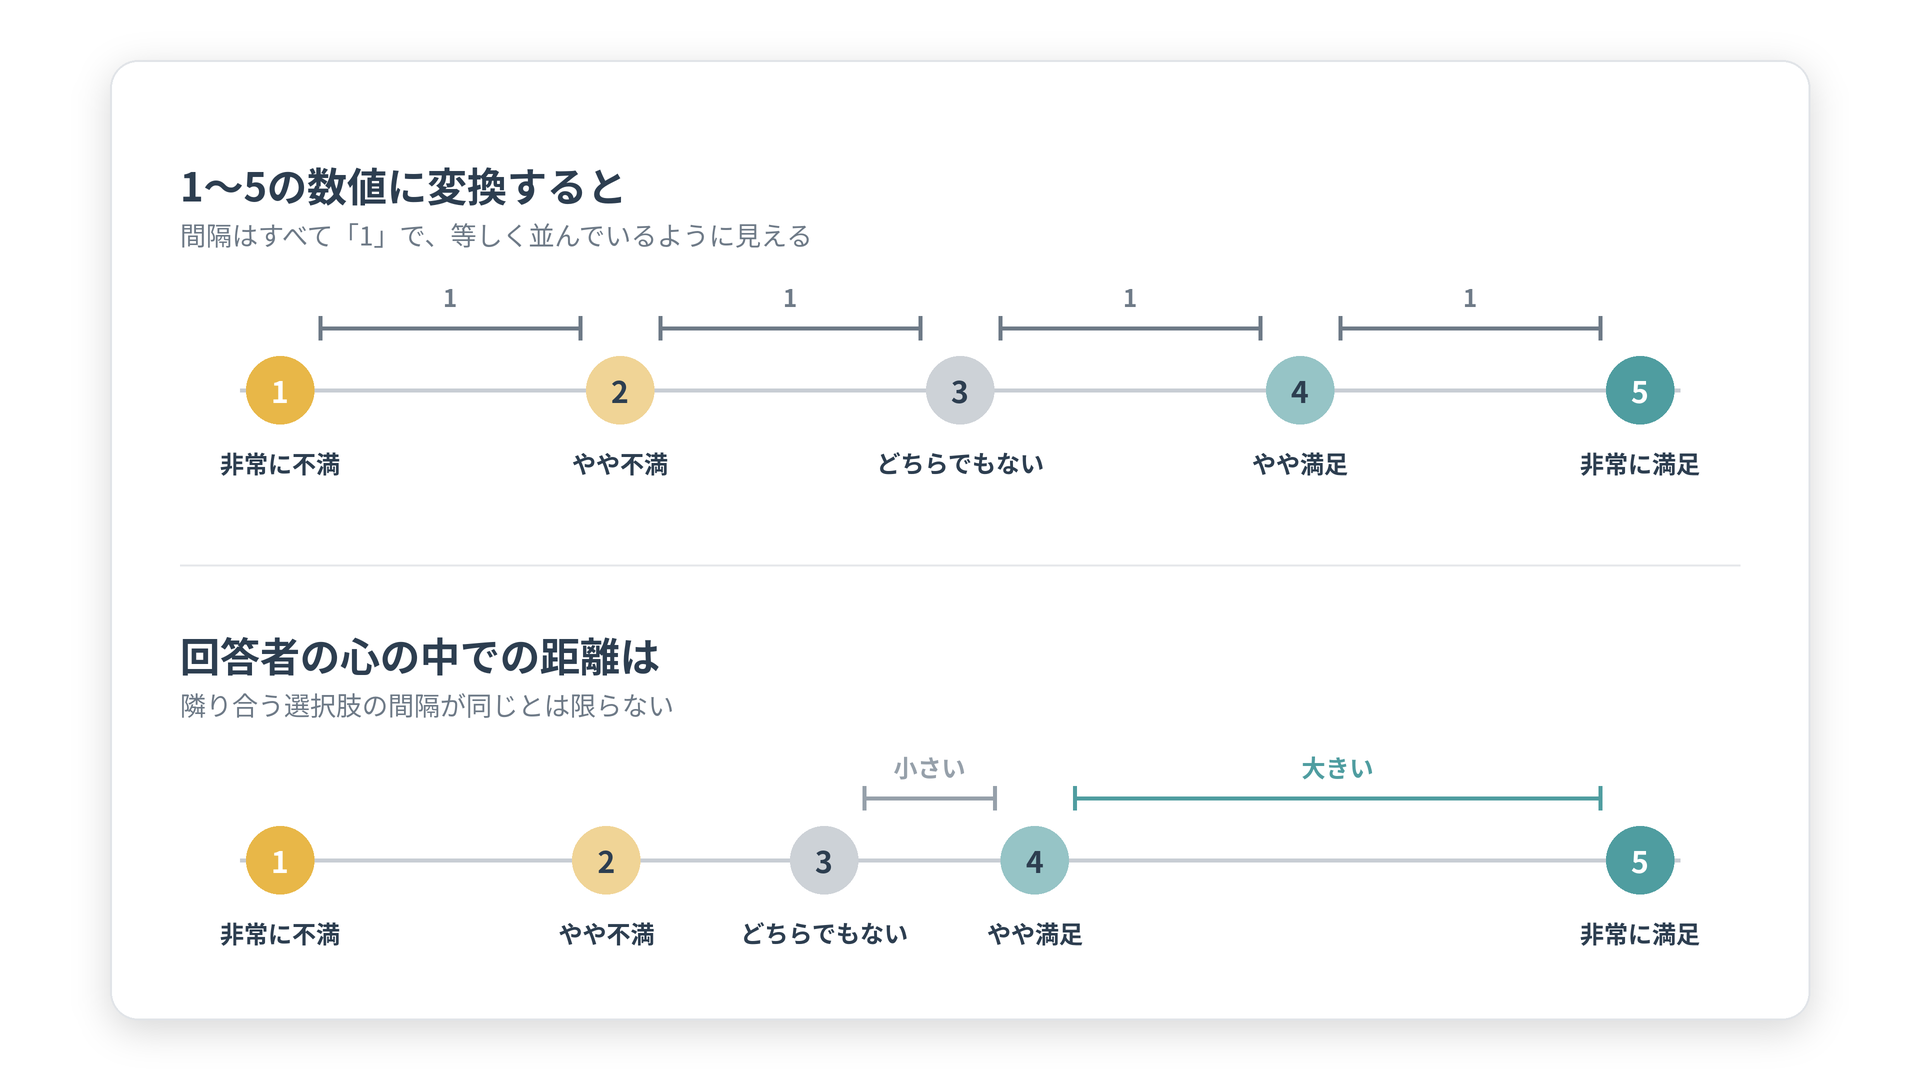
つまり、回答を1から5の数値に変換したとしても、身長や売上金額のような連続した数値とまったく同じ性質を持つわけではありません。
この特徴は、後ほど説明する平均値の計算、相関分析、統計検定などの方法を選ぶ際に重要になります。
1つの質問と、複数の質問を組み合わせた尺度
厳密には、リッカート形式の1つの質問(Likert Item)と、複数の質問を組み合わせた尺度(Likert Scale)は区別されます。
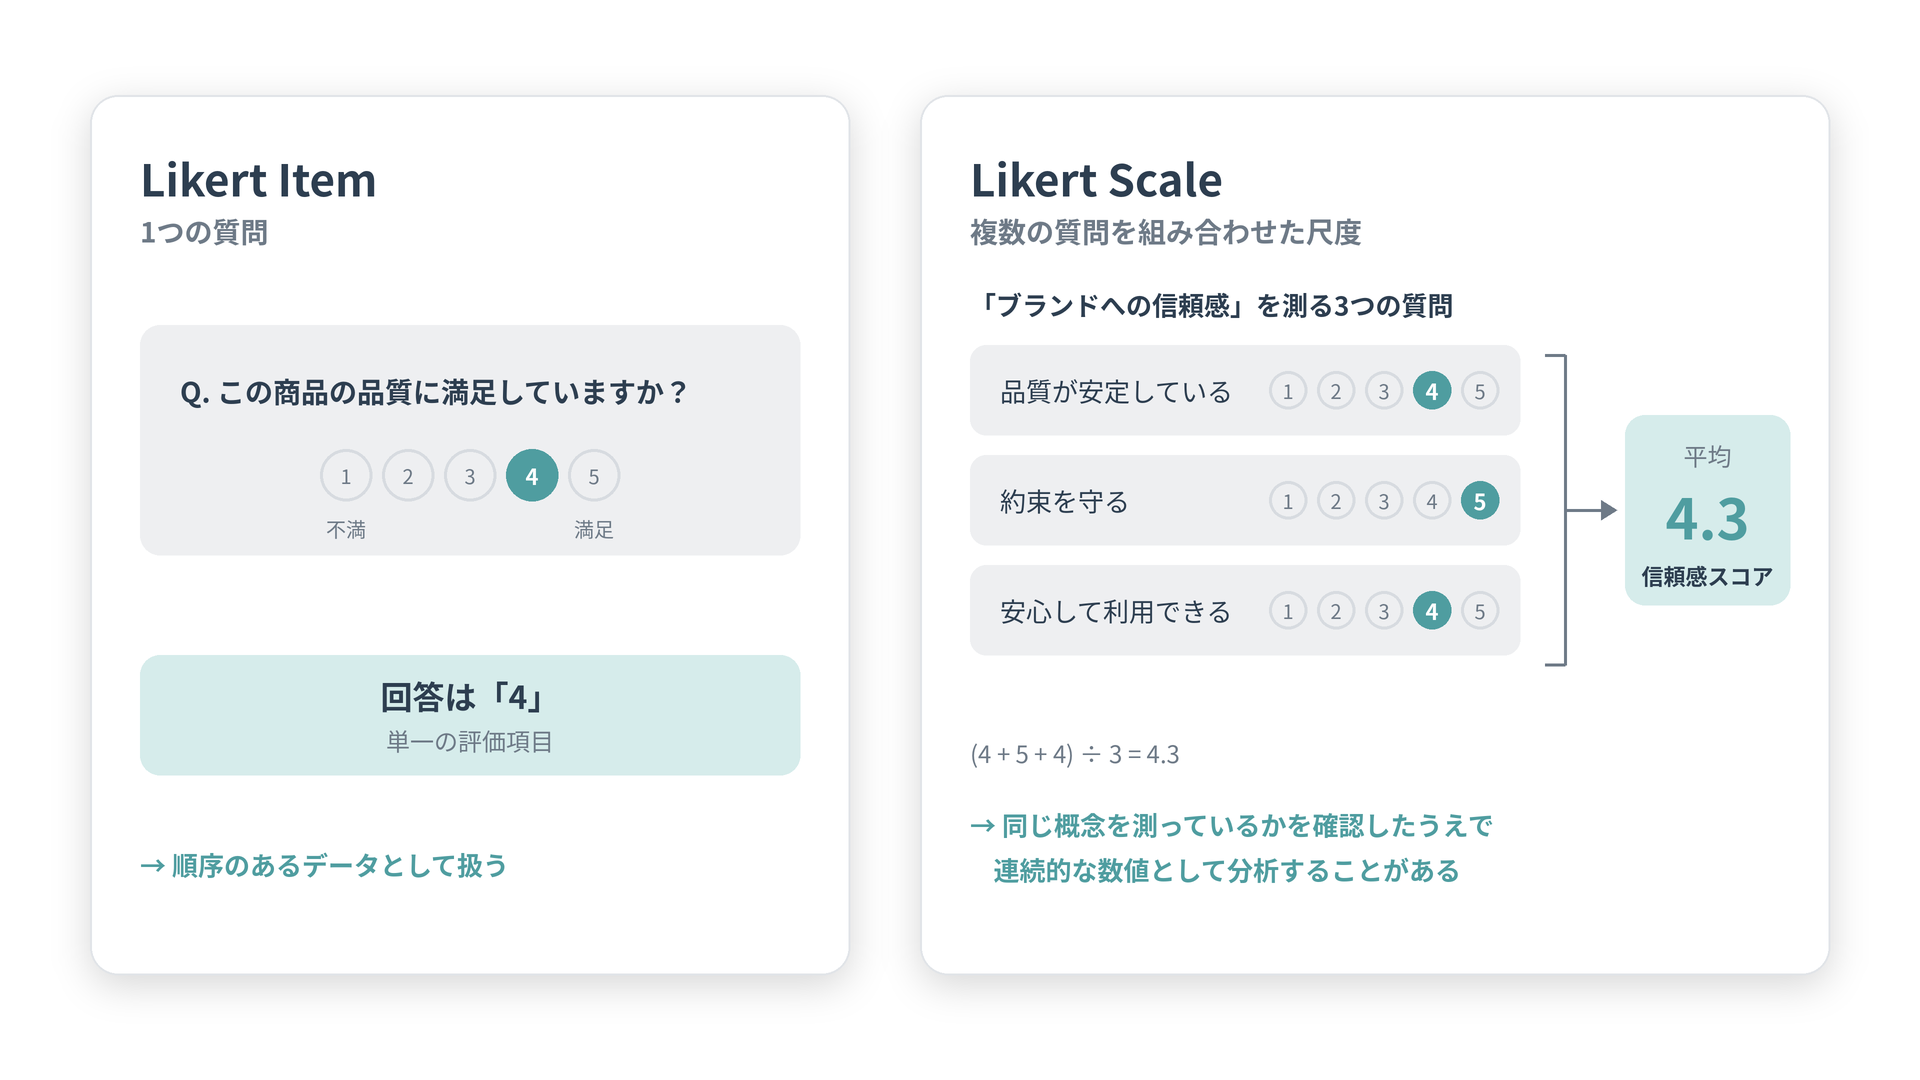
例えば、「この商品の品質に満足していますか?」という1つの質問に対する5段階評価は、単一の評価項目です。
一方、ブランドに対する信頼感を測定するために、「品質が安定している」「約束を守る」「安心して利用できる」といった複数の質問を用意し、それらを合計または平均して1つのスコアにまとめる場合があります。
後者では、複数の質問が同じ概念を測定しているかを確認したうえで、合成したスコアを連続的な数値として分析することがあります。
この違いを理解しておくと、適切な分析方法を選びやすくなります。
2. リッカート尺度データの分析方法:目的別の全体像
リッカート尺度のデータには、さまざまな分析方法があります。
ただし、すべてのデータに同じ分析方法を使うのではなく、何を知りたいのかによって適切な方法を選ぶことが重要です。
代表的な分析目的と手法を整理すると、次のようになります。
| 知りたいこと | 分析方法 |
|---|---|
| 回答がどのように分布しているか | 度数・割合の集計 |
| 肯定的、否定的な回答がどれくらいあるか | Top 2 Box / Bottom 2 Box |
| 全体的な評価が高いか、低いか | 中央値・平均値 |
| 性別や年代によって評価が違うか | クロス集計 |
| グループ間の違いが統計的に有意か | カイ二乗検定・比率の検定・順位検定など |
| 評価項目同士に関連があるか | 相関分析 |
| 満足度と関連する要因は何か | 回帰分析・順序ロジスティック回帰 |
| 複数の質問に共通する要因は何か | 因子分析 |
| 複数の質問が一貫した尺度を構成しているか | 信頼性分析 |
| 回答パターンが似ている人を分類したい | クラスタリング・潜在クラス分析 |
基本的には、次の順序で分析を進めると理解しやすくなります。
ステップ1:回答の傾向を理解する
まず、各選択肢に何人が回答したのか、その割合は何%なのかを確認します。
ステップ2:グループ間の違いを理解する
次に、性別、年代、地域、顧客セグメントなどによって、回答傾向に違いがあるかを調べます。
ステップ3:回答の背景にある関係や構造を理解する
さらに、相関分析や回帰分析、因子分析などを使い、評価項目同士の関係や、満足度と関連する要因を調べます。
それでは、それぞれの方法について具体的に見ていきましょう。
3. 回答分布を集計・可視化する
リッカート尺度の分析で、最初に行いたいのが回答分布の確認です。
どれほど高度な統計分析を行う場合でも、まず回答者が各選択肢をどのように選んでいるかを理解することが大切です。
3.1 回答数と割合を集計する
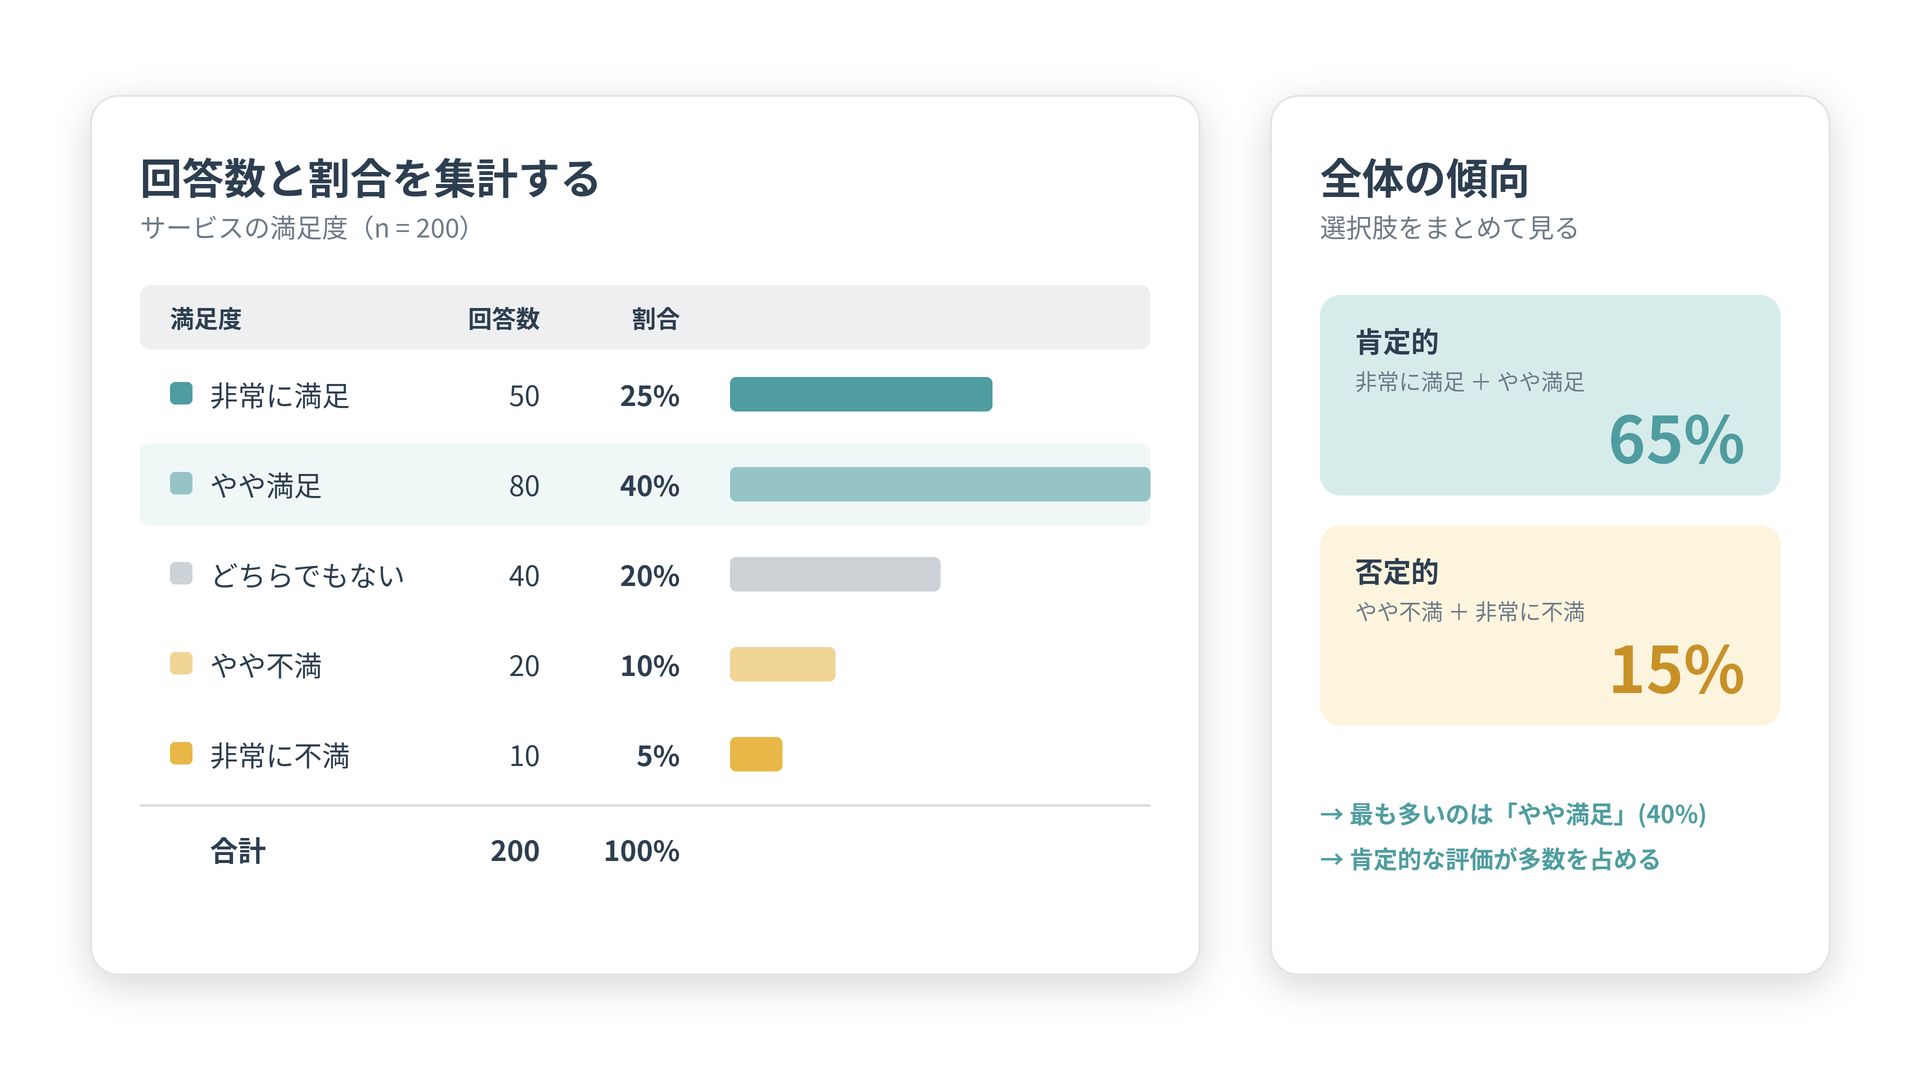
例えば、あるサービスについて200人に満足度を尋ねたところ、次のような回答が得られたとします。
| 満足度 | 回答数 | 割合 |
|---|---|---|
| 非常に満足 | 50 | 25% |
| やや満足 | 80 | 40% |
| どちらでもない | 40 | 20% |
| やや不満 | 20 | 10% |
| 非常に不満 | 10 | 5% |
| 合計 | 200 | 100% |
この表から、最も多かった回答は「やや満足」で、全体の40%を占めていることがわかります。
また、「非常に満足」と「やや満足」を合わせると65%となり、肯定的な評価をしている人が多数を占めています。
一方、「やや不満」と「非常に不満」を合わせた割合は15%です。
このように、単純な集計だけでも、全体的な評価の傾向を把握できます。
3.2 棒グラフで回答分布を可視化する
回答分布をより直感的に理解するには、棒グラフが役立ちます。
横軸に回答カテゴリ、縦軸に回答数または割合を設定することで、どの回答が多いかを一目で確認できます。
ここで重要なのが、回答カテゴリを意味のある順序で並べることです。
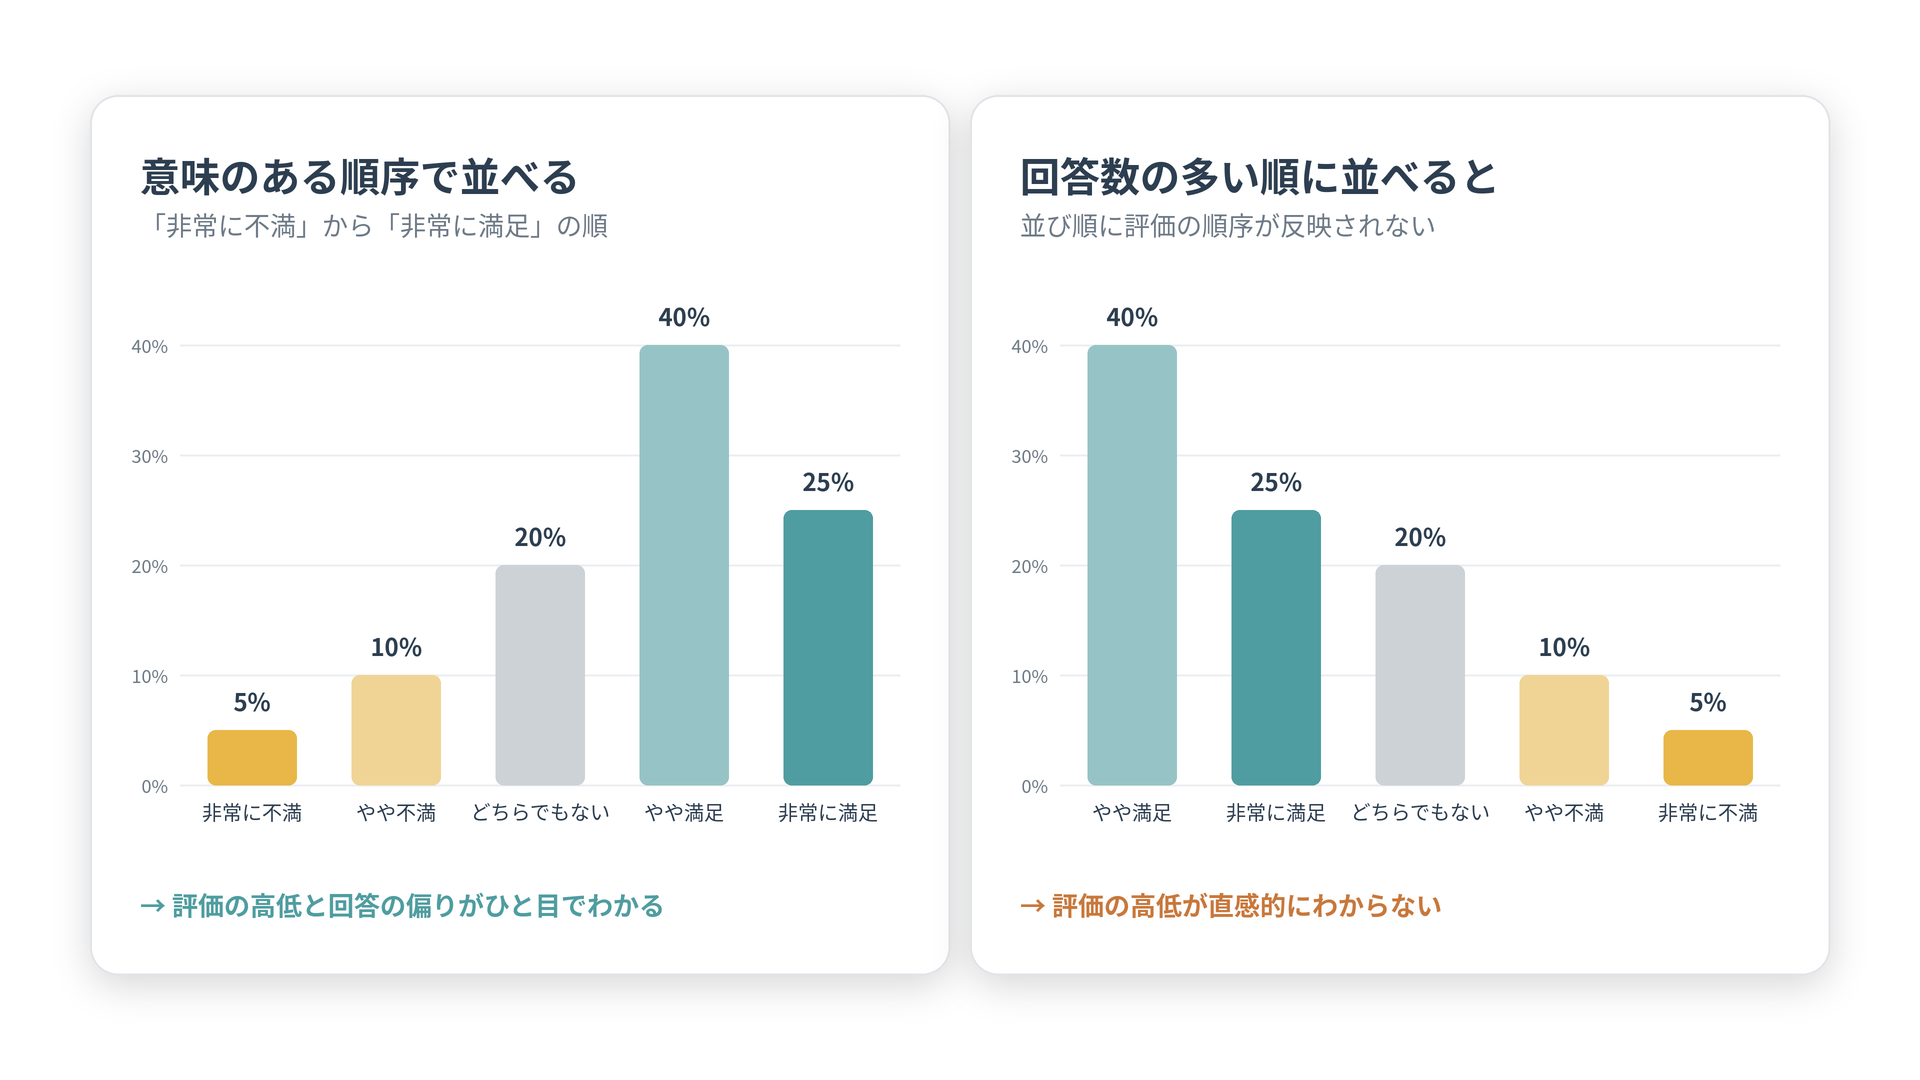
「非常に不満」から「非常に満足」、あるいはその逆の順序で表示すると、回答の傾向を理解しやすくなります。
回答数の多い順や文字列のアルファベット順に並べてしまうと、評価の高低が直感的にわからなくなるため、注意が必要です。
3.3 複数の質問を比較するときは100%積み上げ棒グラフ
顧客満足度調査では、総合満足度だけでなく、商品の品質、価格、サポート、使いやすさなど、複数の項目を評価することがあります。
このような場合に便利なのが、100%積み上げ棒グラフです。
各項目について、回答カテゴリの割合を1本の棒グラフで表すことで、複数の項目の回答分布を比較できます。
さらに、肯定的な回答を右側、否定的な回答を左側、中立的な回答を中央に配置する発散型積み上げ棒グラフも、リッカート尺度の可視化に適した方法です。
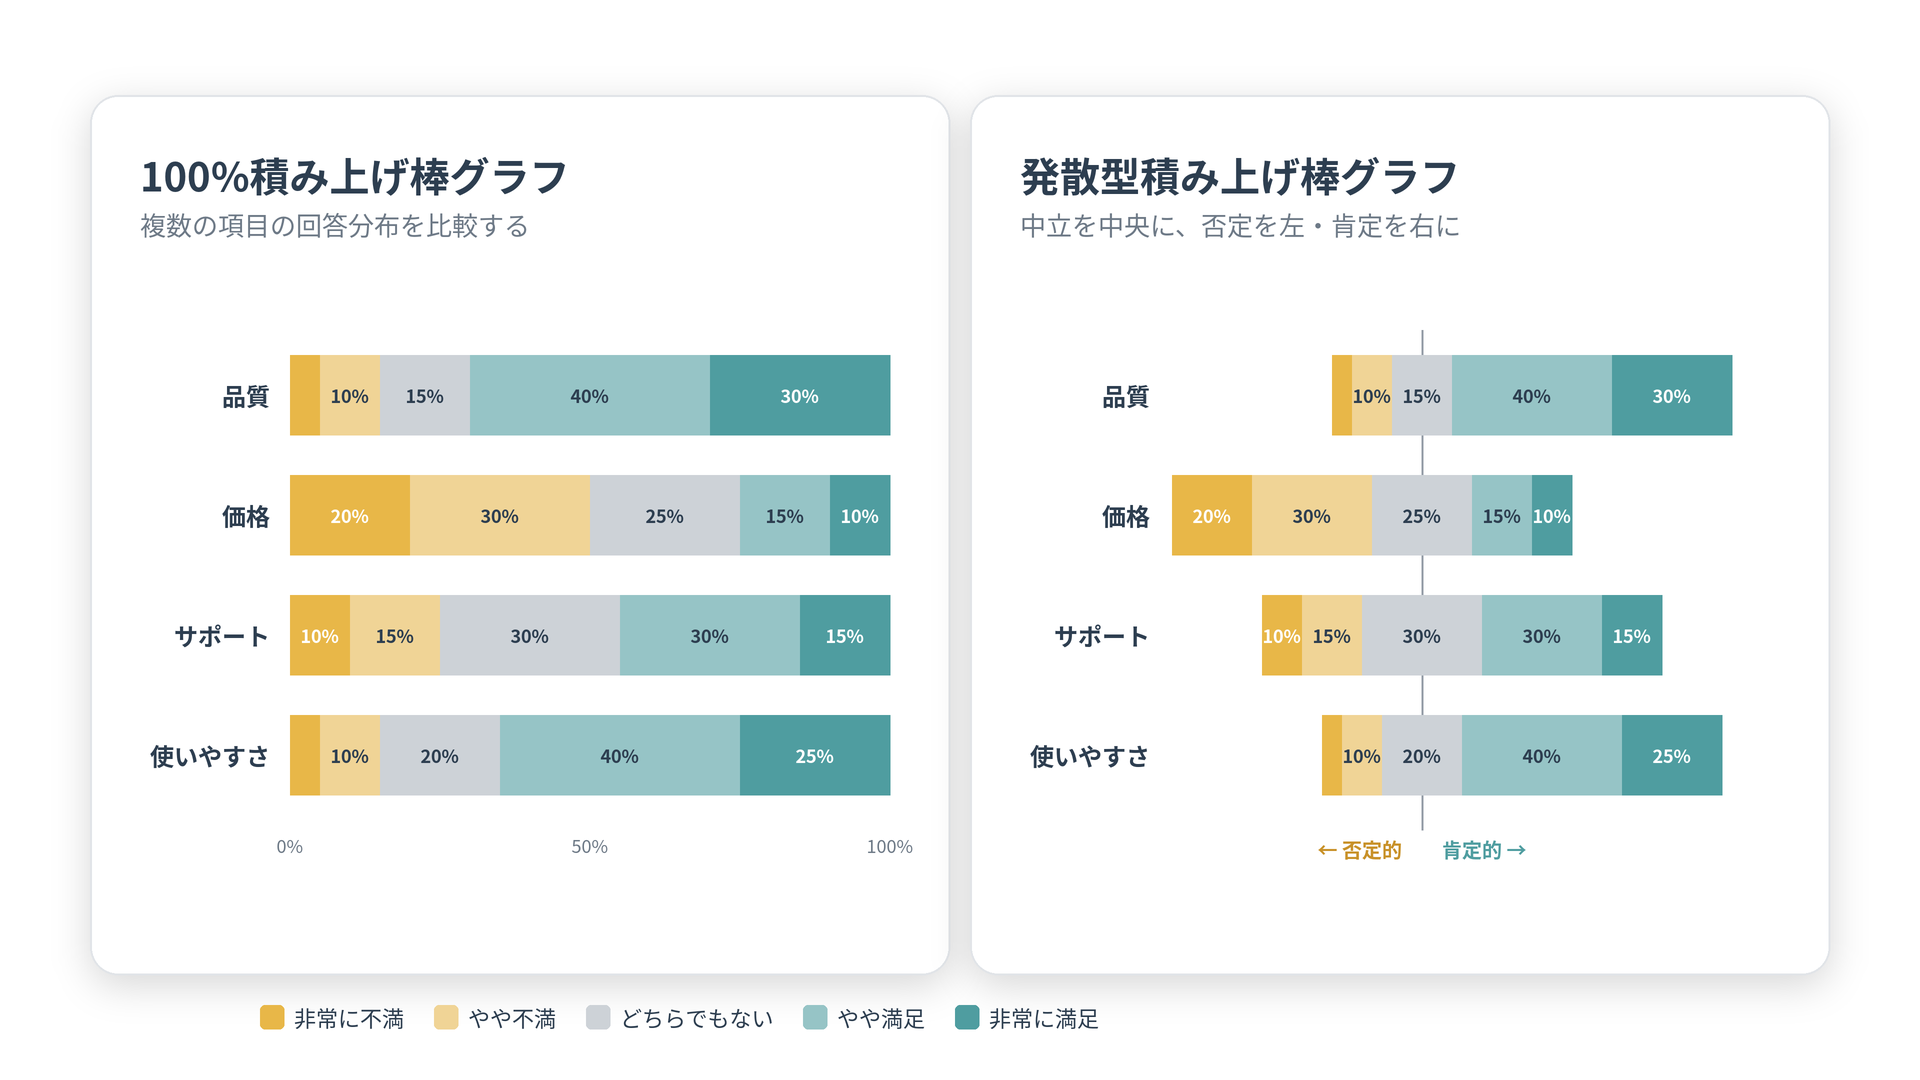
このグラフでは、肯定と否定のバランスを項目ごとに比較しやすくなります。
例えば、品質に対しては肯定的な回答が多いものの、価格に対しては否定的な回答が多いといった特徴を、視覚的に捉えることができます。
4. 平均値、中央値、Top 2 Boxで評価を要約する
回答分布を確認した後は、評価を1つの代表的な数値にまとめたいことがあります。
例えば、複数の商品を比較したり、顧客満足度の推移を追跡したりする場合です。
代表的な方法には、中央値、平均値、Top 2 Boxなどがあります。
4.1 中央値・最頻値で評価を要約
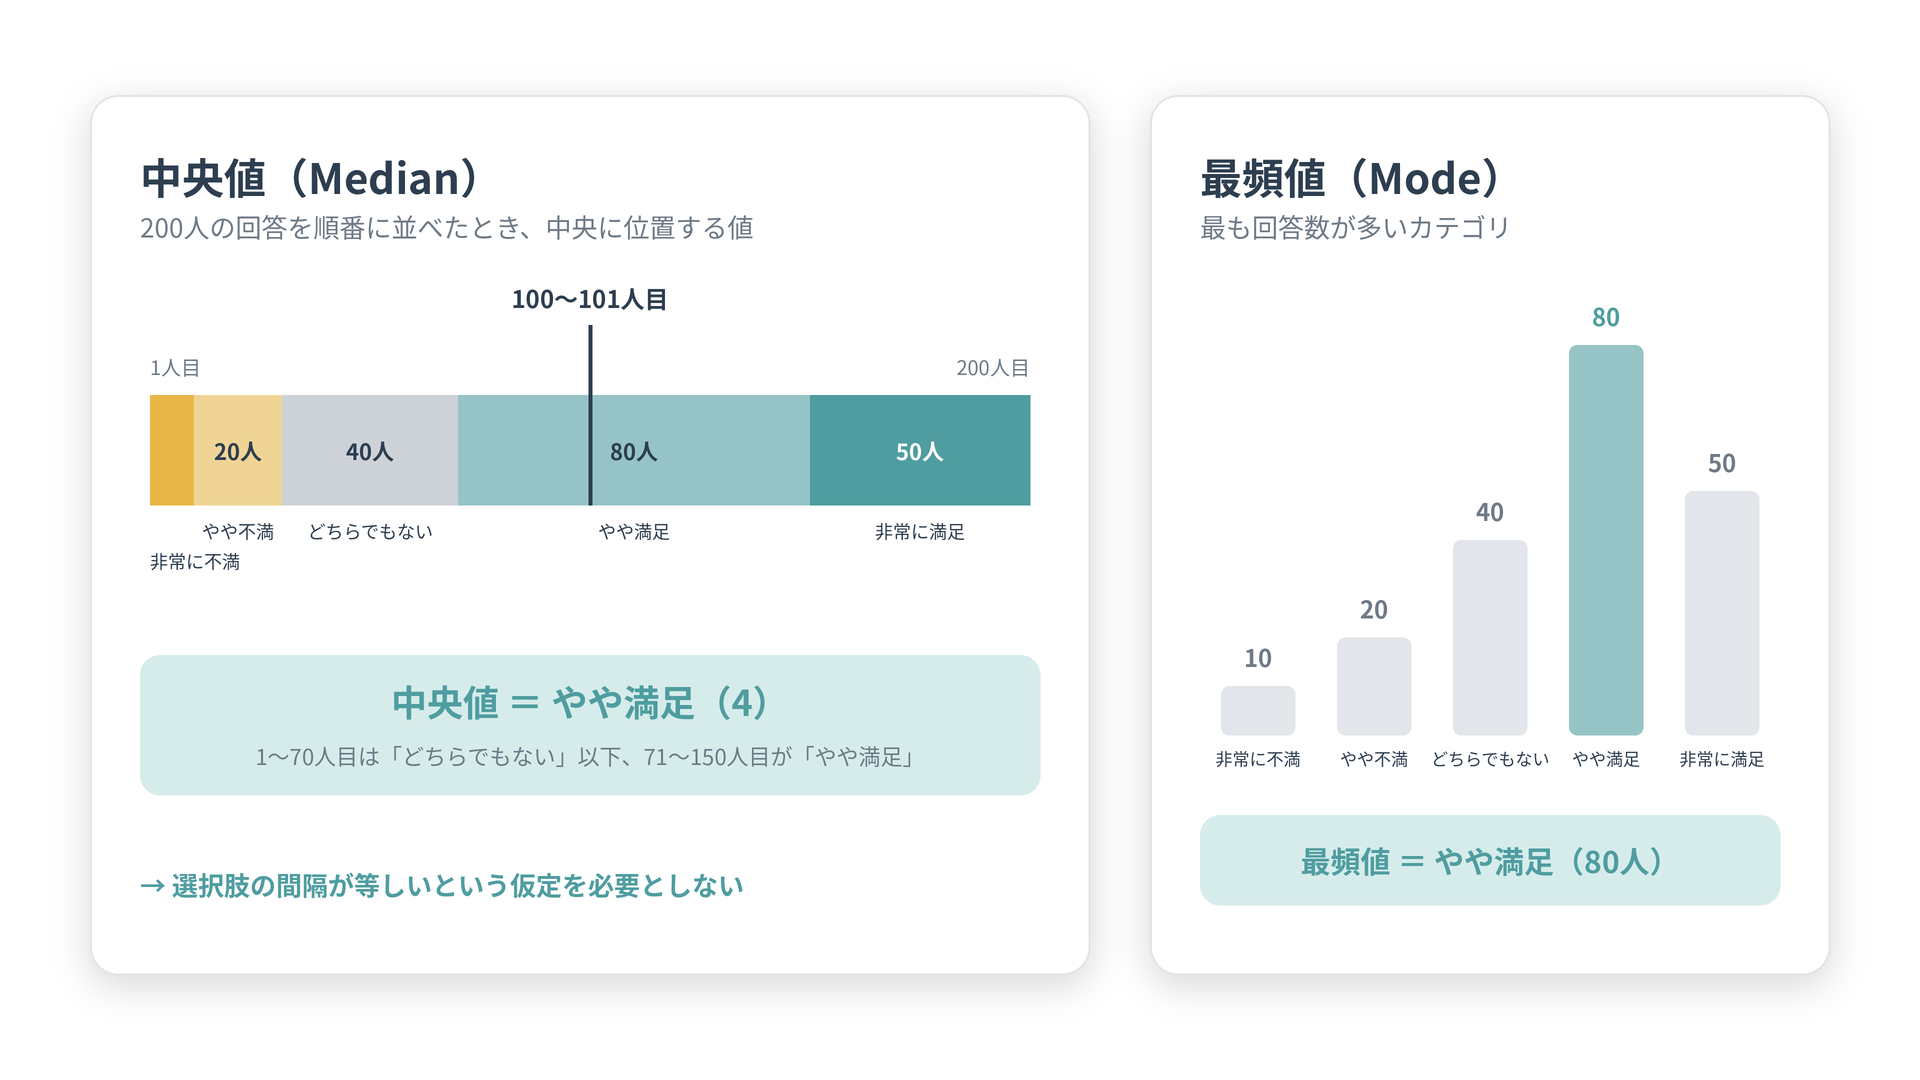
中央値(Median)とは、回答を順番に並べたときに中央に位置する値です。
先ほどの200人の回答では、中央値は「やや満足(4)」になります。
中央値は、回答カテゴリの順序を利用する指標なので、個々の選択肢間の距離が等しいという仮定を必要としません。
また、最頻値(Mode)は、最も回答数が多いカテゴリのことです。
今回の例では、「やや満足」が80人で最も多かったため、最頻値も「やや満足」になります。
中央値や最頻値は、個別のリッカート形式の質問を順序尺度として扱う場合に使いやすい代表値です。
4.2 リッカート尺度の平均値を計算してもよいのか?
リッカート尺度の分析では、平均値を計算してよいのかという疑問がよくあります。
実務では、5段階評価に1〜5の数値を割り当て、平均値を計算する方法が広く使われています。
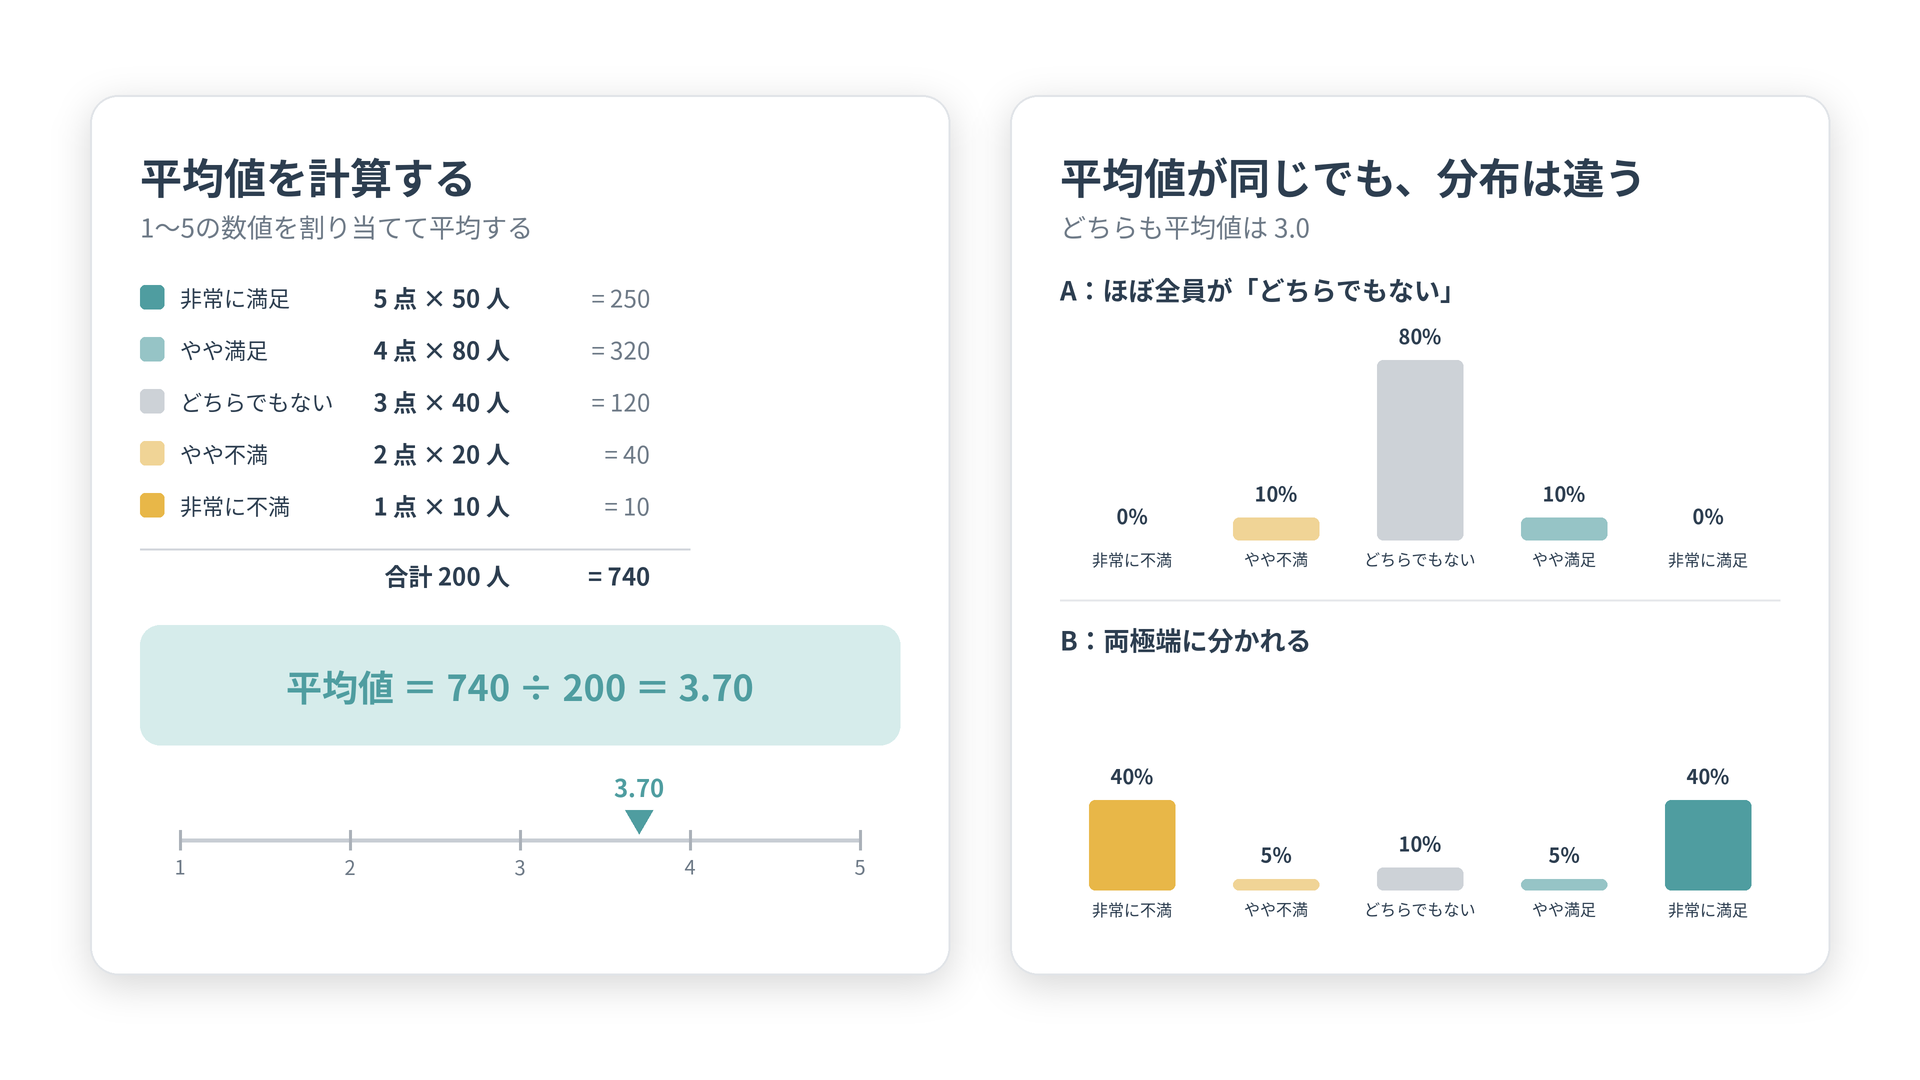
今回の例であれば、平均値は次のように計算できます。
平均値 = (5×50 + 4×80 + 3×40 + 2×20 + 1×10) ÷ 200 = 3.70
つまり、満足度の平均値は5点満点中3.70点です。
このようなスコアは、複数の評価項目や調査時点を比較する際に便利です。
ただし、注意点があります。
リッカート尺度は本来、選択肢間の距離が等しいとは限らない順序尺度です。
そのため、平均値を計算するということは、1から5の数値間隔を等しいものとして扱っていることになります。
また、平均値が同じでも、回答分布が同じとは限りません。
例えば、多くの人が「どちらでもない」と回答している場合と、「非常に満足」「非常に不満」の両極端に回答が分かれている場合では、平均値が近くても、実際の評価の傾向は大きく異なります。
したがって、平均値だけで判断せず、回答分布と合わせて解釈することが重要です。
複数の関連する質問を組み合わせた合成スコアの場合には、尺度の信頼性や妥当性などを確認したうえで、平均値や連続数値を前提とした統計分析を利用することもあります。
4.3 Top 2 Box / Bottom 2 Boxとは?
アンケート分析で広く使われているのが、Top 2
Box(トップツーボックス)です。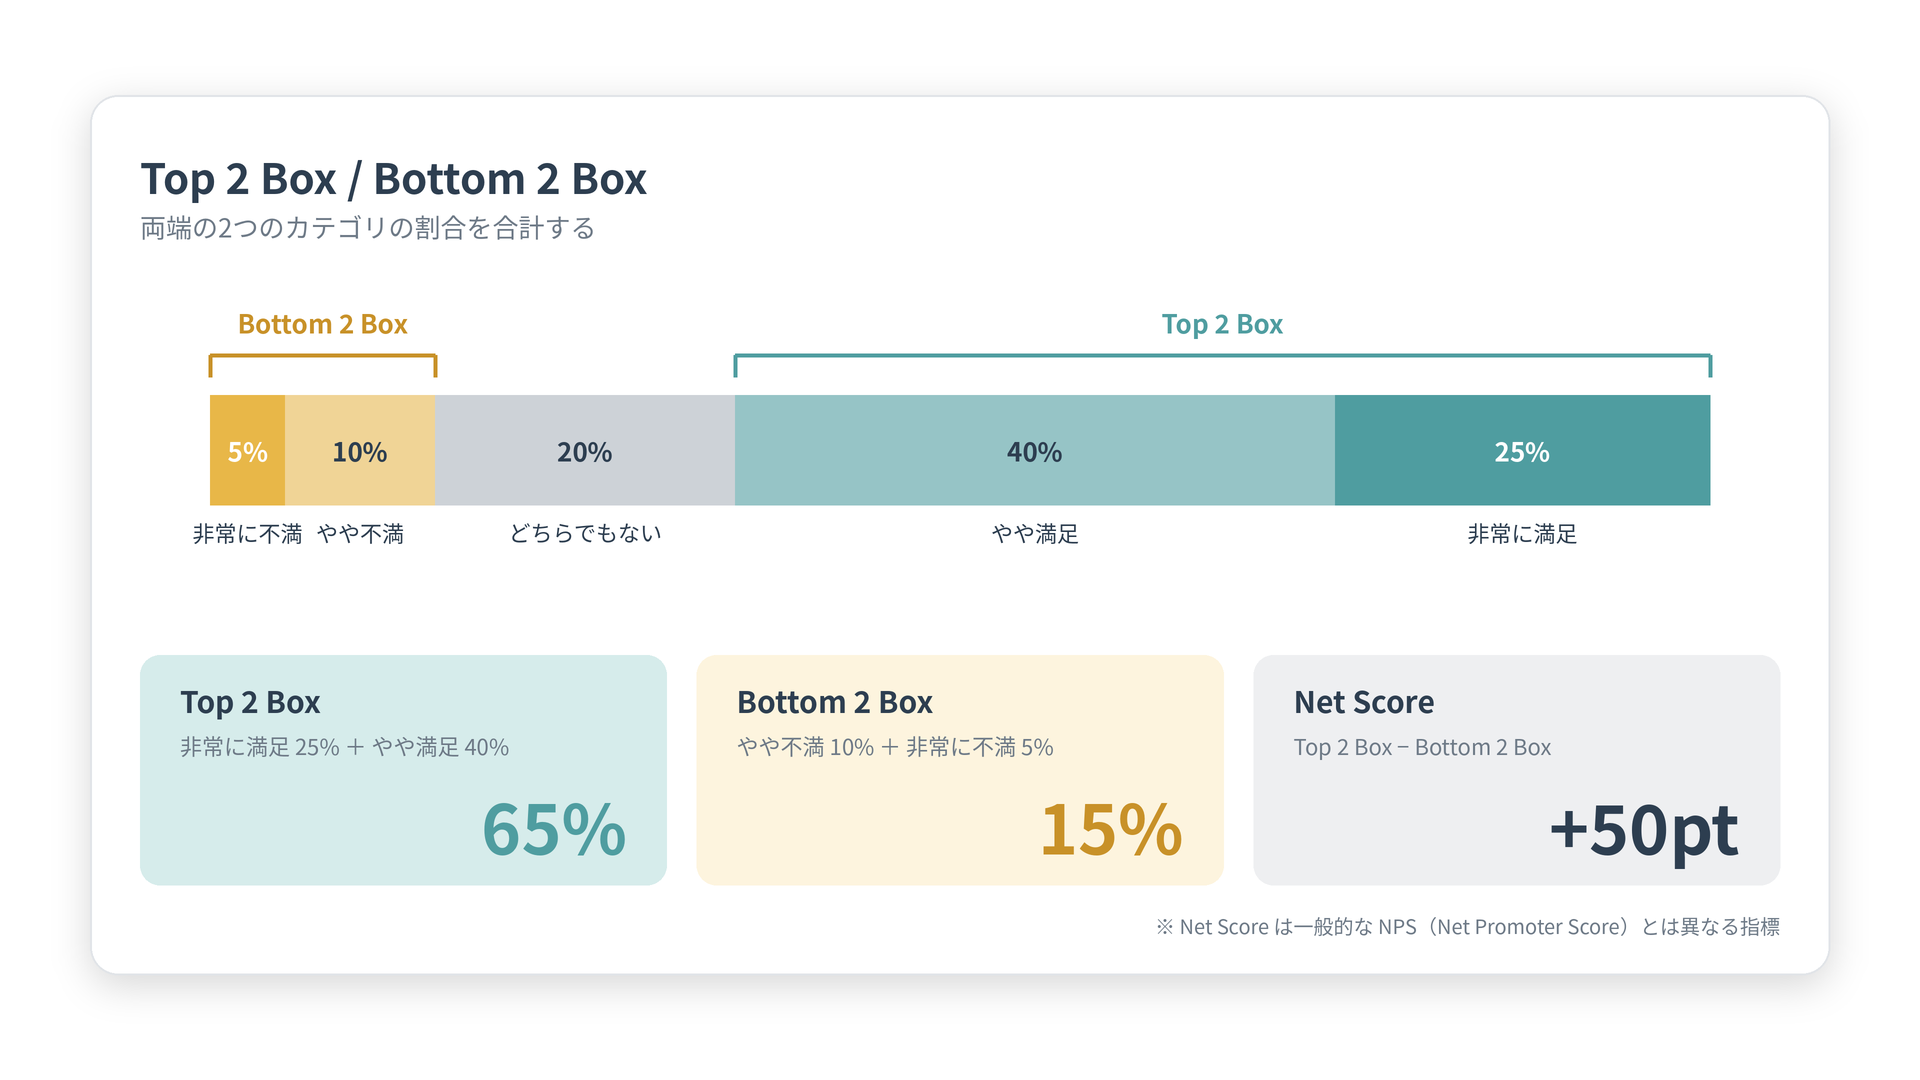
Top 2 Boxとは、5段階評価や7段階評価などで、最も高い2つの回答カテゴリを合計した割合のことです。
例えば、5段階の満足度評価であれば、「非常に満足」と「やや満足」の割合を合計します。
先ほどのデータでは、
Top 2 Box = 25% + 40% = 65%
となります。
同様に、最も低い2つのカテゴリを合計したものをBottom 2 Box(ボトムツーボックス)と呼びます。
今回の例では、
Bottom 2 Box = 10% + 5% = 15%
です。
さらに、Top 2 BoxからBottom 2 Boxを引いたものを、Net Scoreとして利用することもあります。
Net Score = 65% − 15% = +50ポイント
この指標を使えば、肯定的な回答と否定的な回答のバランスを1つの数値で表せます。
ただし、これは一般的なNet Promoter Score(NPS)とは異なる指標なので注意してください。
4.4 平均値とTop 2 Boxはどう使い分ける?
平均値とTop 2 Boxは、似たような指標に見えるかもしれませんが、着目している情報が異なります。
平均値は、すべての回答に割り当てた数値を使い、全体的な評価水準を表します。
一方、Top 2 Boxは、最も肯定的な2つの回答を選んだ人の割合に着目します。
例えば、顧客満足度をモニタリングする場合、平均値を使えば評価水準の小さな変化を追跡しやすくなります。
一方、Top 2 Boxを使えば、満足している顧客が全体の何%を占めているかという、ビジネス上わかりやすい指標を作成できます。
ただし、Top 2 Boxでは「やや満足」から「非常に満足」への変化や、低評価側の変化を捉えられないことがあります。
また、5段階評価と7段階評価のTop 2 Boxは同じ意味になるとは限らないため、尺度の異なる質問間で単純に比較することは避けるべきです。
実務では、回答分布、平均値、Top 2 Boxを組み合わせて確認することで、評価の傾向をより正確に理解できます。
5. クロス集計でグループ間の違いを比較する
ここまでは、回答者全体の評価を見てきました。
しかし、アンケート分析では、全体の傾向だけでなく、回答者の属性によって評価がどう違うのかを調べることも重要です。
そこで使われるのが、クロス集計です。
5.1 性別や年代による回答傾向の違いを確認する
例えば、先ほどの顧客満足度の回答を、性別ごとに集計したとします。
| 満足度 | 男性(n=100) | 女性(n=100) |
|---|---|---|
| 非常に満足 | 20% | 30% |
| やや満足 | 40% | 40% |
| どちらでもない | 20% | 20% |
| やや不満 | 14% | 6% |
| 非常に不満 | 6% | 4% |
| Top 2 Box | 60% | 70% |
この結果を見ると、男性のTop 2 Boxは60%、女性は70%です。
つまり、女性の方が肯定的な回答の割合が10ポイント高いことがわかります。
さらに、女性は「非常に満足」と回答した割合も高くなっています。
このように、クロス集計を使うことで、全体の集計だけでは見えなかったグループ間の違いを発見できます。
同じ方法で、年代、地域、商品購入経験、会員ランクなどによる違いも比較できます。
5.2 行%と列%の違いに注意する
クロス集計で注意したいのが、割合を計算するときの分母です。
例えば、先ほどの表では男性と女性を列に配置しているため、それぞれの列の回答者数を分母として割合を計算しています。
これは「列%」です。
一方、同じ表で「非常に満足」と回答した人のうち、男性と女性がそれぞれ何%を占めているかを調べたい場合は、行を分母にした「行%」を使います。
どちらも正しい割合ですが、答えている質問が違います。
「男性と女性では、満足度の分布がどう違うのか?」を知りたい場合は、それぞれの性別を分母にして比較する必要があります。
クロス集計では、分析したい問いに応じて、適切な分母を選ぶことが大切です。
5.3 Top 2 Boxでグループ間を比較する
回答カテゴリが5つ、7つとある場合、すべてのカテゴリの割合を比較するのは大変です。
そこで、Top 2 Boxを使うと、グループ間の比較が簡単になります。
例えば、性別、年代、地域ごとにTop 2 Boxを計算すれば、肯定的な回答が多いグループをすぐに見つけられます。
ただし、グループ間に差があるからといって、必ずしも統計的に有意な差であるとは限りません。
そこで、次に紹介する統計検定が役立ちます。
6. グループ間の違いが統計的に有意か検定する
クロス集計によって違いが見つかった場合、次に考えたいのが、その違いをどのように評価するかということです。
例えば、男性のTop 2 Boxが60%、女性が70%だった場合、この10ポイントの差はどの程度確かなものなのでしょうか。
このような問題を考える際に役立つのが、仮説検定です。
仮説検定では、観測された違いが、母集団に差がないと仮定した場合の標本変動とどの程度整合的かを調べます。
リッカート尺度では、何を比較したいのかによって、使う検定が変わります。
6.1 カイ二乗検定:回答分布全体に違いがあるか
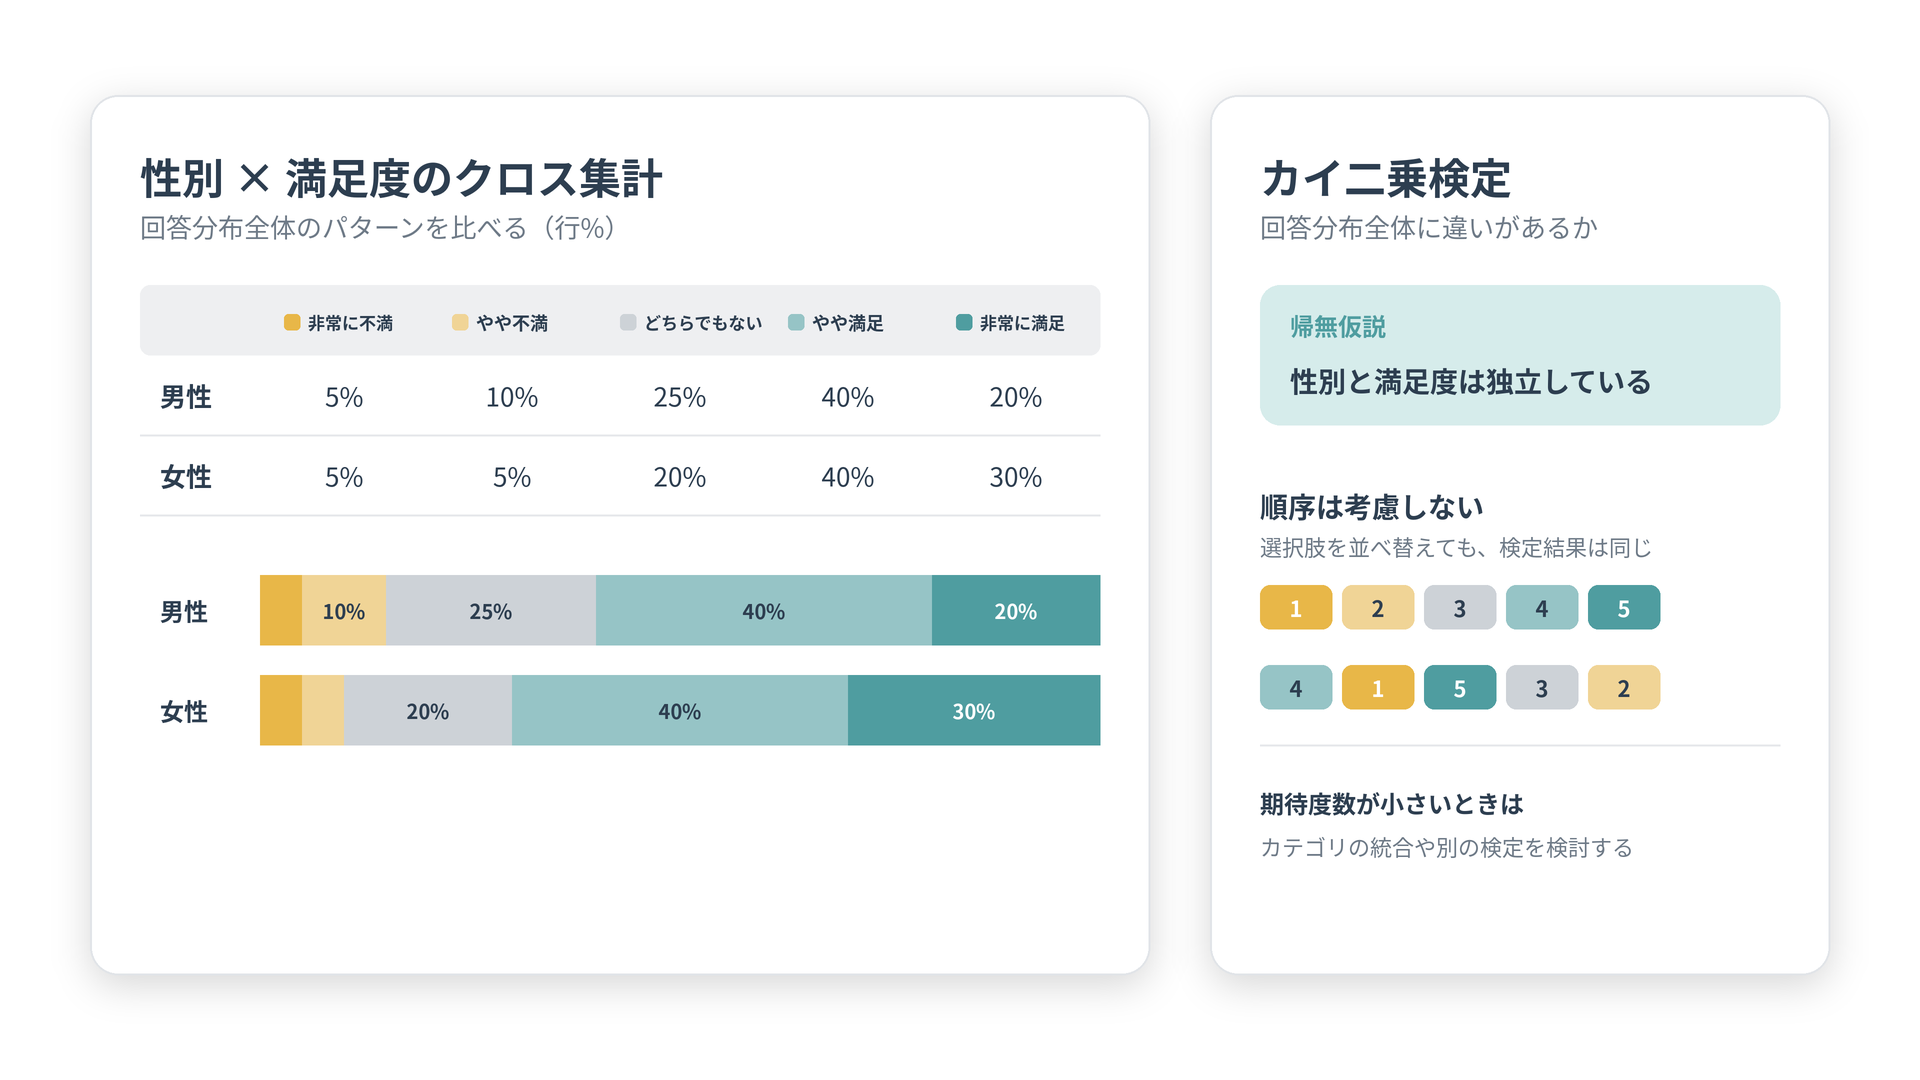
カイ二乗検定は、カテゴリ変数同士の関連を調べるためによく使われる方法です。
例えば、性別と5段階評価の満足度についてクロス集計を行い、男性と女性で回答分布が異なるかを検定できます。
帰無仮説は、「性別と満足度の回答カテゴリは独立している」というものです。
P値が十分に小さければ、性別と満足度の回答分布に統計的な関連があるという判断を支持します。
ただし、カイ二乗検定は回答カテゴリ間の順序を考慮しません。
6.2 比率の検定:Top 2 Boxに違いがあるか
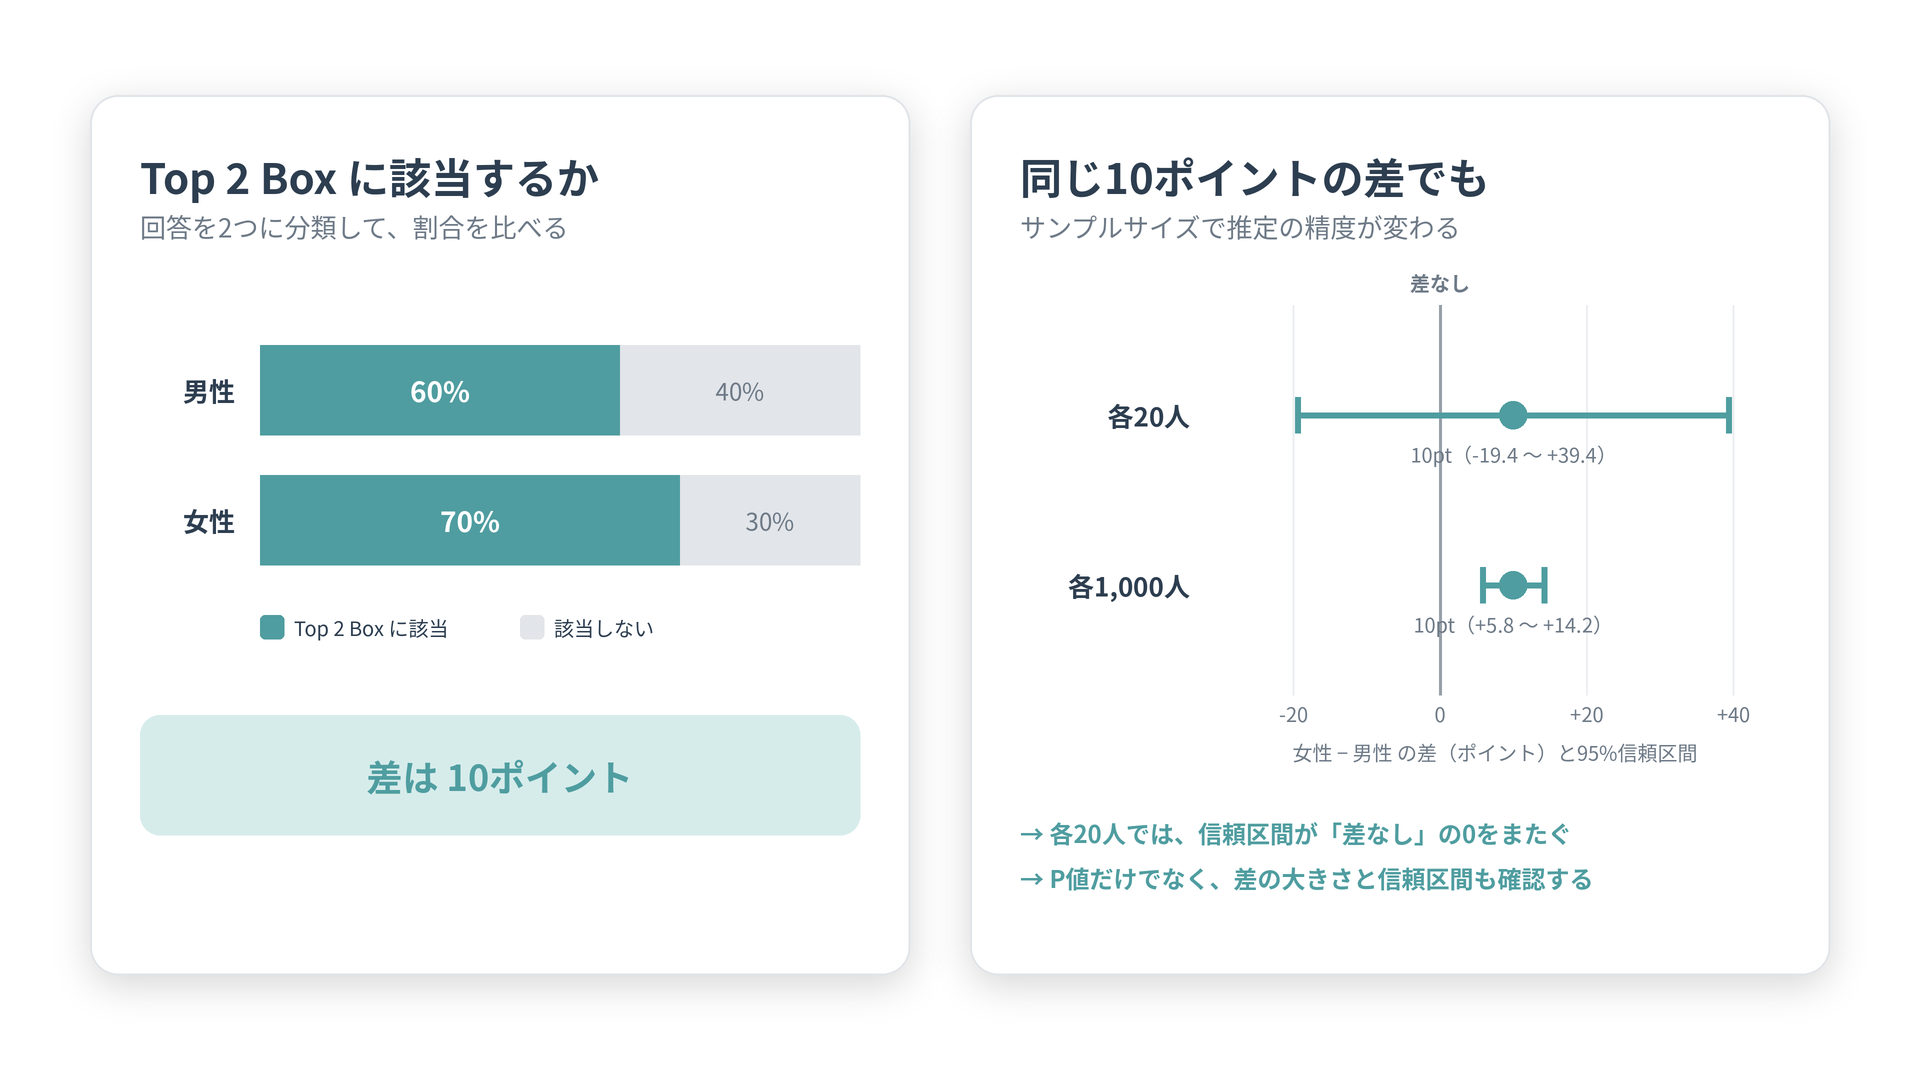
Top 2 Boxを使ったグループ比較では、比率の検定を使うことができます。
例えば、男性のTop 2 Boxが60%、女性が70%だった場合、肯定的な回答の割合に差があるかを調べます。
この場合は、各回答を「Top 2 Boxに該当する」「該当しない」の2つに分類します。
そして、2つのグループで、その割合が異なるかを検定します。
ここで重要なのが、割合の差だけでなく、サンプルサイズも考慮する必要があるということです。
例えば、同じ10ポイントの差でも、各グループの回答者が20人の場合と1,000人の場合では、推定の精度が異なります。
また、P値だけでは差の大きさや実務上の重要性はわかりません。
そのため、割合の差と、その信頼区間も合わせて確認すると、結果を適切に解釈しやすくなります。
6.3 ウィルコクソン検定(Mann–Whitney U検定):回答の順序を考慮して比較する
リッカート尺度は順序尺度なので、回答カテゴリの順序を考慮した分析をしたい場合があります。
そこで使えるのが、ウィルコクソン検定(Mann–Whitney U検定)です。
この検定では、2つの独立したグループの回答を順位に基づいて比較します。
例えば、男性と女性の満足度について、どちらのグループがより高い評価をする傾向にあるかを調べる場合に利用できます。
3グループ以上を比較する場合には、Kruskal–Wallis検定などが候補になります。
6.4 t検定やANOVAを使うことはできるのか?
実務では、5段階評価を1〜5の数値に変換し、t検定や分散分析(ANOVA)を使って平均値を比較することもあります。
これらは、平均値の比較を目的とした方法です。
ただし、単一のリッカート形式の質問は順序尺度であり、数値の間隔が等しいとは限りません。
したがって、平均値の検定を行う場合には、数値化の妥当性、回答分布、サンプルサイズ、検定の前提などを検討する必要があります。
特に、回答が一方の端に極端に集中している場合などは、分析結果の解釈に注意が必要です。
一方、複数の関連する質問を組み合わせた合成スコアでは、測定上の妥当性や統計的な前提を確認したうえで、連続数値を対象とする分析方法を採用する場合があります。
重要なのは、リッカート尺度だから常に特定の検定を使う、ということではなく、比較したい内容とデータの性質に応じて方法を選ぶことです。
7. 相関分析・回帰分析で評価に関連する要因を調べる
クロス集計や仮説検定では、主にグループ間の違いに着目してきました。
しかし、アンケート分析では、評価項目同士にどのような関連があるのかを調べたい場合もあります。
例えば、総合満足度が高い人は、商品の品質やサポートについても高く評価しているのでしょうか。
このような関係を調べるために、相関分析や回帰分析が役立ちます。
7.1 相関分析:評価項目同士の関係を調べる
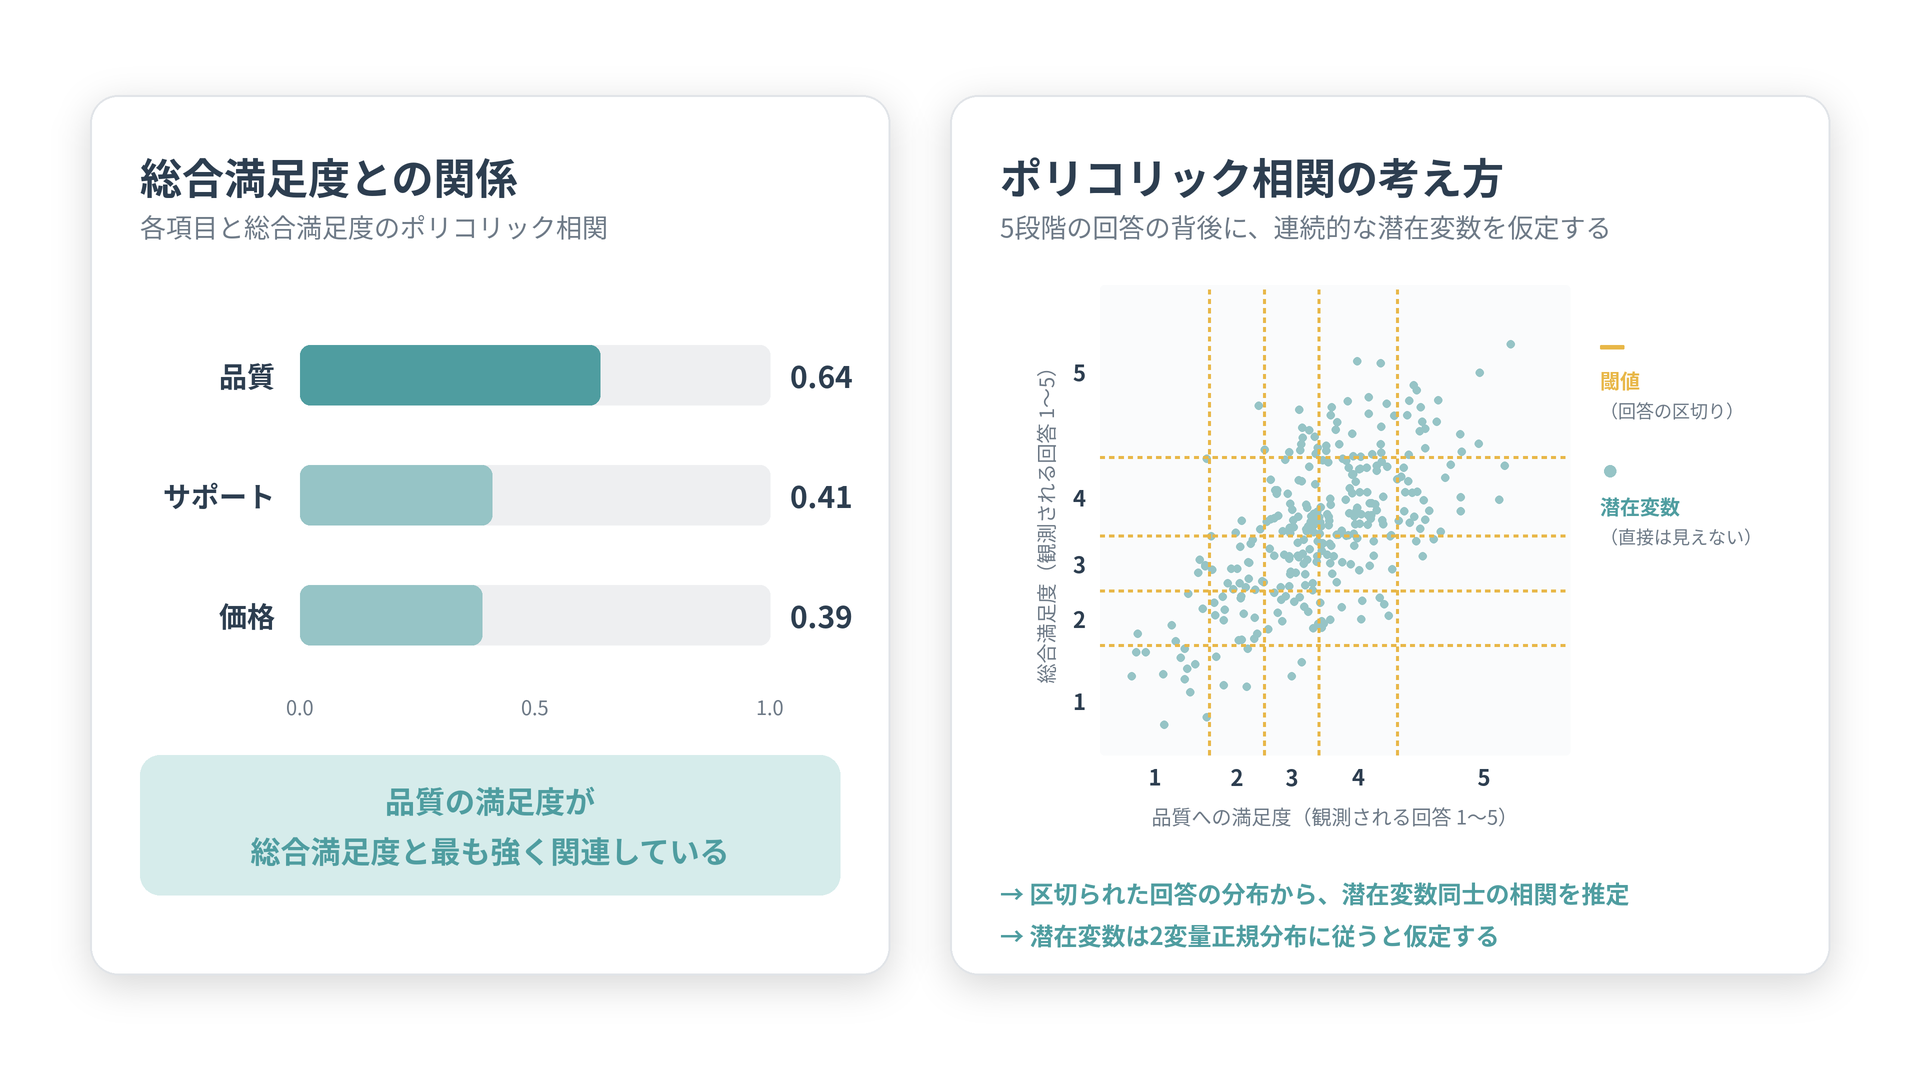
例えば、次のような項目を5段階で評価したとします。
- 商品の品質への満足度
- 価格への満足度
- サポートへの満足度
- 総合満足度
それぞれの項目と総合満足度の関係を調べることで、どの評価項目が総合満足度と強く関連しているかを理解できます。
リッカート尺度のような順序データに対しては、ポリコリック相関がよく使われます。
ポリコリック相関は、観測された順序カテゴリの背後に連続的な潜在変数があると仮定して、その潜在変数同士の相関を推定する方法です。
一般的なポリコリック相関では、潜在変数が2変量正規分布に従うという仮定を置きます。
5段階評価や7段階評価などの順序データに対する因子分析では、この相関係数が利用されることがよくあります。
ただし、回答カテゴリの出現頻度が極端に少ない場合や、分布の仮定が適切でない場合には、推定が不安定になることがあります。
分析の目的やデータの特徴に応じて、適切な相関係数を選ぶことが重要です。
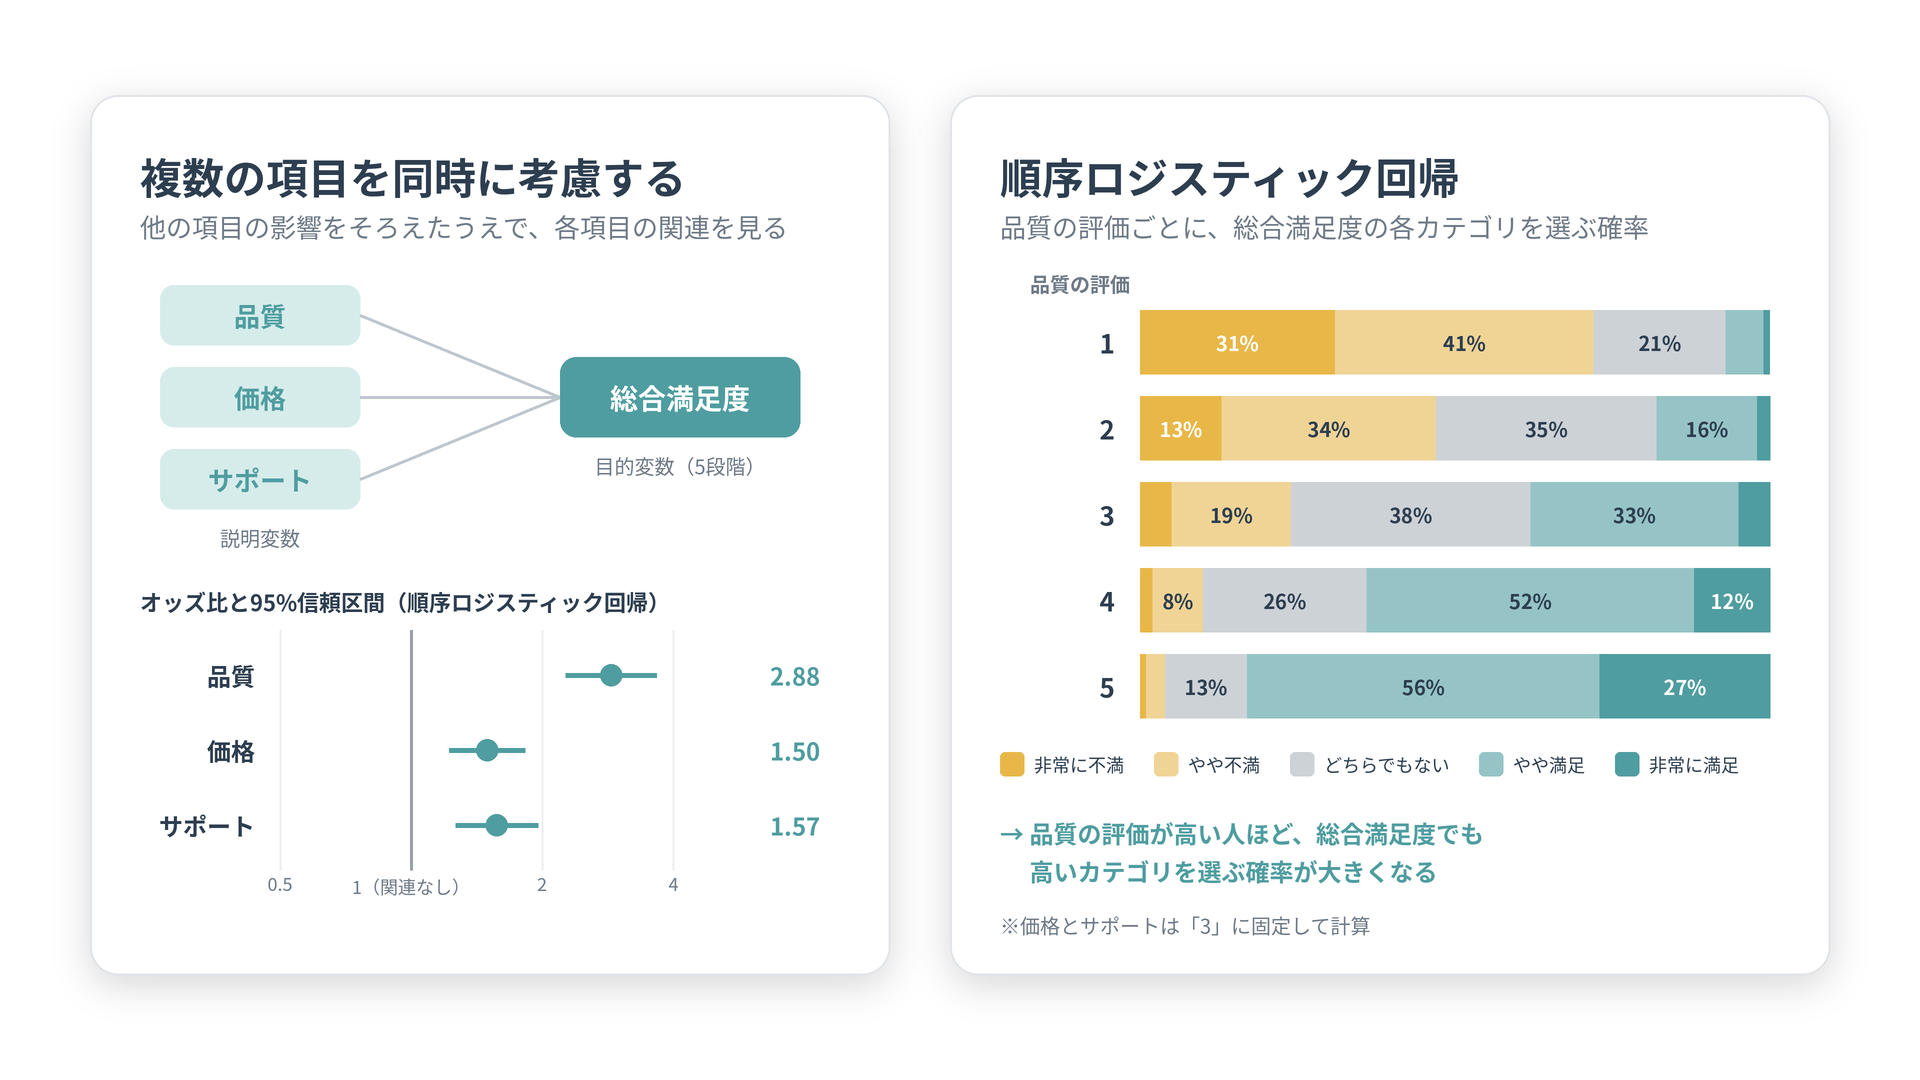
7.2 回帰分析:複数の項目を同時に考慮する
相関分析では、基本的に2つの変数の関係を調べます。
しかし、顧客満足度には、商品の品質、価格、サポートなど、複数の要因が同時に関連している可能性があります。
そこで使われるのが、回帰分析です。
例えば、総合満足度を目的変数とし、品質、価格、サポートの評価を説明変数に設定します。
これにより、他の説明変数を考慮したうえで、それぞれの項目が総合満足度とどのように関連しているかを調べられます。
ただし、総合満足度が単一の5段階評価である場合、通常の線形回帰をそのまま使うことが適切とは限りません。
そのような場合の選択肢として、順序ロジスティック回帰があります。
順序ロジスティック回帰は、「非常に不満」から「非常に満足」のように、順序のあるカテゴリを目的変数として扱う方法です。
例えば、品質の評価が高い人ほど、総合満足度でも高いカテゴリを選ぶ傾向があるかを調べることができます。
代表的な比例オッズモデルでは、その前提が適切かどうかも確認する必要があります。
また、回帰分析で関連が見つかったとしても、それだけで因果関係が証明されるわけではありません。
「品質の評価が高い人ほど満足度も高い」という結果は、「品質を改善すれば必ず満足度が上がる」という結論とは異なることに注意しましょう。
8. 複数のリッカート尺度の質問から共通する要因を見つける
ここまでは、個々の評価項目を中心に分析してきました。
しかし、アンケート調査では、回答者の価値観や意識など、直接観測することが難しい概念を調べたい場合もあります。
例えば、商品を選ぶときの価値観について、次のような質問を用意したとします。
- 商品の品質を重視する
- 長く使える商品を選びたい
- 多少高くても信頼できる商品がよい
- できるだけ安い商品を選びたい
- コストパフォーマンスを重視する
- 割引やセールを積極的に利用する
それぞれを5段階評価で回答してもらいます。
このような複数の質問に対して、どのような分析ができるのでしょうか。
8.1 信頼性分析:複数の質問に一貫性があるか
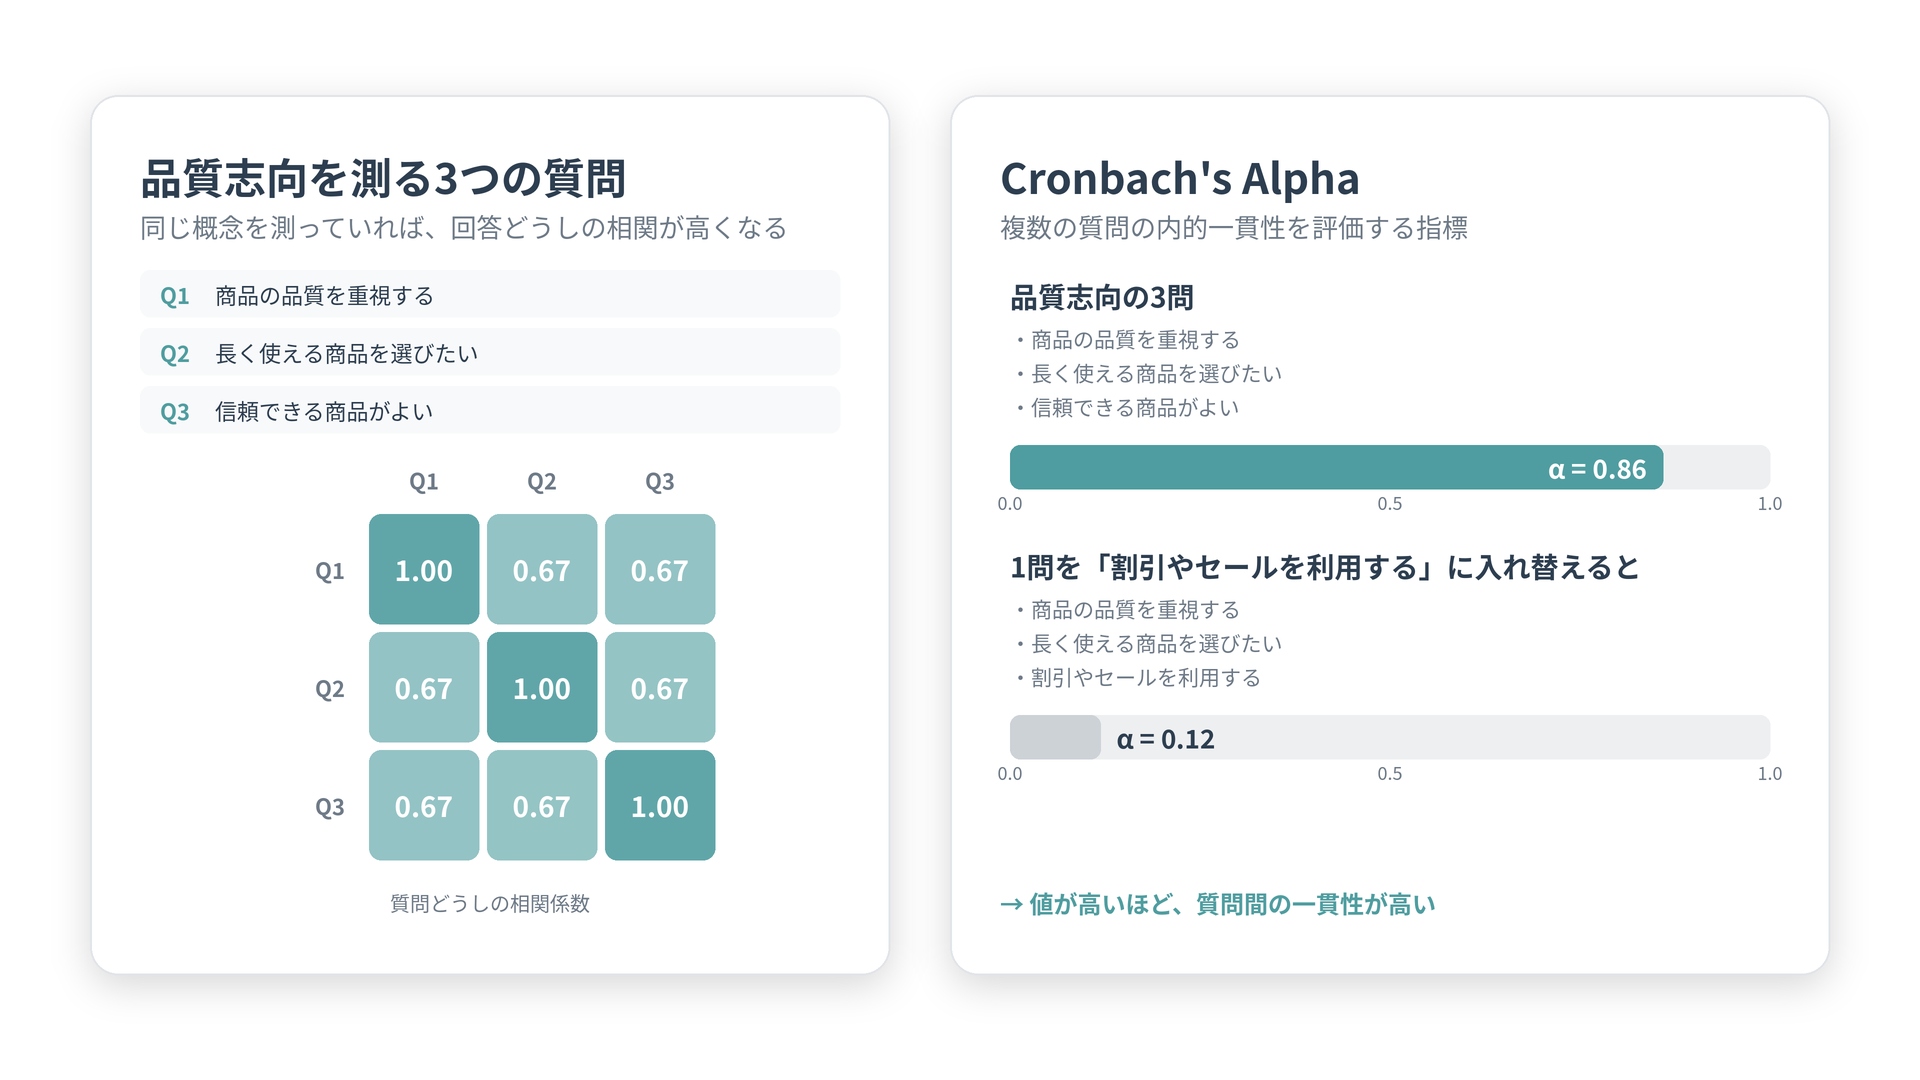
例えば、「商品の品質を重視する」「長く使える商品を選びたい」「信頼できる商品がよい」という3つの質問を組み合わせて、品質志向を測定したいとします。
このとき、3つの質問が同じような概念を測定しているかを確認する必要があります。
そこで使われるのが、信頼性分析です。
代表的な指標に、クロンバックのアルファ係数(Cronbach’s Alpha)があります。
Cronbach’s Alphaは、複数の質問にどの程度の内的一貫性があるかを評価するための指標です。
一般に、値が高いほど質問間の一貫性が高いことを示します。
ただし、Alphaが高いからといって、必ずしも質問が1つの概念だけを測定しているとは限りません。また、質問数が増えることでAlphaが高くなる場合もあります。
そのため、信頼性を評価する際には、質問の内容や因子構造なども合わせて確認することが重要です。
否定的な方向で書かれた質問を含む場合は、必要に応じて逆転項目の処理も行います。
8.2 因子分析:回答の背後にある共通の要因を見つける
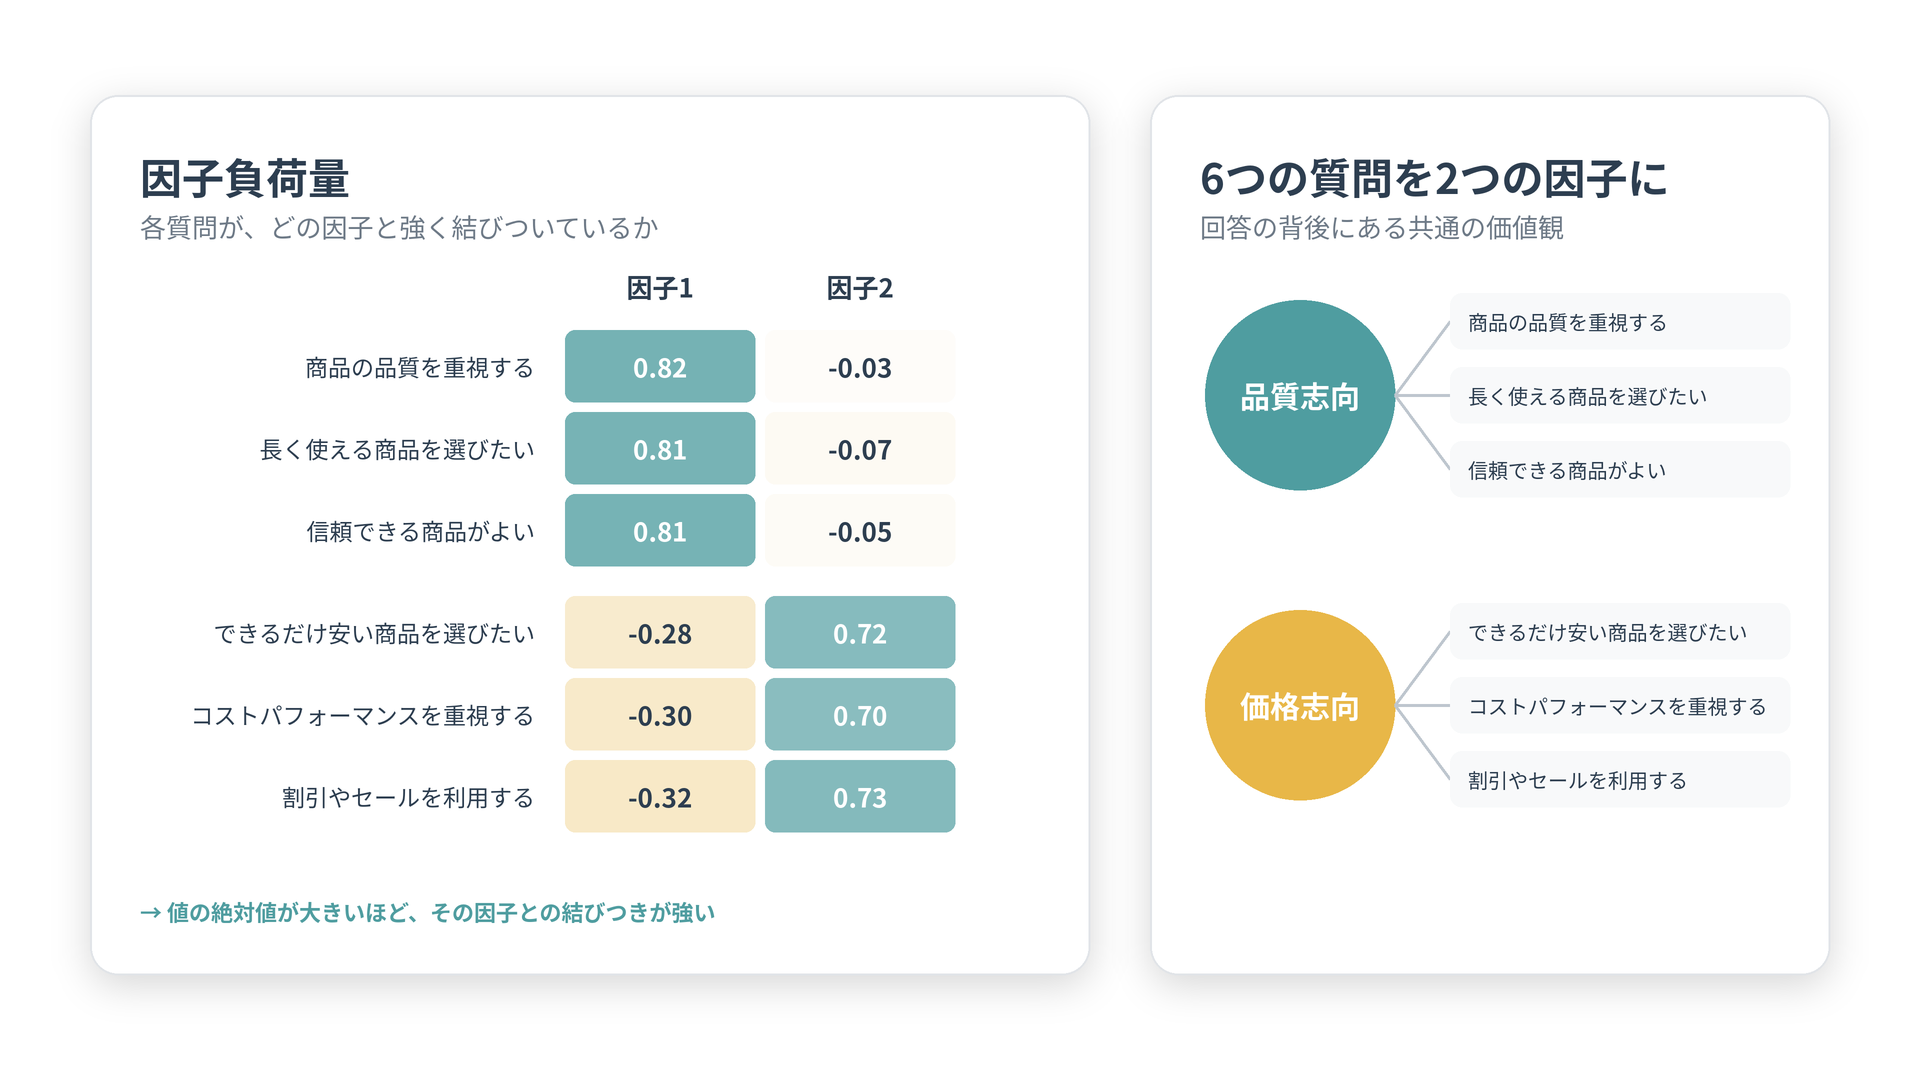
因子分析は、複数の変数の相関関係から、共通する潜在的な要因を見つけるための方法です。
例えば、先ほどの6つの質問を分析した結果、次のような2つの因子が見つかったとします。
因子1:品質志向
- 商品の品質を重視する
- 長く使える商品を選びたい
- 信頼できる商品がよい
因子2:価格志向
- できるだけ安い商品を選びたい
- コストパフォーマンスを重視する
- 割引やセールを利用する
このように、一見すると別々の質問であっても、回答の背後には共通する価値観が存在する可能性があります。
因子分析を使えば、多くの質問を少数の因子に整理し、回答者の意識や価値観を理解しやすくなります。
リッカート尺度のような順序データでは、前述のポリコリック相関を利用した因子分析も選択肢になります。
なお、因子の数や解釈は自動的に確定するものではありません。統計的な結果と質問内容の両方から妥当性を検討する必要があります。
8.3 クラスタリング・潜在クラス分析:似た回答パターンの人を見つける
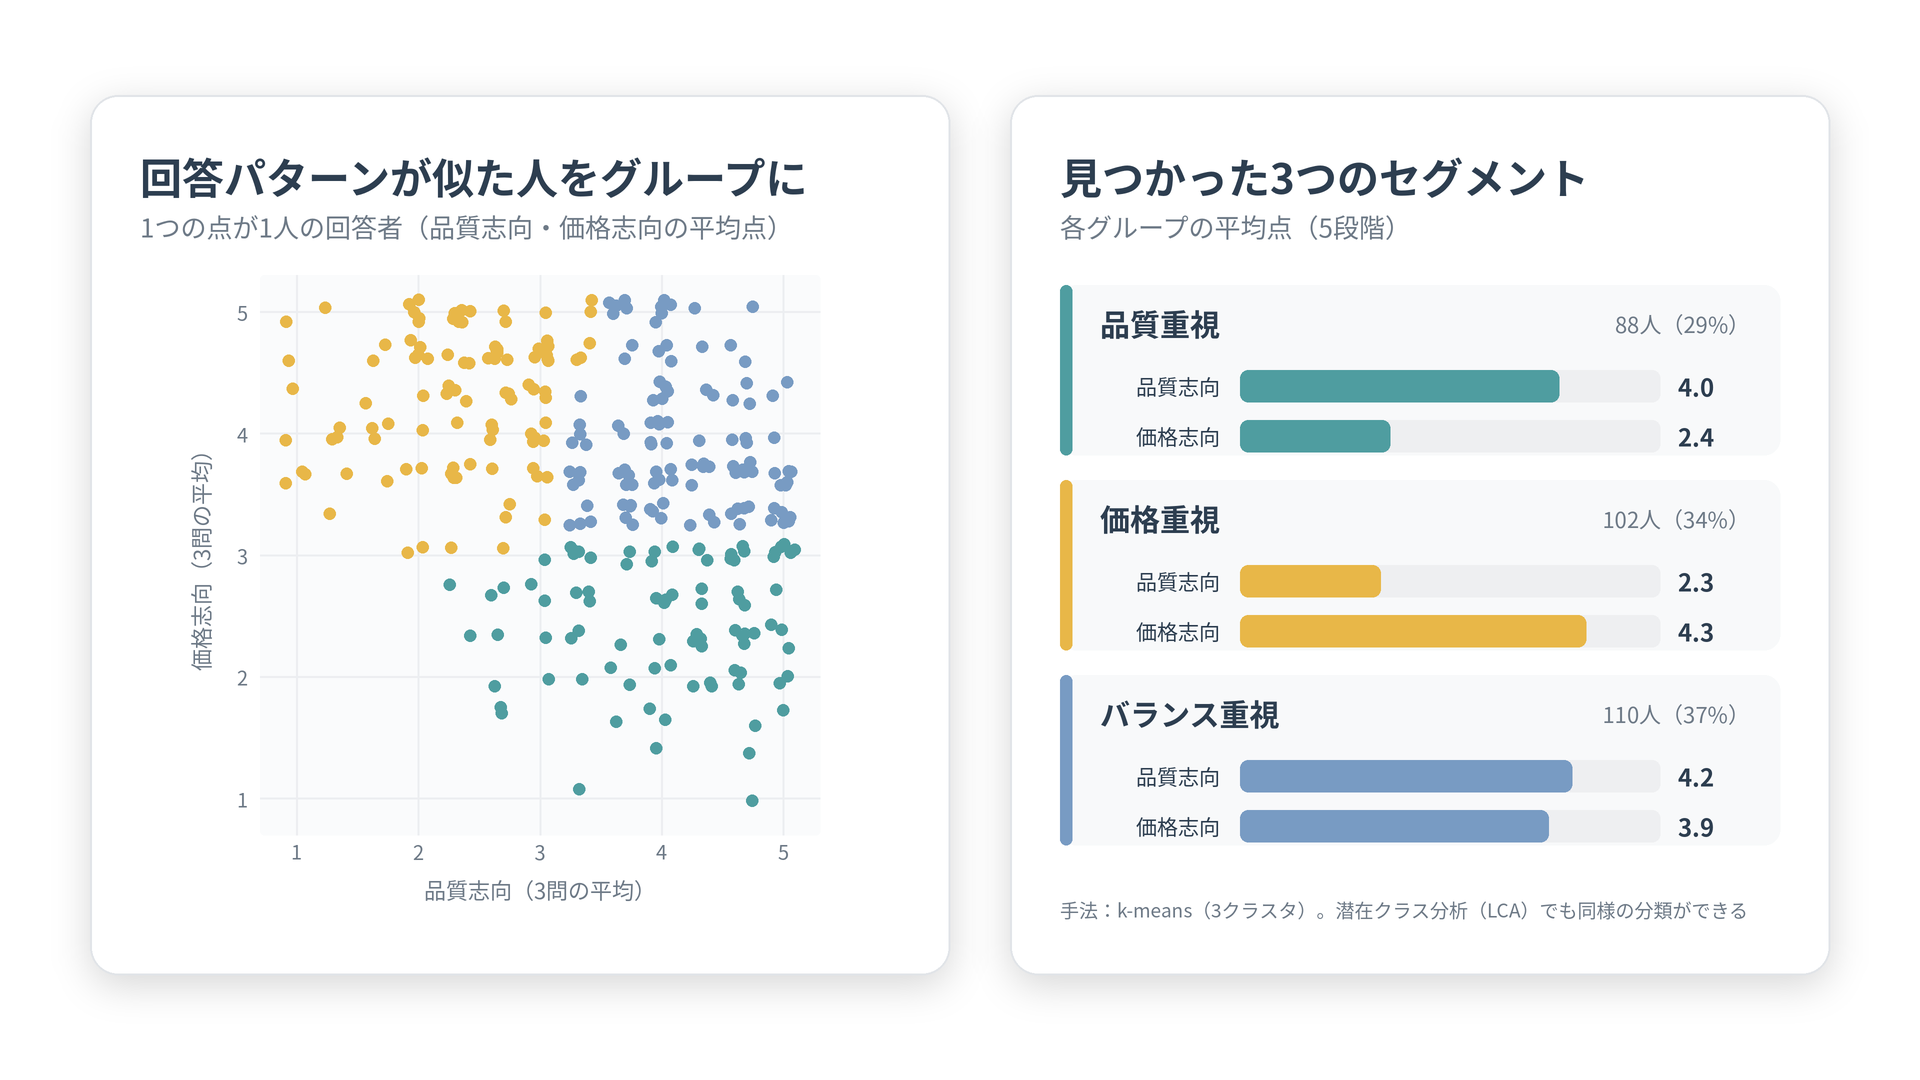
さらに、複数の質問への回答パターンが似ている人たちをグループに分類することもできます。
例えば、商品に対する価値観の回答パターンから、
- 品質を強く重視するグループ
- 価格を重視するグループ
- 品質と価格のバランスを重視するグループ
といった顧客セグメントを発見できる可能性があります。
このような分析には、クラスタリング分析や潜在クラス分析(LCA)などがあります。
因子分析が「質問の背後にある共通の要因」を探す方法であるのに対し、クラスタリングやLCAは「回答者を回答パターンによって分類する」ための方法です。
分析の目的に応じて使い分けるとよいでしょう。
9. Exploratoryを使ったリッカート尺度データの分析例
ここまで、リッカート尺度データに対するさまざまな分析方法を紹介してきました。
これらの分析は、データ分析ツールのExploratoryを使って、データの準備から集計、統計分析、レポート作成までを一連のワークフローとして実行できます。
ここでは、顧客満足度調査のデータを使った分析の流れを紹介します。
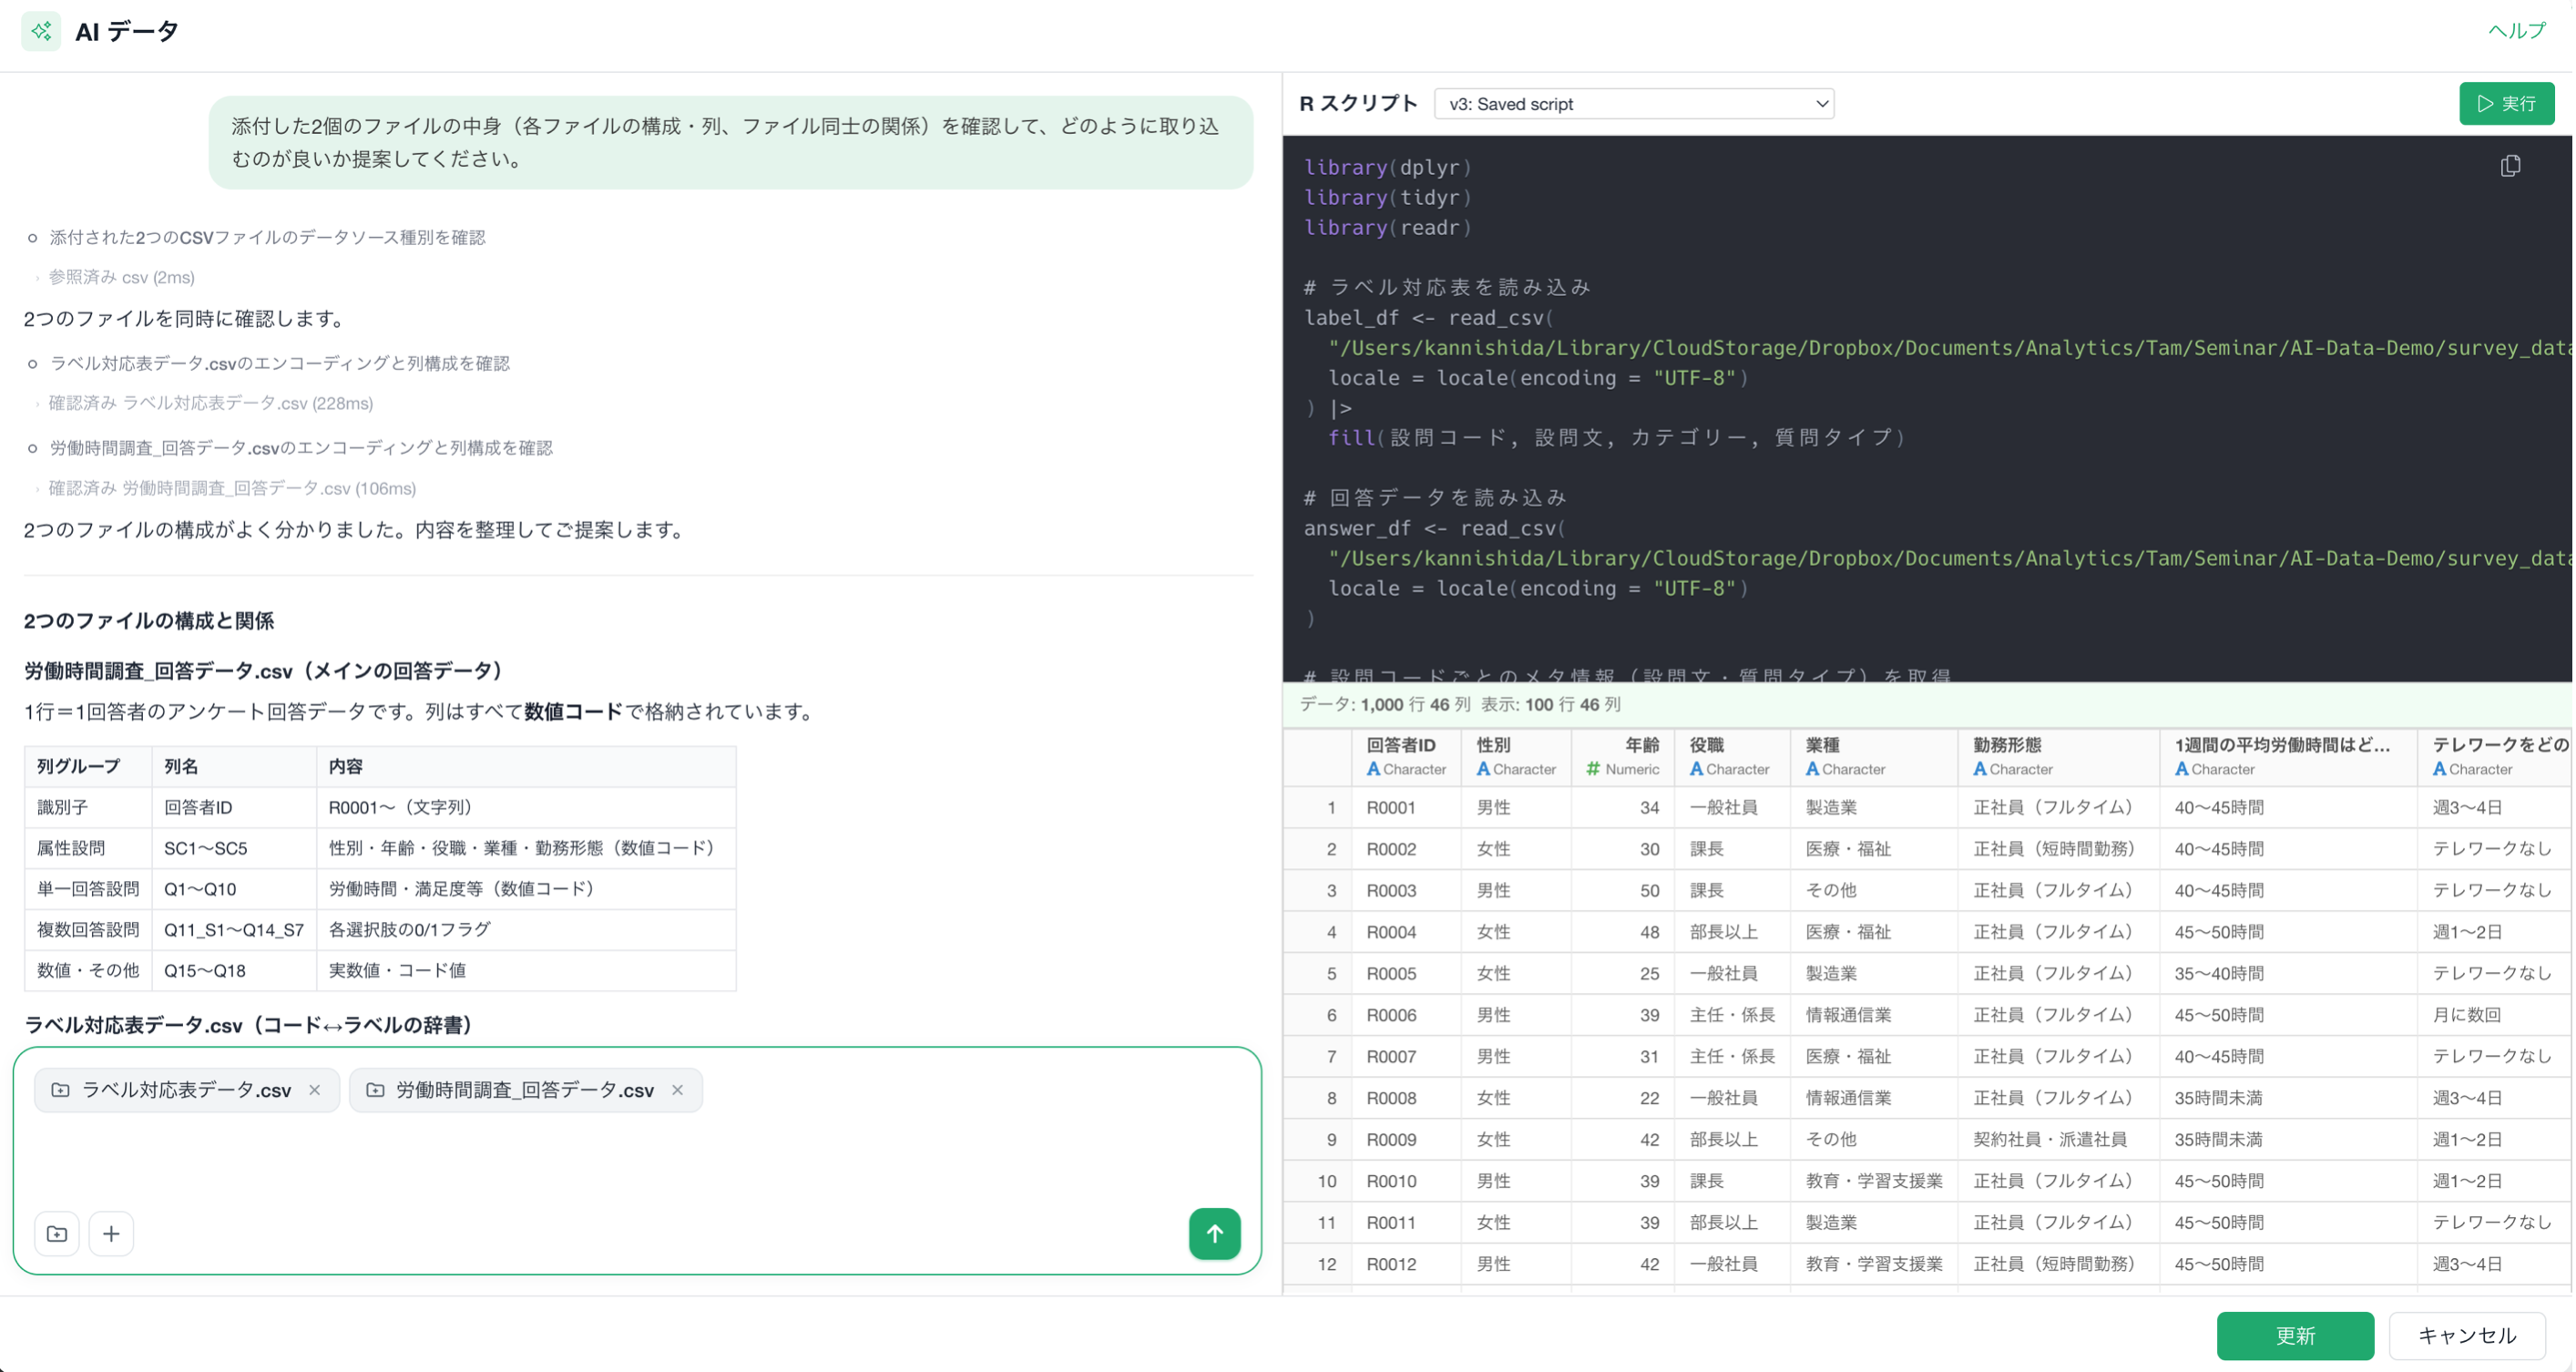
ステップ1:アンケートデータを読み込む
まず、アンケートツールからエクスポートしたCSVやExcelファイルをExploratoryに読み込みます。
ステップ2:回答カテゴリとデータ型を整える
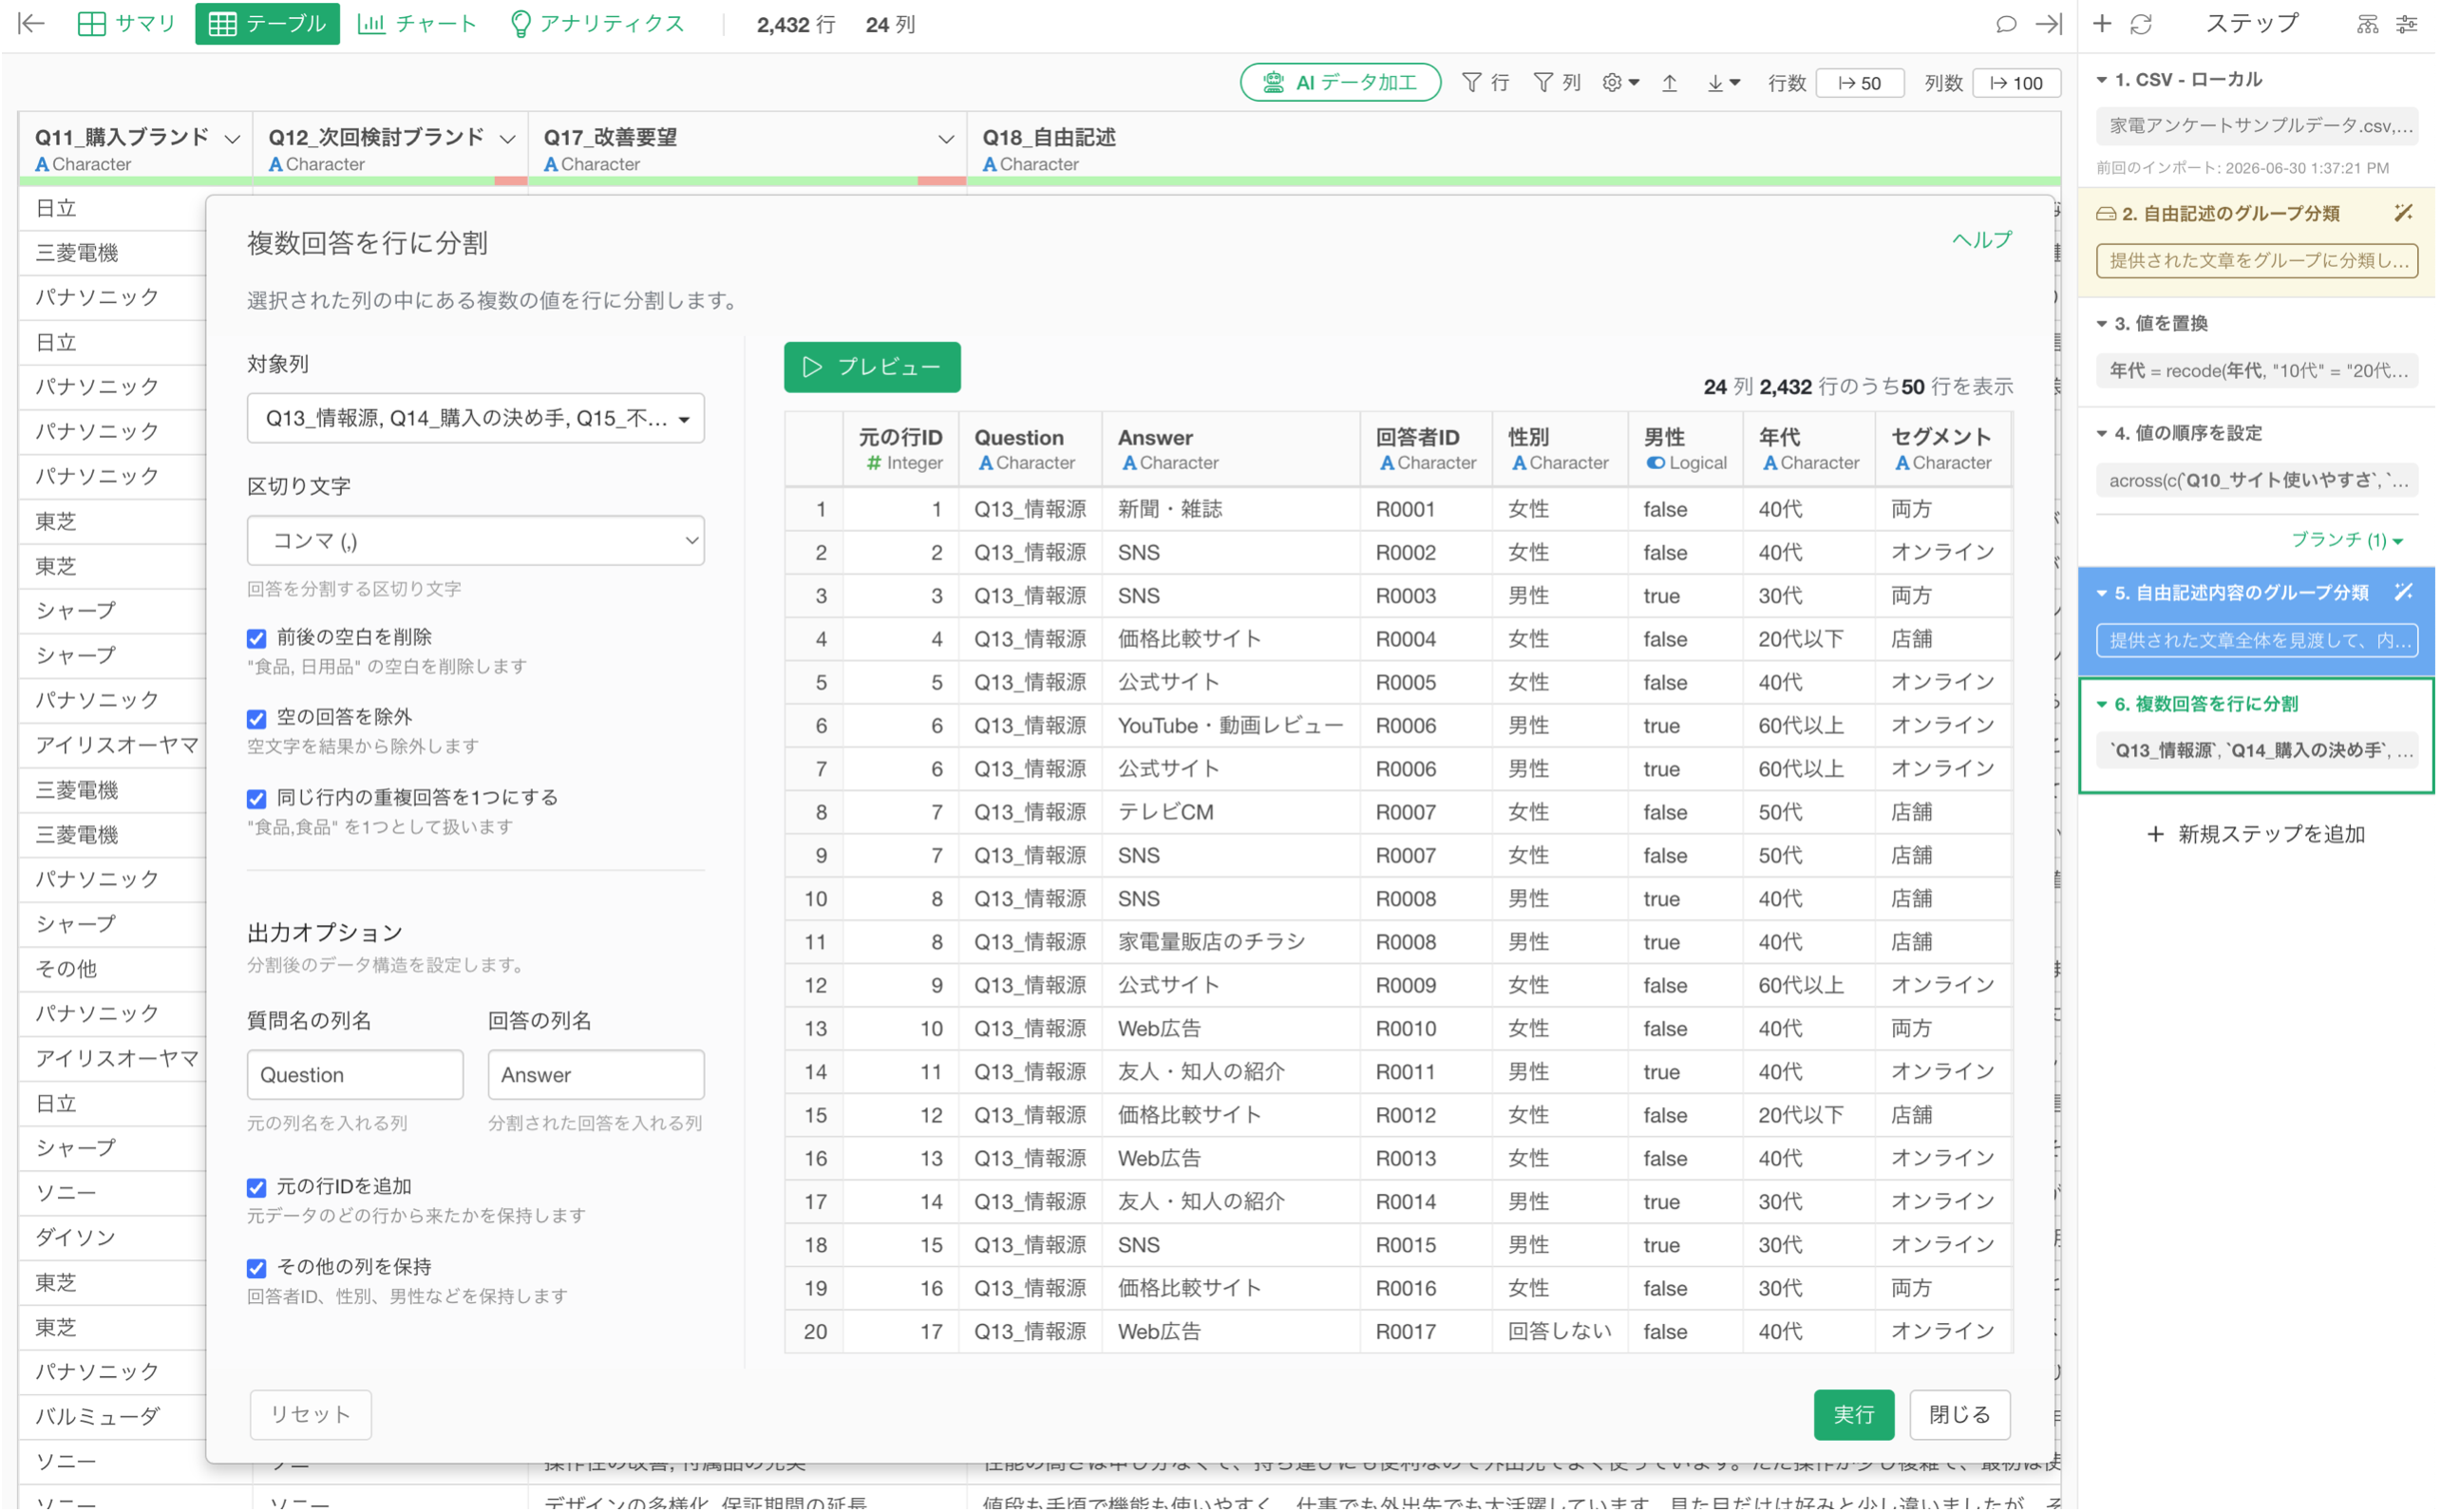
次に、5段階評価の回答を分析しやすい形に整えます。
例えば、回答が文字列になっている場合は、必要に応じて順序付きカテゴリとして扱い、次の順序を設定します。
非常に不満 → やや不満 → どちらでもない → やや満足 → 非常に満足
また、「無回答」「わからない」「該当しない」といった回答がある場合は、通常の5段階評価と区別して扱う必要があります。
データ加工の処理をワークフローとして保存しておけば、同じ処理を繰り返し実行できます。
ステップ3:回答分布を集計する
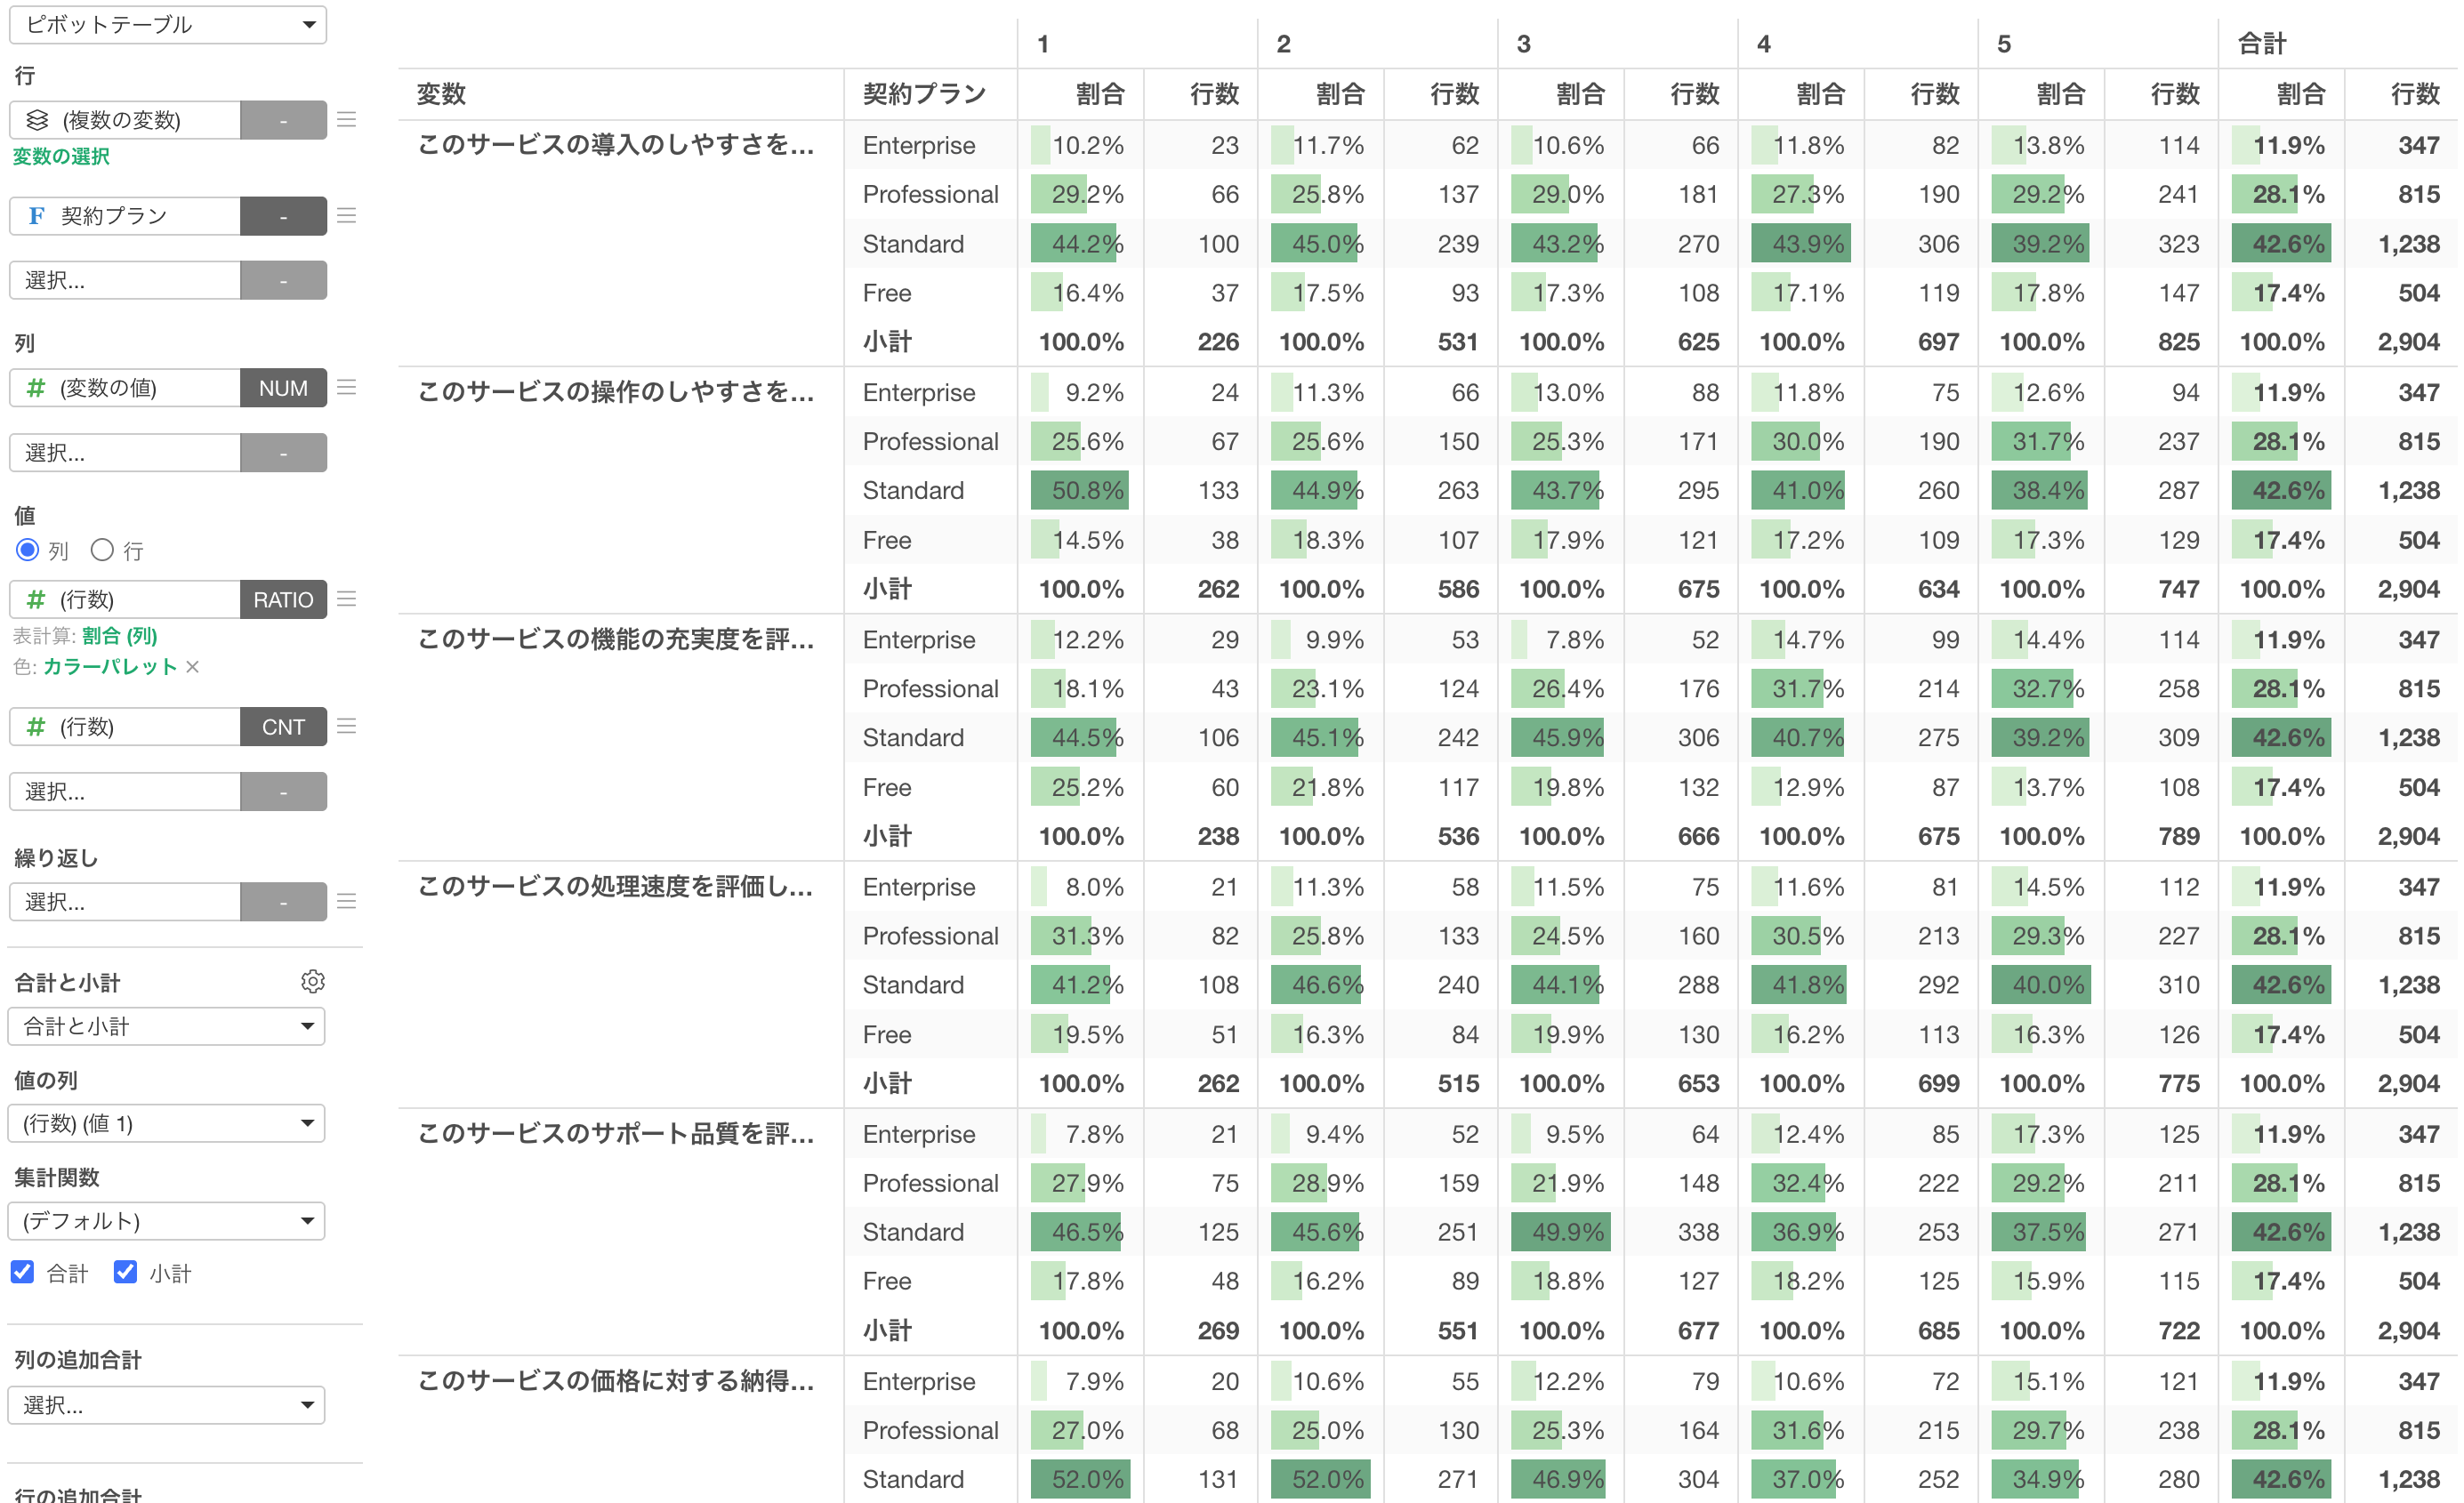
ピボットテーブルを使い、各回答カテゴリの件数や割合を集計します。
これにより、全体の回答傾向を確認できます。
さらに、複数の評価項目をまとめて集計すれば、どの項目が高く評価されているかを比較できます。
ステップ4:Top 2 Box / Bottom 2 Boxを計算する
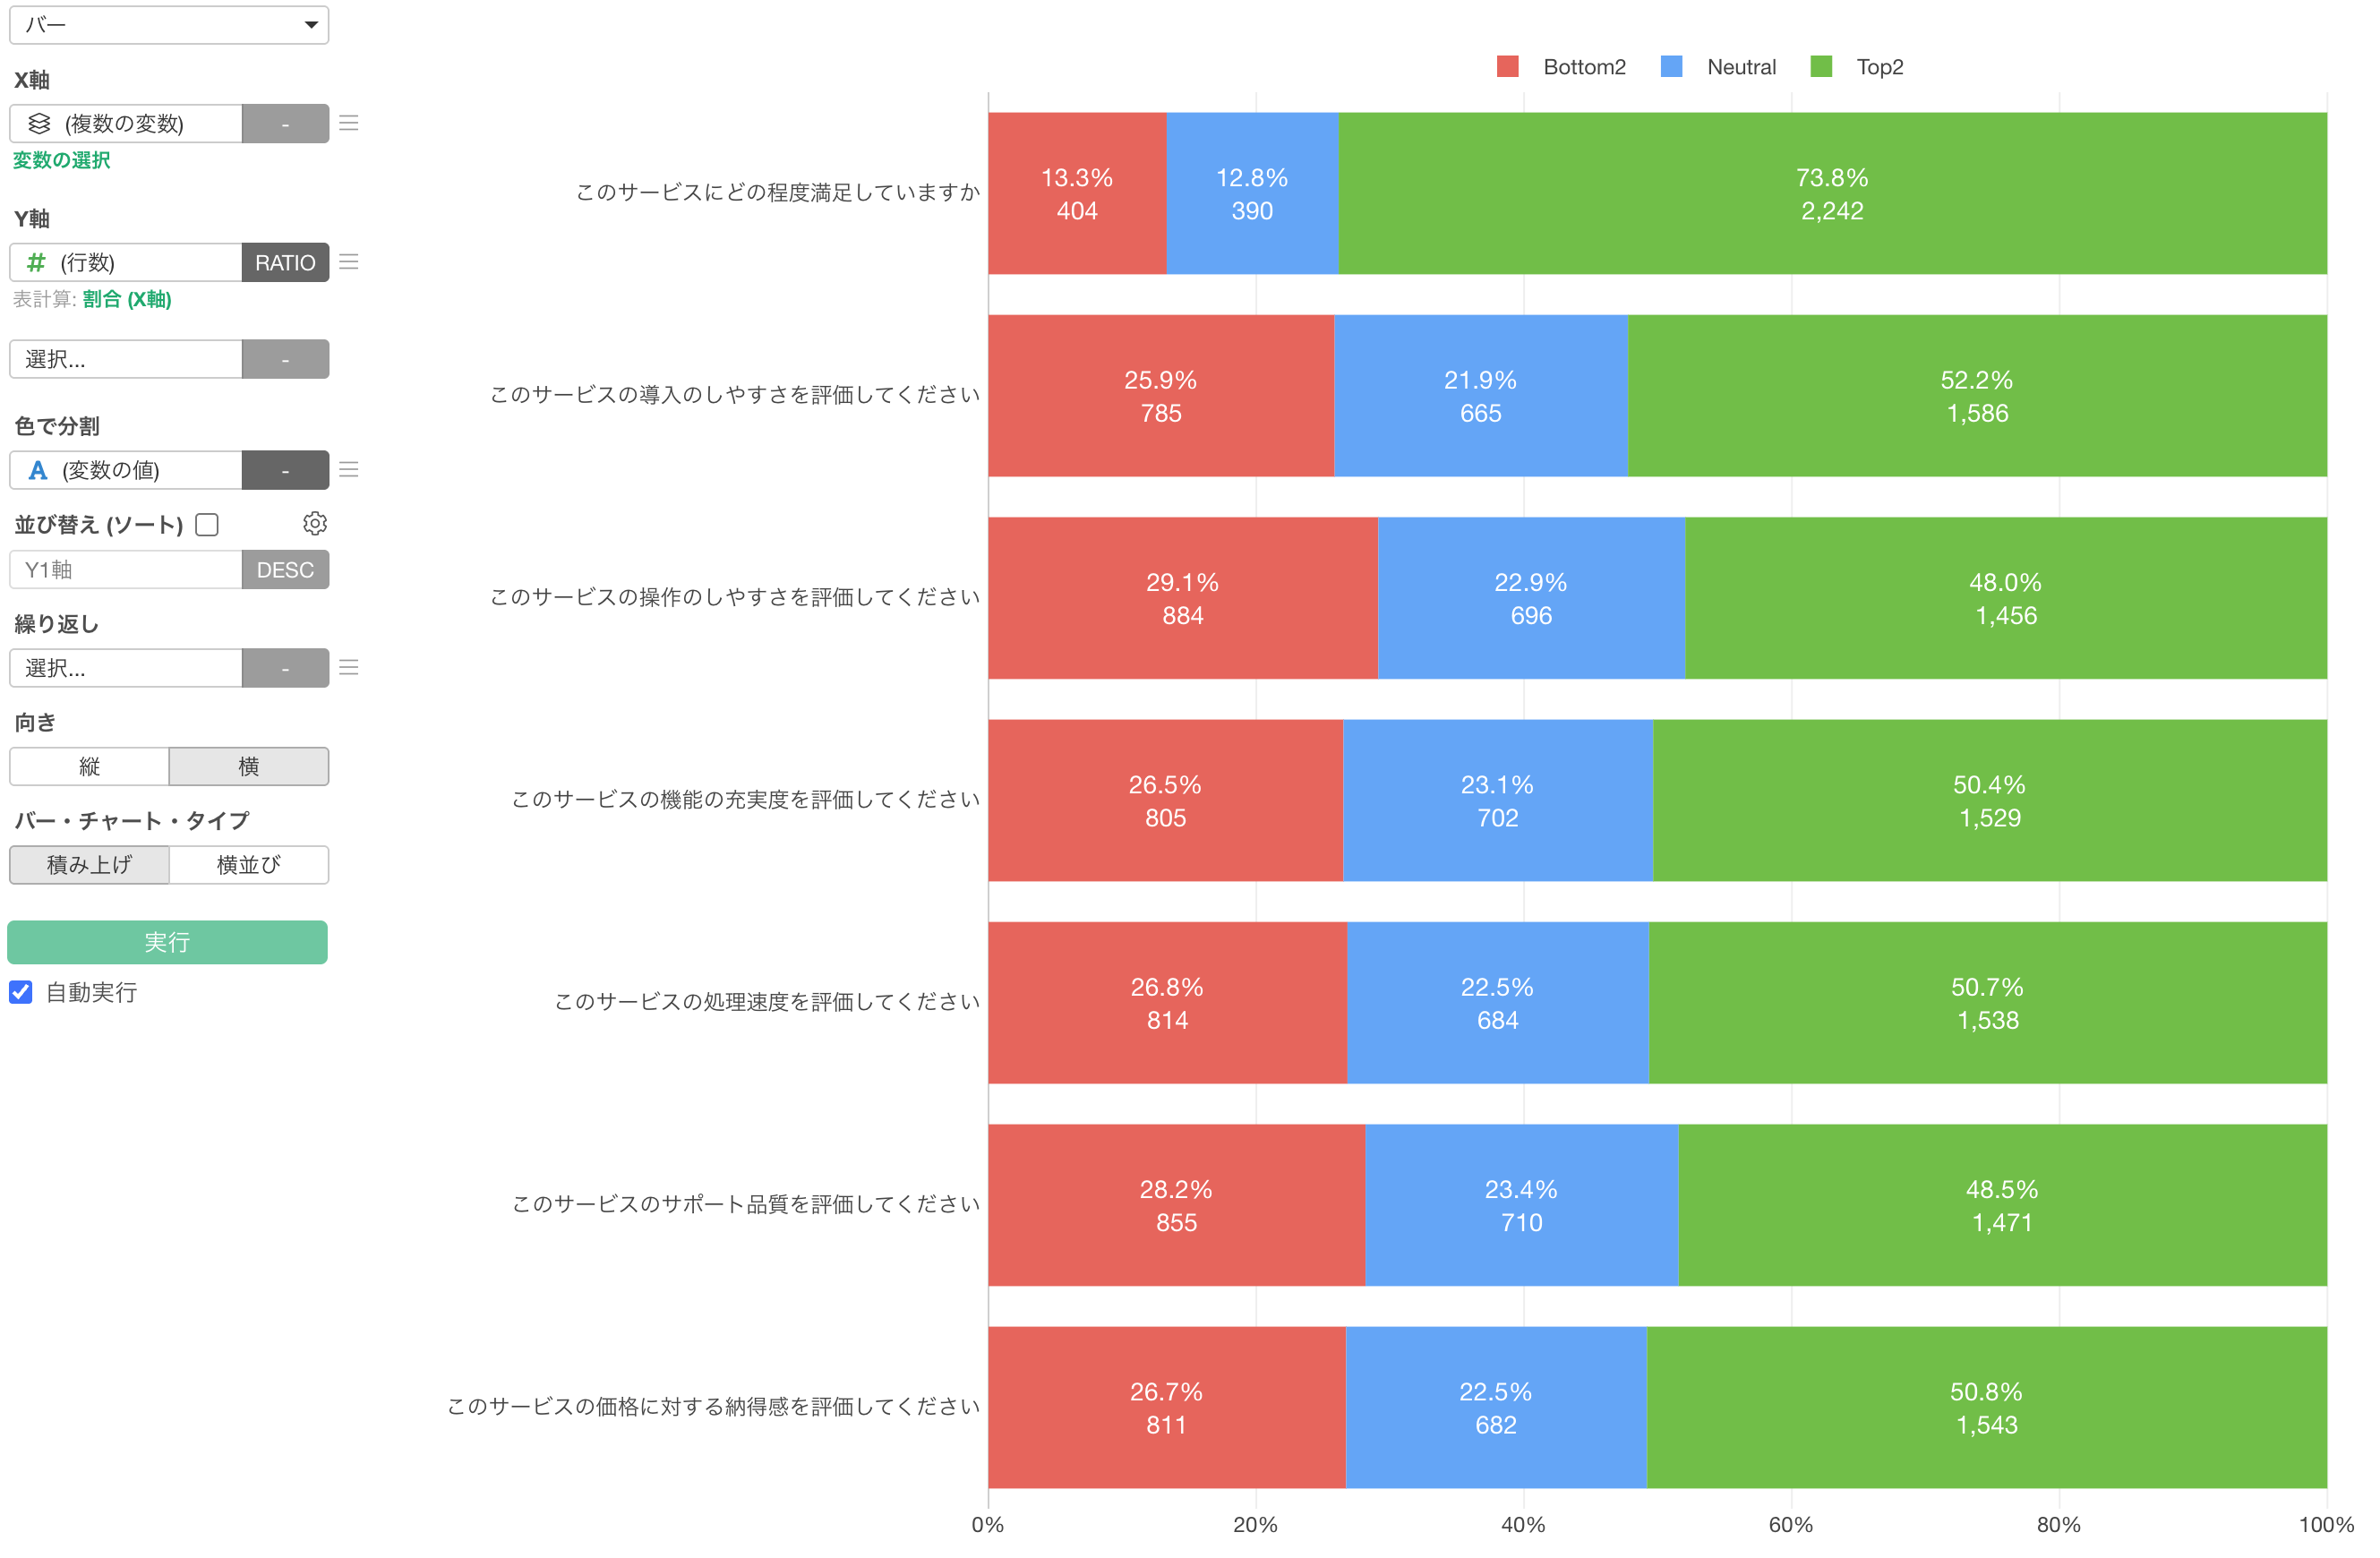
5段階評価の上位2カテゴリと下位2カテゴリをそれぞれまとめ、Top 2 BoxとBottom 2 Boxを計算します。
こうして作成した指標を使えば、満足度の高い回答者の割合を、商品別、顧客セグメント別、調査時点別などに比較できます。
ステップ5:クロス集計で属性別に比較する
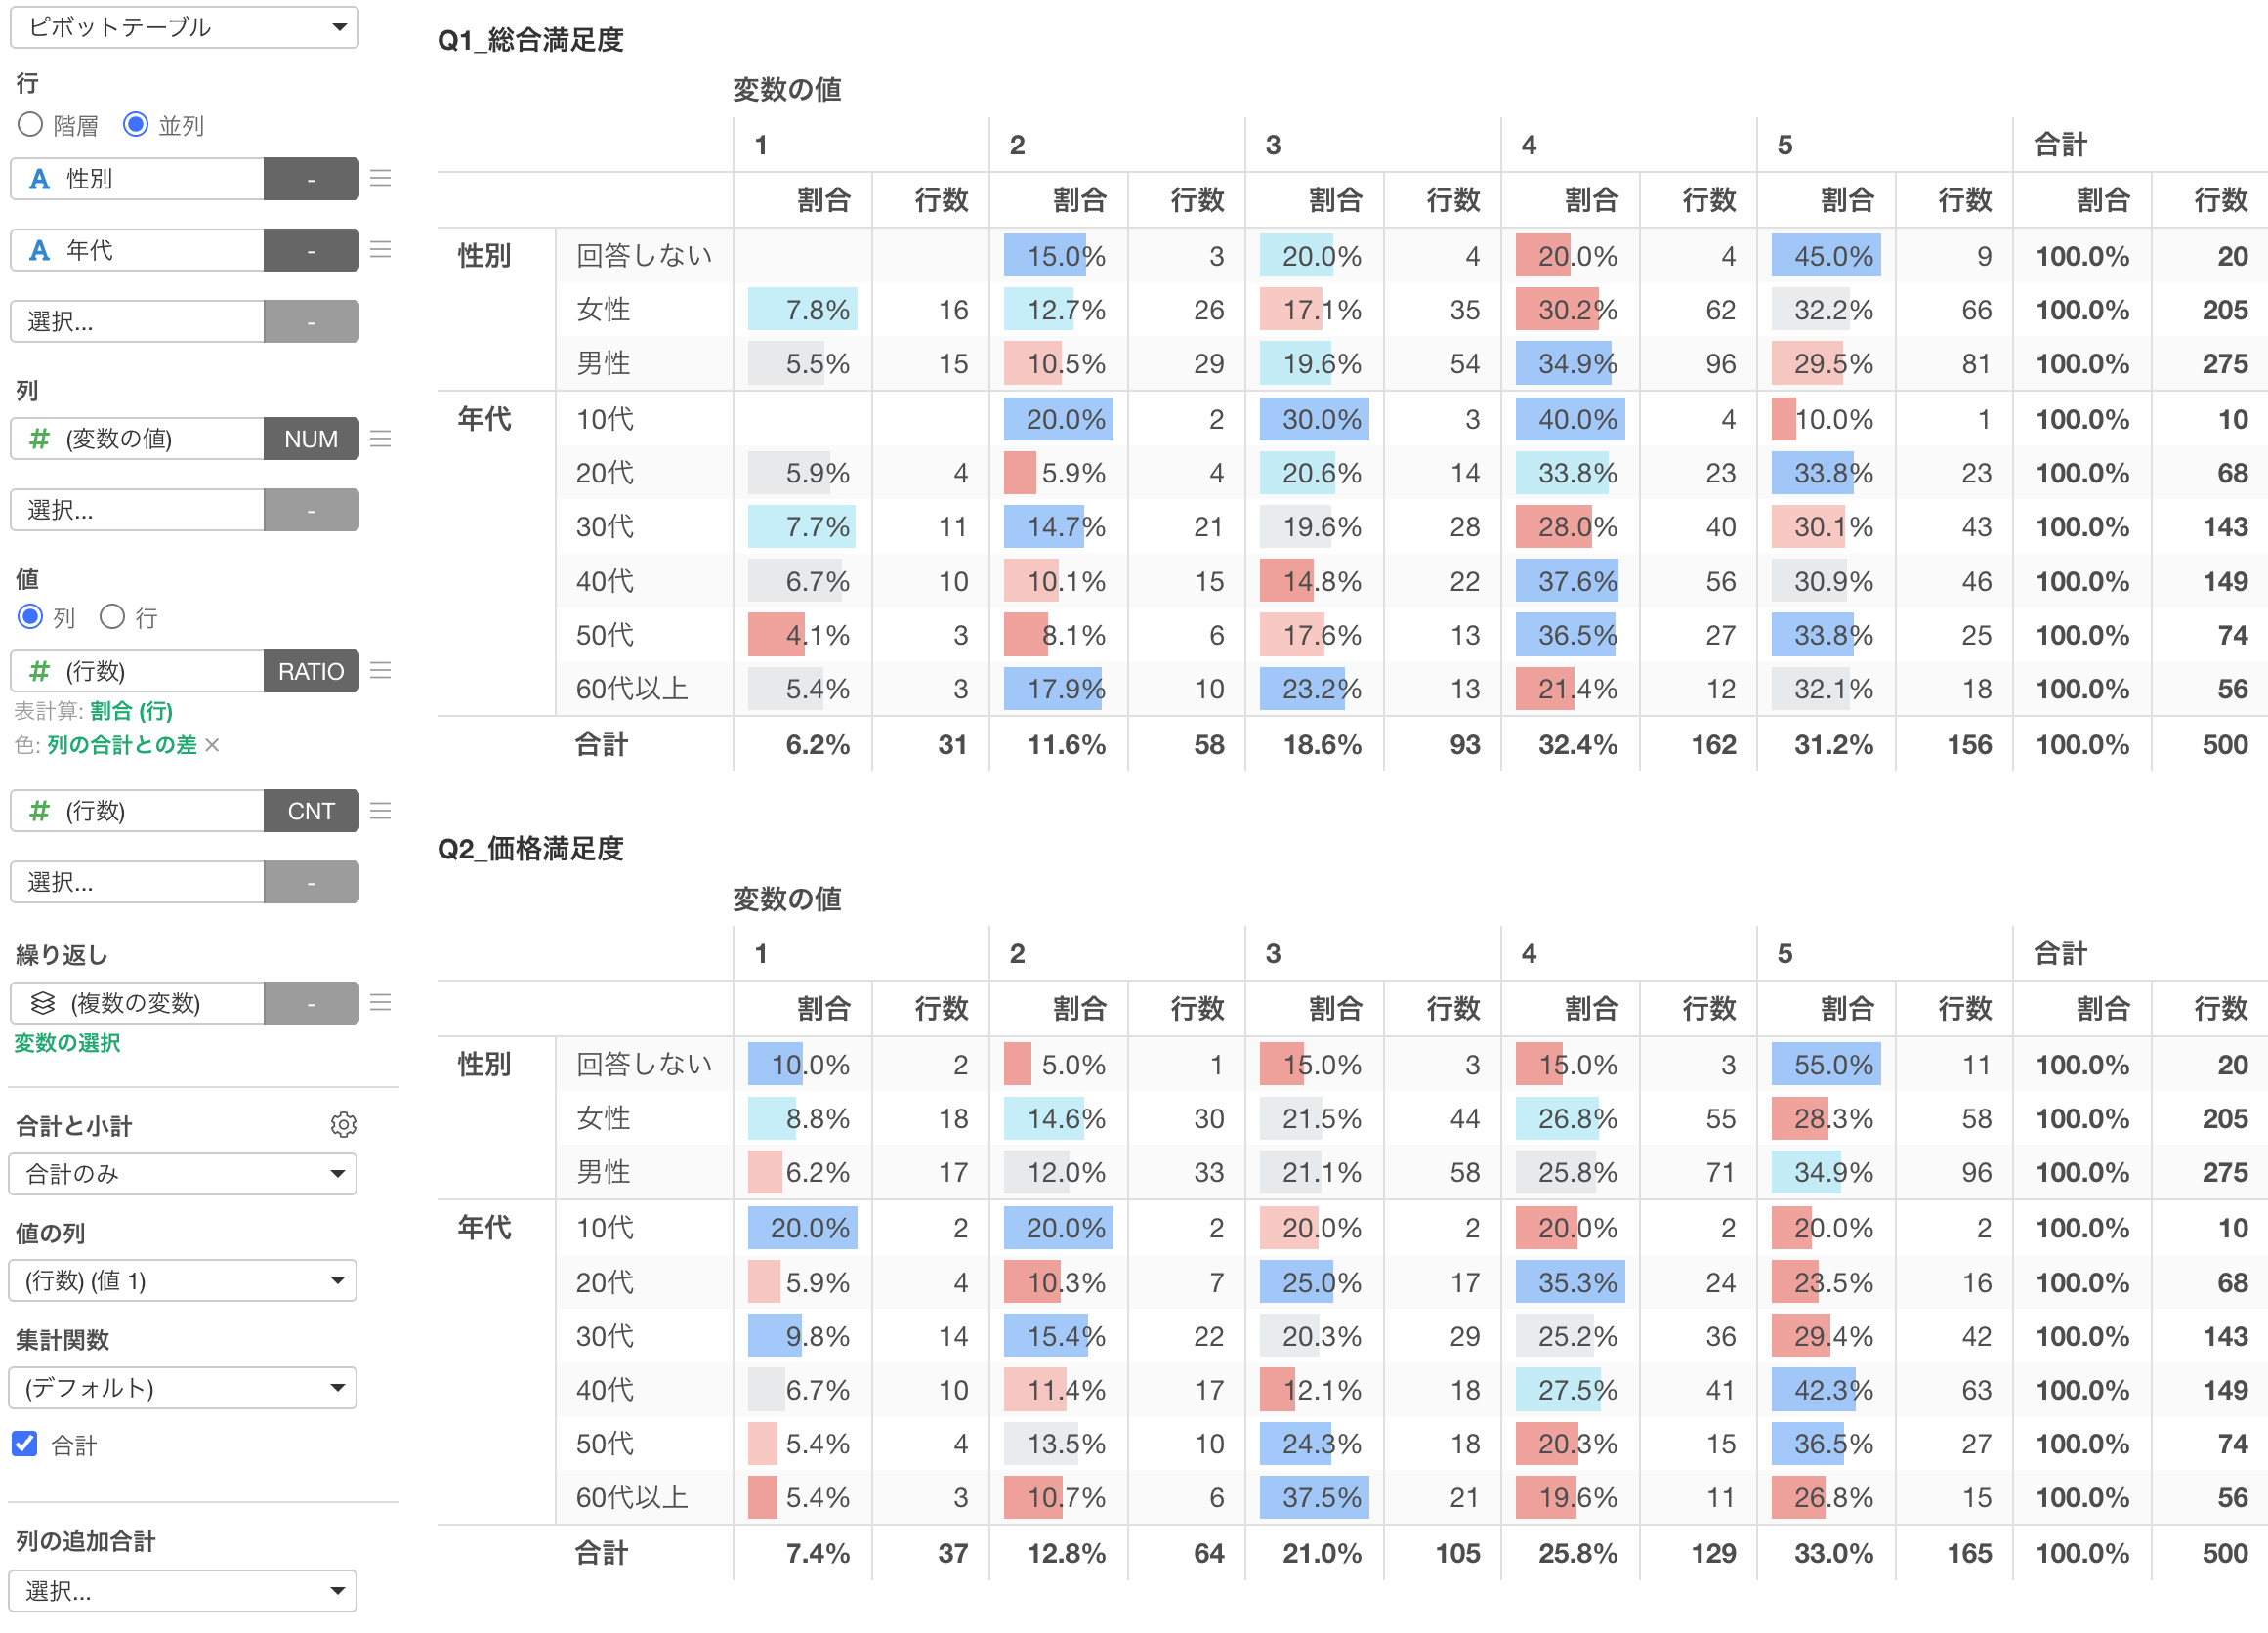
性別や年代などを表頭に設定し、満足度の回答分布やTop 2 Boxをグループ別に比較します。
これにより、全体の集計では見えてこなかった回答傾向の違いを把握できます。
ステップ6:統計検定や多変量解析を行う
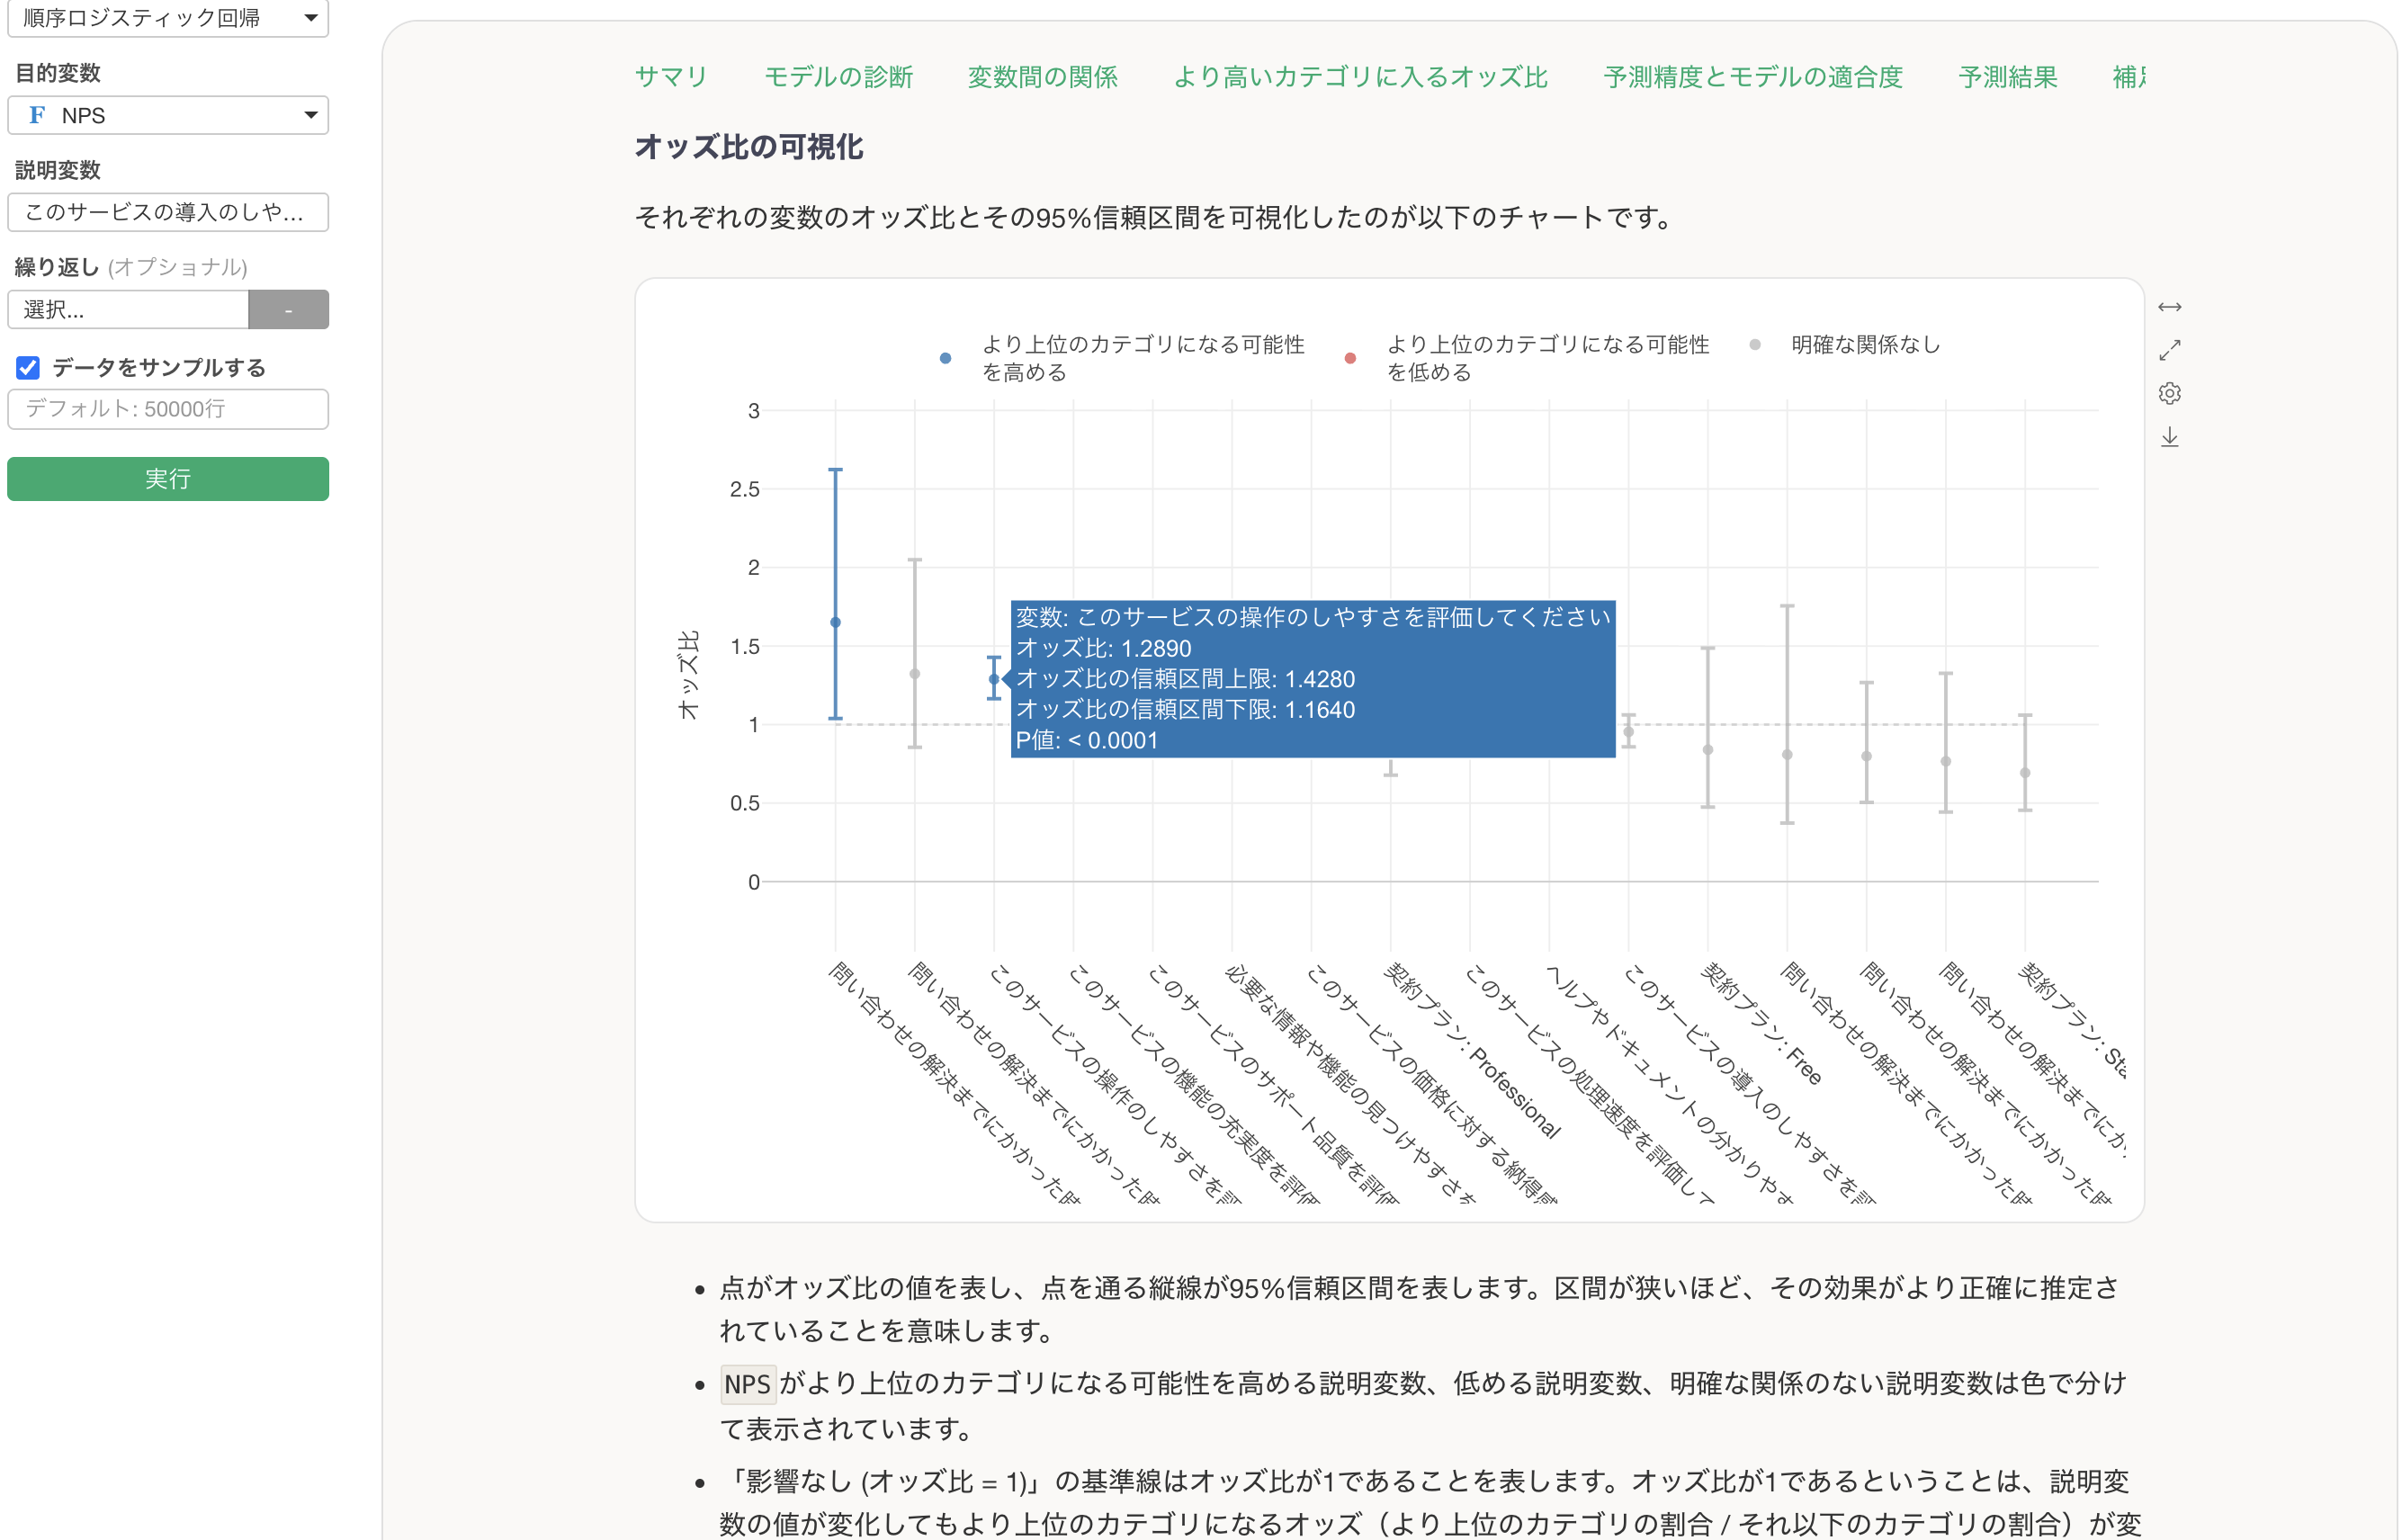
クロス集計で気になる違いが見つかったら、統計検定を使って確認します。
さらに、相関分析や回帰分析によって、各評価項目と総合満足度の関連を調べることもできます。
Exploratoryでは、順序ロジスティック回帰、因子分析、信頼性分析、ポリコリック相関など、アンケートデータに適した分析方法も利用できます。
ステップ7:分析結果をレポートとして共有する
最後に、集計表、チャート、統計分析の結果、考察などをまとめてレポートを作成します。
Exploratoryでは、これらをノートとしてまとめて共有することや、ダッシュボードとしてモニタリングすることができます。
また、データ加工から分析までの手順がワークフローとして保存されるため、新しい調査データが届いた際にも、同じ分析を再実行できます。
これにより、定期的な顧客満足度調査やブランドトラッキング調査などを、再現性のある分析プロセスとして運用できます。
10. リッカート尺度の分析でよくある間違い
リッカート尺度の分析では、結果を誤って解釈しないために、いくつか注意しておきたいポイントがあります。
間違い1:平均値だけで評価を判断する
平均値は便利な指標ですが、回答分布の違いを見落とす可能性があります。
平均値が同じでも、評価が中間に集中している場合と、肯定・否定の両極端に分かれている場合では、意味が異なります。
平均値と合わせて、回答分布やTop 2 Boxなども確認することが重要です。
間違い2:「どちらでもない」と無回答を同じように扱う
「どちらでもない」は、回答者が選択した有効な回答カテゴリです。
一方、無回答や非該当は、回答が得られていない、あるいは質問が対象外だったことを表します。
これらを混同すると、割合や平均値の計算結果が変わってしまいます。
特に、回答割合を計算する際は、どの回答を分母に含めるのかを明確にする必要があります。
間違い3:回答カテゴリの順序を確認しない
文字列として保存された回答は、意図しない順序で表示されることがあります。
また、数値化するときに、高いスコアと低いスコアの向きを逆に設定してしまうと、分析結果の解釈が反対になってしまいます。
分析前に、回答カテゴリの順序と数値の対応を確認することが大切です。
間違い4:サンプルサイズを考慮せずに割合を比較する
例えば、Top 2 Boxが80%のグループがあったとしても、そのグループの回答者が10人なのか1,000人なのかによって、推定の精度は異なります。
割合を比較する際は、各グループの回答者数も合わせて確認しましょう。
また、母集団の構成と回答者の構成に偏りがある場合には、ウェイトバックなどによる調整を検討することもあります。
ただし、ウェイトを使った集計と統計検定では、標本設計やウェイトの扱いに応じた適切な推定方法が必要です。
間違い5:複数の質問をそのまま合計する
複数の5段階評価をまとめて1つのスコアにする場合、それらの質問が同じ概念を測定していることを確認する必要があります。
異なる概念を測定している質問を、理由なく合計してしまうと、解釈が難しいスコアになってしまいます。
信頼性分析や因子分析などを使い、質問間の関係や測定上の妥当性を検討することが重要です。
間違い6:統計的に有意なら、実務的にも重要だと考える
統計的に有意な違いが見つかったとしても、その差がビジネス上重要であるとは限りません。
例えば、非常に大きなサンプルでは、わずかな差でも統計的に有意になる場合があります。
逆に、サンプルが少ない場合には、実務上重要そうな差があっても、統計的な有意性を確認できないことがあります。
結果を解釈する際は、P値だけでなく、差の大きさ、信頼区間、分析の目的なども考慮しましょう。
11. リッカート尺度の分析についてよくある質問(FAQ)
Q1. リッカート尺度は順序尺度ですか?
はい。単一のリッカート形式の質問への回答は、一般に順序尺度として扱われます。
回答には順序がありますが、隣り合う選択肢間の距離が等しいとは限りません。
ただし、複数の質問を組み合わせた合成スコアでは、測定上の前提を確認したうえで、連続的な数値として扱うことがあります。
Q2. 5段階評価の平均値を計算してもよいですか?
実務では広く行われていますが、単一の5段階評価を平均値で要約する場合には、数値間隔を等しいものとして扱っていることに注意が必要です。
平均値だけでは回答分布の違いを捉えられないため、中央値や回答割合、Top 2 Boxなども合わせて確認するとよいでしょう。
Q3. リッカート尺度にはどのグラフが適していますか?
単一の質問の回答分布を確認する場合は、棒グラフがわかりやすい方法です。
複数の質問を比較する場合には、100%積み上げ棒グラフや、肯定的な回答と否定的な回答を左右に分ける発散型積み上げ棒グラフが役立ちます。
Q4. リッカート尺度のグループ比較には、どの統計検定を使いますか?
比較したい対象によって異なります。
回答分布全体を比較したい場合はカイ二乗検定、Top 2 Boxなどの割合を比較したい場合は比率の検定、回答の順序を考慮した2グループ比較ではMann–Whitney U検定などが候補になります。
平均値を比較する場合は、数値化の妥当性や統計的な前提を確認したうえで、t検定などを利用することもあります。
Q5. リッカート尺度に相関分析や回帰分析を使えますか?
はい。ただし、データの性質に適した方法を選ぶ必要があります。
順序データ同士の関連を調べる場合には、Spearmanの順位相関やポリコリック相関などが候補になります。
また、順序のある回答カテゴリを目的変数とする場合には、順序ロジスティック回帰などを利用できます。
Q6. 5段階評価と7段階評価では分析方法が違いますか?
基本的な分析方法は共通しています。
どちらも回答カテゴリに順序があるため、回答分布、割合、中央値、クロス集計、順位に基づく検定などを使うことができます。
ただし、回答カテゴリの数が異なるため、平均値やTop 2 Boxなどを直接比較する場合は注意が必要です。
Q7. Top 2 Boxとは何ですか?
Top 2 Boxとは、評価尺度の中で最も高い2つの回答カテゴリを選んだ人の割合です。
例えば、5段階の満足度評価であれば、「非常に満足」と「やや満足」の割合を合計します。
顧客満足度やブランド評価などで、肯定的な評価をしている人の割合を把握するためによく使われます。
Q8. 複数のリッカート尺度の質問を合計してもよいですか?
複数の質問が同じ概念を測定している場合には、それらを合計または平均して尺度スコアを作成することがあります。
ただし、単純に合計するのではなく、質問内容、逆転項目の有無、信頼性分析、因子分析などを通して、合成することの妥当性を確認する必要があります。
12. まとめ:目的に応じて適切な分析方法を選ぶ
リッカート尺度は、顧客満足度やブランド評価、従業員の意識などを測定するために、幅広く使われています。
そして、リッカート尺度のデータから得られる情報は、単なる平均値や回答割合だけではありません。
まず、回答分布、中央値、平均値、Top 2 Boxなどを使うことで、全体の評価傾向を把握できます。
次に、クロス集計や統計検定を使うことで、性別、年代、顧客セグメントなどによる回答の違いを調べられます。
さらに、相関分析や回帰分析、因子分析などを利用すれば、評価項目同士の関係や、回答の背後にある潜在的な要因を理解することもできます。
重要なのは、「何を知りたいのか」という分析の目的と、リッカート尺度のデータとしての性質を理解したうえで、適切な分析方法を選ぶことです。
また、アンケート分析では、こうした分析を一度だけ行うのではなく、調査のたびに同じ方法で集計・比較・報告することも少なくありません。
そのため、データの準備から分析、レポート作成までの手順を再現可能なワークフローとして管理することが重要になります。
Exploratoryでは、CSVやExcel形式のアンケートデータの読み込みから、Top 2 Box、クロス集計、統計分析、因子分析、レポート作成までを、1つの分析ワークフローとして実行できます。
アンケートデータの分析を効率化し、さらに深いインサイトを得たい方は、ぜひExploratoryのアンケートデータ分析機能をご覧ください。